Terminal-RSI 讓終端機代理循環改寫策略

Terminal-RSI 透過成功軌跡反覆改寫與微調策略,提升模型完成終端機任務的能力。

Og image

終端機代理面對複雜指令時,往往不是完全不懂,而是在多輪操作中逐步偏離正確路徑。Terminal-RSI 是一項研究項目,利用驗證成功的 terminal trajectories,讓 27B 參數模型反覆修正自身行為,減少同類任務重犯錯誤的情況。

項目把 Recursive Self-Rewrite 與 Policy-Refine 分成兩條互相配合的流程。模型先透過不同 harness 產生操作軌跡,再由 terminal verifier 篩走失敗結果;成功軌跡會交給 actor 進行 SFT,critic 則保留並重新校準,之後再以 actor–critic PPO 一同優化政策。

它採用 TB-GAE(Turn-Based Generalized Advantage Estimation)追蹤生成 token 的責任,觀察內容留在上下文中,信用分配則沿着每輪操作向後傳遞。完成一輪後,保留的 checkpoint 會成為下一輪遞歸改進的起點,而非每次都由零開始訓練。

測試結果顯示,Terminal-Bench 4.0 的分數由 0.00% 升至 19.84%,Terminal-Bench 2.1 則由 51.70% 升至 86.52%,分別提升 19.84 個百分點及 34.82 個百分點。兩個基準版本的任務與難度不同,數字較適合用來觀察各自的改進幅度,不能直接當作同一條排行榜比較。

  • 只保留通過 verifier 的成功軌跡
  • 以 Recursive Self-Rewrite 改寫可重用的操作經驗
  • 以 Policy-Refine 持續調整 actor–critic 政策
  • Terminal-RSI-27B 是目前展示的最終 checkpoint
  • Code 與 model 仍標示為即將推出

對需要模型執行檔案處理、程式編輯或多步驟 shell 任務的工作流,這種訓練方式提供了另一條提升可靠性的方向。不過項目仍處於研究展示階段,代碼及模型尚未公開,結果亦主要集中於指定的 Terminal-Bench 評測。
項目主頁

Categories: 開源, 騰訊, Agentic, 模型

[技術文章] 阿里 CommerceGen-Studio:商用級主圖生成端到端框架

把白底 SKU 商品照變成可上架主圖,並以幾秒延遲處理每日百萬級流量。

Hugging Face

白底商品照難以直接吸引搜尋頁點擊,CommerceGen-Studio 由 Alibaba Group 提出,面向電商 SKU 粒度的商業主圖生成。來源沒有交代具體 base model 或 fine-tuned from 哪個模型,因此無法確認其原始基礎模型。

系統分成資訊抽取、語義改寫及多條件生成三階段。Prompt-Eval-Refine-Loop Agent(PERL-Agent)讓 VLM 與 LLM 按照 reference-free rubric 反覆整理商品資料;Layout Thinker Optimization(LTO)則同時以文字描述及渲染圖片質素調整改寫策略。

SKU-DiT 透過 Reinforce-Distill-Reinforce(RDR)漸進式訓練,聯合使用白底商品圖、商標裁剪圖及結構化版面條件,兼顧商品外觀、商標完整性和字元級文字準確度。系統聲稱已達到每日生成數百萬張主圖、每張延遲數秒,並在 CommerceGen-Bench 的兩條編輯測試中勝過所比較的開源基線,部分指標可媲美或超越大型閉源模型。

  • 檔案與推論:來源是研究論文內容,沒有提供 GGUF 檔名、檔案大小、量化級別、mmproj 或 chat template。
  • 框架支援:論文摘要沒有公開各項數值分數,也未交代 SKU-DiT 的參數規模及訓練資料細節。
  • 適用場景:重點在大量電商商品主圖生產,而非通用文字轉圖片服務。

CommerceGen-Studio 與單一生成模型的差異,在於把商品資料理解、賣點整理、版面規劃及圖片生成串成完整項目流程;CommerceGen-Bench 則以真實流量中的困難案例測試 Instruction Following 和 Product Integration。由於缺乏公開權重、量化檔案及硬體規格,讀者目前較適合把它視為可大規模運行的研究框架,而非可直接下載的本地模型。

Paper

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 模型訓練, Image, 影像模型, VLA, 框架, LLaMa, Ollama, Dataset 數據集

3dcodeverse 讓 AI 以程式碼建立可驗證 3D 世界

3DCodeVerse 將可執行程式、空間檢查與視覺評審接成工作流,讓 AI 產生的 3D 內容不止能看,亦能修改和驗證。

3DCodeVerse

由幾百行 Blender Python、Three.js 或 GLSL 生成互動場景,內容仍可編輯和檢查,正是 3DCodeVerse 的實用定位。它屬於面向 coding agents 的 3D 研究生態系,處理文字要求轉化為可執行 3D 程式的問題,而不是只輸出一張渲染圖。

核心資料集 3DCodeVerse-2M 收錄約 2.03M 個 code-condition pairs,來自 269,597 個可執行程式,涵蓋 bpy、CadQuery、OpenSCAD、Three.js、URDF、GLSL、OpenGL 七種語言或 runtime,並分為物件、可動物件、場景及圖形渲染四條軌道。每個項目附有程式、所需資產、指令描述、視覺描述、建構步驟和驗證記錄,較適合訓練及測試,而非只作展示素材。

3DCodeVerse Harness 以多智能體和 DAG 結構規劃 3D 項目,再交由空間工具、MCP 服務及確定性檢查驗證連接、介面合約、關節掃描和畫面指標;VLM 評審則用二元缺陷清單及程式上限評分。讀者可先在項目網站瀏覽器執行示例,再從 Hugging Face 取得資料集;自行運行則要準備相應的 Blender、Three.js、OpenGL 等 runtime,不能只靠單一推理套件完成。

開放模型部分提供 Qwen 的 LoRA、DPO 微調配方,並列出 27B 模型在 3DCodeBench 的執行率由 51.9% 提升至 92.9%;項目亦列出相對同一 Claude Opus 5.5 backbone 的 90% 人類偏好結果。這些數字反映訓練資料和驗證流程的價值,但仍應留意評測設定、成本及不同 runtime 對結果的影響。

  • 可生成可修改的程式化 3D 物件、場景和渲染效果
  • 以 DAG Harness 串連規劃、執行、空間檢查和視覺評審
  • 2.03M code-condition pairs 支援模型訓練與基準測試
  • Qwen 微調配方兼顧執行成功率和偏好評審

對研究 3D 生成、coding agents、程式化建模或模型微調的團隊,這個項目提供由資料集、工具鏈到模型配方的完整起點。限制在於工作流程依賴多個 3D runtime,評審仍可能受視覺品質和規則覆蓋範圍影響。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 視覺模型, 模型訓練, Qwen, Google, 工具, 3D, Python, 編程, 安全, Anthropic, Dataset 數據集, LoRA

EdgeWise 讓長流程 AI 代理在本地運作更省成本

EdgeWise 讓本地模型處理大部分長流程任務,只在關鍵步驟呼叫雲端 LLM,兼顧表現與成本。

Og image

長流程 AI 代理不必每一步都依賴昂貴的雲端模型。NVIDIA 的 EdgeWise 是一套 edge-cloud collaboration framework,讓本地 SLM(Small Language Model)先負責解題,遇到需要更強推理能力的關鍵步驟,才選擇性地交由 cloud LLM 處理。

EdgeWise 用 step-level RL(Reinforcement Learning)同時訓練任務執行與自動分工,令代理自行判斷何時需要外援,而且不必在推理階段額外加入另一個決策模型。研究亦以 external judge-based delegation strategy 分析委派時機、分享多少上下文,以及雲端模型應該多久介入一次。

研究發現,雲端智慧需求通常集中在少數關鍵步驟,呼叫次數不一定越多越好;隨機把約 40% 步驟交給雲端,有時已能接近全雲端執行的表現。EdgeWise 在 SWE-Rebench 減少最多 62% inference cost,在 Terminal-Bench 2.1 減少最多 34%,並在本地工作站完成 edge-cloud 測試。

• 本地 SLM 負責主要任務流程
• 只在關鍵步驟委派 cloud LLM
• 以 step-level RL 學習委派決策
• 支援不同 agent harnesses
• 成本較全雲端執行最多低 62%

適合需要處理長流程編程、終端機操作或其他多步驟任務的工作流,尤其適合希望降低 inference cost、又不想完全犧牲模型能力的本地設備。雲端連線、委派判斷和上下文分享方式仍會影響結果,因此它並非完全脫離雲端的方案。

項目主頁

Categories: Agentic, 模型, 模型訓練, NVIDIA, World-Action Model, 框架, 編程, 強化學習

ORBIA 測試世界模型當鏡頭回頭後場景是否仍在

影片流暢,不代表場景能保持一致。ORBIA 讓鏡頭離開再折返,檢查世界模型有沒有「忘記」剛生成的內容。

ORBIA overview

鏡頭繞一圈後,同一件物件應該仍在原位。ORBIA 這套互動影片世界模型基準測試,透過探索與重訪場景,檢查生成畫面能否構成一致的 3D 世界,而不只看影片是否漂亮。

測試輸入包括圖片、場景描述及鏡頭軌跡,並以已對齊的彩色與深度影像(Red Green Blue–Depth,RGB-D)及標註物件作參照,比單一整體影像分數更能定位場景改變的位置。

  • 輸入保留(input preservation):原有場景與地標是否保留。
  • 生成內容持續性(generated-content persistence):重訪時,新生成內容是否一致。
  • 3D 自洽性(3D self-consistency):不同視角能否支持同一個 3D 重建。

儲存庫提供評估程式、模型適配器及資料建構流程,供研究團隊接入模型測試。720 個案例涵蓋六種軌跡,包含 22 秒及一分鐘版本;長版本安排三次重訪,能檢查較長時間的場景記憶。

項目已評估 27 個模型,但所提供資料沒有具體排名或分數。它適合補強世界模型的驗證流程,不能單憑測試規模判斷哪個模型更可靠。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, Video, Image, 3D, 庫, Dataset 數據集

[技術文章] TextVerifier 補上中文生成文字的結構缺口

生成中文字,常見會多一劃或少一筆;TextVerifier 專門找出這類 OCR 容易漏掉的錯誤。

Hero image preview

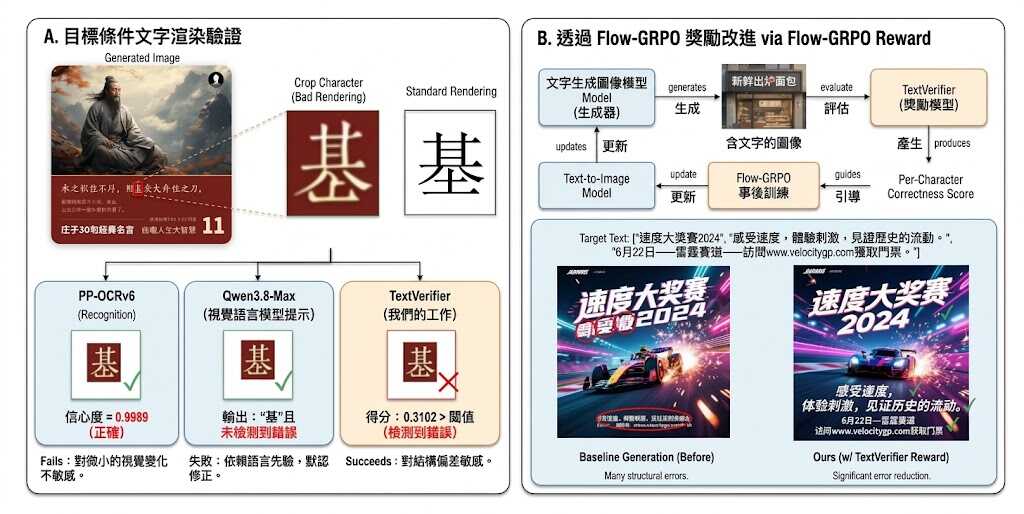
生成圖片中的中文句子看似正確,單一字元卻可能多一劃、少一筆或部件變形,令出版、教育等不能出錯的場景無法採用。TextVerifier 把問題定義為有目標條件的文字渲染驗證:給定指定字元與圖片裁剪區,判斷兩者是否真正一致。

現有做法通常重用 OCR 或一般 vision-language models(VLM)評分。這些模型以辨認內容為目標,會刻意忽略字型、模糊和結構變化;中文錯字往往仍能被讀成原本字元,反而令最關鍵的筆畫及部件錯誤被放過。TextVerifier 改用字元的 Ideographic Description Sequence(IDS)作為文字端輸入,讓模型比較目標字的結構,而不只辨認符號。

訓練資料包括 1,270 萬組 crop–IDS 配對,以及從文字區域 inpainting 模型訓練過程抽取的「同字不同質素」hard pairs。團隊亦建立 TEXTRENDERBENCH-ZH,逐字標註位置、身份與正確性,涵蓋 7,358 個生成中文字元。

• TextVerifier F1 為 0.844,高於 OCR confidence 的 0.526、一般 VLM 的 0.329 及 TextPecker 的 0.590。
• 驗證單位由整段文字下沉至單一字元,能捕捉局部筆畫與部件錯誤。
• 分數可用作 Flow-GRPO post-training 的 per-character reward,協助生成模型減少渲染錯誤。
• 適合需要逐字校驗的海報、教材、出版物及其他中文圖像生成工作流。

結果顯示,文字辨認和文字正確性驗證並不是同一項能力。TextVerifier 目前聚焦中文字符結構,對需要零錯誤輸出的場景更有針對性,但其成效仍取決於生成模型、字體風格及圖片品質。

Paper

Categories: 北京大學, 阿里巴巴, Image, 中國, Dataset 數據集

Gemini 4 Argon 解決更複雜問題

Gemini 4 Argon 正式向開發者、企業、科研人員及一般用戶開放,主打處理高難度問題。

Og image

面對需要更強分析能力的工作,Google 現已開放 Gemini 4 Argon 使用。這款 frontier model 面向開發者、企業、科學家及一般消費者,讓不同場景的用戶都能接觸 Google 最新一代 Gemini 模型。

Gemini 4 Argon 定位為處理「最艱難問題」的模型。

主要亮點

  • 原生多模態 MoE:支援文字、圖片、音訊及影片輸入。
  • 統一 1M-token 視窗:輸入、thinking tokens 與輸出共用約 104 萬 tokens,單次輸出亦可超過以往的 64K 限制。
  • 可調推理深度:API 提供 low、medium、high thinking levels,方便平衡速度、成本與解題能力。
  • 偏向深度工程工作:Google 展示了跨數百個檔案重構,以及讓 Agent 無人值守執行整晚的案例。
  • API 型號:gemini-4-argon,可透過 Gemini API、Google AI Studio 及 Google Antigravity 使用。

價格與限制

2026 年 11 月 30 日前,API 推廣價為每百萬 input tokens 2 美元、output tokens(包括 thinking tokens)10 美元;12 月 1 日起分別加至 4 美元及 20 美元,而且沒有免費 API tier。

項目主頁

Categories: 模型, Google, Gemini, 安全

Doc2Harness:測試模型能否造出真正可用的 Coding Agent

Doc2Harness 不只測模型識唔識寫程式,還把整套 Coding Agent harness 交由模型建造,再以黑盒方式驗證是否真的運作。

Doc2Harness

當 Coding Agent 要處理長時間、多步驟工作,成敗不只取決於模型本身,還取決於工具呼叫、權限、工作階段、復原流程和整個執行迴圈。Doc2Harness 是一個評測基準,專門處理模型能否按照開發文件和介面骨架,建造完整 Coding Agent harness 的問題。

項目分成兩個階段:第一階段由 build model 在隔離容器內透過 OpenCode 實作 harness;第二階段會凍結成果,再放到另一個容器,由 scripted mock model 端到端驅動。評分不接受 harness 自己聲稱完成任務,而是讀取四個可觀察渠道:傳給模型的請求、磁碟檔案、程序 exit code,以及 command output;positive controls 亦會阻止空殼實作取得通過結果。

  • 測試範圍:完整基準包含 328 個 test cases,公開儲存庫只提供 94 個 scenarios,包括 53 個評分案例和 41 個 positive controls。
  • 模型差距:完整套件涵蓋 19 個 frontier models,最佳模型通過率為 53.05%,最低約 27.4%。
  • 可重現限制:排行榜數字來自完整套件,不能只用公開子集重現。
  • 執行條件:需要 Python 3.11+、Docker,依賴採用 Python standard library;完整 catalog 在 concurrency 12 下約需 25 至 90 秒。

這項目直接把 harness engineering 本身納入評測。結果亦反映模組拆分並非必然帶來好處:在控制程式碼大小後,module count 與通過率呈負相關,相關係數為 -0.423;同一模型在 direct drive 和 permissions 等場景的排名也可能大幅變動,顯示權限及工具編排是獨立而關鍵的能力。

Doc2Harness 適合研究 Coding Agent、模型評測和 agent infrastructure 的團隊,用來比較模型建造長流程工具系統的能力,亦可協助定位 harness 在請求流程、檔案操作、程序控制或復原機制上的失敗位置。

項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, Agentic, 模型, Vibe Coding, 工具, Python, 庫, 編程, Anthropic, Dataset 數據集

ATAS 以持續世界記憶改善長片生成一致性

ATAS 讓每個鏡頭共享可回訪的世界狀態,減少長片生成中人物、場景與事件難以保持連貫的問題。

ATAS: Any Time, Any Space

長片生成最難處理的不是單一鏡頭是否漂亮,而是角色重返同一地點、事件在不同時間再次出現時,畫面能否維持一致。ATAS(Any Time, Any Space)屬於 agentic video generation 框架,將劇本拆成包含場景、鏡頭、時間及事件的 shot request,再以持續更新的世界狀態支援後續生成。

ATAS 沒有只把上一個鏡頭或提示詞傳給下一次生成,而是分開保存兩類記憶:Scene Memory 記錄已註冊的靜態幾何,Event Memory 則按場景、事件和時間索引動態觀察。新片段生成後會被重建、註冊及檢查,只有通過審核和狀態驗證的內容才會更新記憶;影片交付則不受記憶是否接納影響,減少錯誤觀察污染後續鏡頭的風險。

• 將劇本編譯成具體的場景、相機和事件時間要求
• 支援從不同視角回訪同一場景
• 可重現較早時間點發生過的事件
• 生成後進行註冊、審核及世界狀態檢查

項目展示的差異,在於把跨鏡頭一致性視為世界狀態管理問題,而不是單純延長上下文或串接最近畫面。這會增加記憶建立、片段重建和驗證所需的計算與流程複雜度,但更適合長片、分段製作及需要角色與場景持續連貫的內容工作流。

研究結果涵蓋四個影片生成器;ATAS 在報告的跨鏡頭一致性指標均有改善,並在每個 backbone 取得最高綜合 benchmark 分數。它亦在目標影像空間回訪、三項事件重現指標及六項人工評分準則中領先比較的 agents 和 3D-guided methods。儲存庫目前主要提供研究程式碼、技術資料及示範,使用者需要按項目頁面的環境與模型依賴自行重現流程。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 視頻模型, Video, Image, World-Action Model, 提示詞, 框架, 3D, 庫, Dataset 數據集

LSCBench 揭示 AI 編程代理安全盲點

LSCBench 以不提安全的真實漏洞重建任務測試編程代理,結果顯示能正常運作與同時安全的程式碼仍有明顯距離。

Qwen

當編程代理只收到功能規格、完全沒有被提醒要處理安全問題時,能否自行避開已知漏洞?Last Secure Code Benchmark(LSCBench)正是用來回答這個問題的開源基準測試項目:它從真實項目移除曾經包含漏洞的程式碼,再要求代理按規格重建,最後以功能測試及重現原有攻擊的安全測試共同評分。

LSCBench 共設 450 個任務,涵蓋 150 個漏洞情境,包括 115 個 Common Vulnerabilities and Exposures(CVE)案例及 35 個專家編寫的 Java 應用程式,支援 C、C++、Go、Java、JavaScript、PHP 和 Python。每個情境分成 function、file 及 repo 三種粒度,分別測試代理修補最小函式、相關檔案,以及較完整程式庫的能力。

六個模型在 450 個任務中大多能產生可運作程式碼,但同時通過功能和安全測試的比例最高只有 25.1%。Claude Fable 5 配合 Claude Code 取得最高 Func∧Sec 比例,GPT-5.6-Sol 的安全測試通過率則以 25.8% 稍高;Kimi-K3 雖然功能通過率達 91.3%,兩項測試同時通過的比例只有 16.4%,反映功能完成度與安全性並非同一件事。

  • 測試焦點:編程代理沒有收到安全提示,必須自行辨認風險。
  • 評分方式:功能測試確認程式可運作,安全測試重播原有攻擊。
  • 資料範圍:450 個任務、150 個漏洞情境、7 種程式語言。
  • 粒度差異:同一情境會在 function、file、repo 三個層次出現。

LSCBench 屬於面向 Computer-use agents(CUAs)及 coding agents 的安全基準測試,實際解決的是「生成的程式碼能否在沒有安全提示下仍然避免已知漏洞」這個評估缺口。對模型開發團隊、安全工程師及採用 AI 輔助編程的團隊而言,項目提供了比單看功能通過率更接近真實風險的檢查方式;不過,測試結果只涵蓋指定漏洞與攻擊重現流程,不能取代完整 code review、模糊測試及正式安全審計。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, Qwen, OpenAI, DeepSeek, Python, 庫, 編程, 安全, Anthropic, Dataset 數據集, Kimi

Page 12 of 183
1 … 10 11 12 13 14 … 183