CWM (Code World Model) 32B – Meta 開源編程模型

Meta FAIR 的「Code World Model (CWM)」是一個 32B 參數、專門為「帶世界模型的程式碼生成研究」設計的開放權重 LLM。它的關鍵點是:不只學 code syntax,而是透過大量「執行軌跡」去內化程式執行對系統狀態的影響,並在多任務 RL 下強化 agentic coding 能力。 CWM 是什麼? 訓練流程與 world modeling 設計 CWM 的訓練 pipeline 不是單純「pretrain → SFT」,而是刻意插入 world‑model mid‑training,再加上多任務 RL: 這種設計的重點是:讓 RL 是「從已經具備世界模型的基底」開始,而不是只在純 token LLM 上做 RL,理論上比較容易學到長程規劃與工具使用策略。 模型架構與上下文長度 基準測試成績 在多個開源 benchmark 上,CWM 以 32B 級別達到非常有競爭力甚至 SOTA 的表現: 對你這種做 RAG / agent / tools‑calling 工作流的人來說,這顆模型的亮點其實是「在環境中操作和修 […]

Meta FAIR 的「Code World Model (CWM)」是一個 32B 參數、專門為「帶世界模型的程式碼生成研究」設計的開放權重 LLM。它的關鍵點是:不只學 code syntax,而是透過大量「執行軌跡」去內化程式執行對系統狀態的影響,並在多任務 RL 下強化 agentic coding 能力。

CWM 是什麼?

  • CWM(Code World Model)是一個 32 億參數(32B)、dense、decoder‑only 的 Transformer LLM,主要面向程式碼生成與程式相關推理。
  • 它被設計成「世界模型式」的 code LLM:不只預測下一個 token,而是學會在腦中「模擬程式執行過程」及其對環境狀態的影響。
  • 官方目標是提供一個強大的開放權重 testbed,讓研究者探索「世界模型 + agentic reasoning/planning」如何提升程式碼生成與軟體工程工作流。

訓練流程與 world modeling 設計

CWM 的訓練 pipeline 不是單純「pretrain → SFT」,而是刻意插入 world‑model mid‑training,再加上多任務 RL:

  • 前期:先在一般語言與程式碼資料上做大規模預訓練,建立廣泛的語言、程式知識基礎。
  • Mid‑training(世界模型核心):
    • 在大量「observation‑action 軌跡」上進一步訓練,這些軌跡來自 Python interpreter 執行 trace,以及在 Docker container 中以 agent 方式操作系統的互動紀錄。
    • 這類資料讓模型看到「程式片段/指令 → 執行過程 → 輸出與系統狀態變化」,等於學習一個對應「code → world dynamics」的隱式世界模型。
  • 後期 post‑training:
    • 先進行 supervised fine‑tuning,引入明確的 reasoning format、step‑by‑step 推理風格等標註資料。
    • 再用 multi‑task RL(文中提到使用 GRPO 類型方法)在可驗證的 coding 任務、數學問題、多輪軟體工程環境中進行強化學習,reward 來自於測試通過率、解答正確與任務完成度。

這種設計的重點是:讓 RL 是「從已經具備世界模型的基底」開始,而不是只在純 token LLM 上做 RL,理論上比較容易學到長程規劃與工具使用策略。


模型架構與上下文長度

  • CWM 是一個 64 層的 decoder‑only Transformer,採用現代 LLM 常見配置(例如 RoPE 位置編碼、SwiGLU FFN、GQA 等)。
  • 參數規模為 32B,詞彙表約 128k token,明顯針對大型 codebase 與多語言程式碼場景設計。
  • 上下文長度最高達約 131k tokens,可容納整個專案、多檔案上下文與長程互動軌跡。
  • 為了處理這種長上下文,它使用「交錯式注意力」:
    • 多數層採局部 attention(例如 8,192 token 視窗),每隔數層插入一次 global/sliding attention 層可以看到完整 131k 上下文,文中描述比率約為 3:1。
    • 這樣的設計在計算量可控的前提下,仍能在多層中“刷新”全局資訊,對閱讀大型 codebase 與長對話 debugging 特別有利。

基準測試成績

在多個開源 benchmark 上,CWM 以 32B 級別達到非常有競爭力甚至 SOTA 的表現:

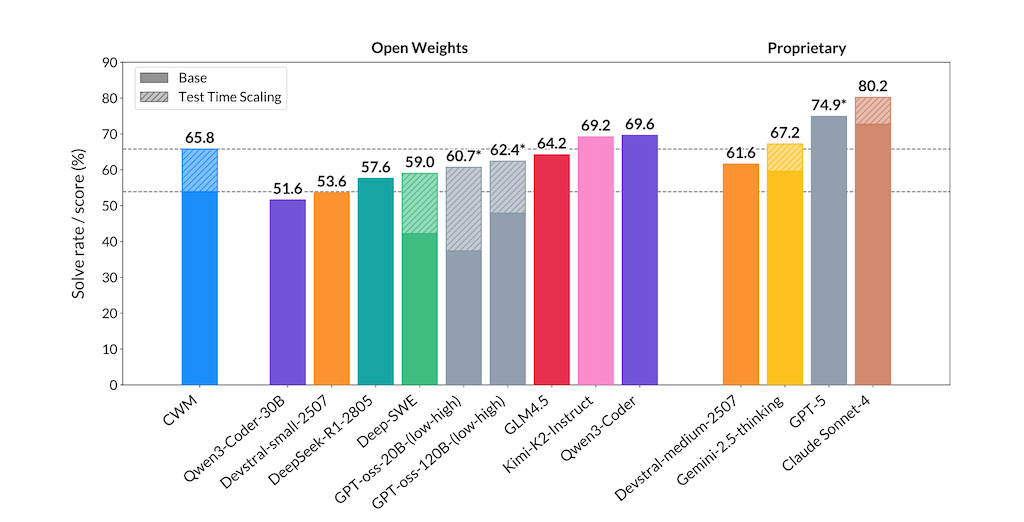
  • SWE‑bench Verified:pass@1 約 53.9%(不做 test‑time scaling),在採用 test‑time scaling 後可達約 65.8%。
  • LiveCodeBench:v5 約 68.6,v6 約 63.5(pass@1)。
  • 數學與推理:
    • Math‑500 約 96.6%。
    • AIME 2024 約 76.0%。
    • CruxEval Output 約 94.3%。
  • 論文與解讀都提到:在同等或相近參數規模的開放權重 LLM 中,CWM 在一般 coding 與更 agentic 的軟體工程任務上都具有「best‑in‑class」水準,甚至接近或追平一些封閉大模型。

對你這種做 RAG / agent / tools‑calling 工作流的人來說,這顆模型的亮點其實是「在環境中操作和修 bug 的能力」,而不只是單輪 code completion 分數。


權重釋出與取得方式

  • Meta 以「開放權重」形式釋出 CWM,提供多個 checkpoint:
    • mid‑training 後的 world‑model 版本。
    • SFT 後版本。
    • RL 後完整版。
      方便研究者分析各階段對能力的影響。
  • 社群整理指出,CWM 權重目前在 GitHub 與 Hugging Face 上提供,包含 transformers 版權重與推理程式碼;Meta 採用自家訂定的 open‑weights 授權條款,主要定位在研究用途,具體使用限制需看 AI at Meta 官方頁與 HF model card 條款。
  • Hugging Face transformers 已內建 CwmForCausalLM 與對應 tokenizer。

與一般 code LLM 的本質差異

和傳統只在「靜態 code corpora + 少量程式執行資料」上訓練的 code LLM 相比,CWM 的幾個關鍵差異:

  • 訓練核心是「大量程式執行與 agent interaction 的軌跡」,把「程式 → 執行 → 狀態變化」當成序列學習對象,形成隱式世界模型,而不只是 code token 統計模型。
  • RL 設計是圍繞「可驗證結果」(例如測試通過、問題解答正確、多輪任務完成),而不僅是人類偏好/指令跟從,這對長程規劃與工具調度尤其重要。
  • 長上下文 + 交錯 attention 讓模型可以在一次推理中讀完整個 repo、ticket 歷史與多輪 log,這是很多傳統 code LLM 現階段比較薄弱的地方。
Categories: 模型, 編程

ComboStoc 擴散模型訓練更快的關鍵

用非同步時間步,補足擴散模型盲點。

ComboStoc samples

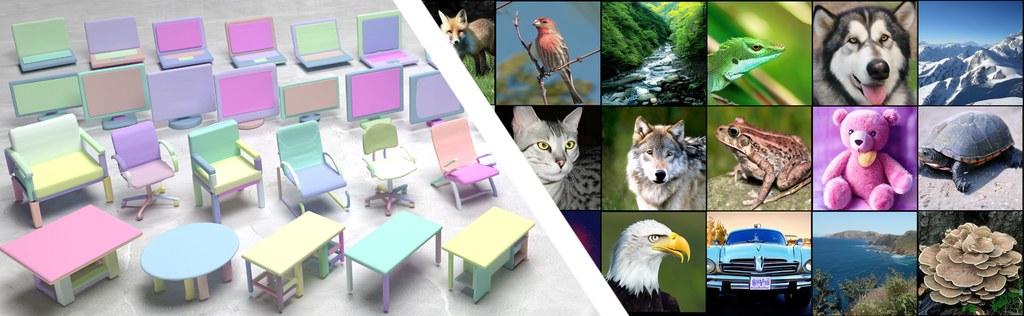
ComboStoc 是一個針對擴散生成模型訓練流程的研究型實作,核心目標不是換掉整個模型架構,而是修正既有訓練對「組合式結構」取樣不足的問題。這個版本以 PyTorch 為主,提供影像擴散模型、訓練腳本,以及預訓練權重,定位相當明確:拿來驗證論文方法,也適合已有 SiT 或相近擴散管線的人直接比較。

這個專案真正有辨識度的地方,在於它不再把整筆資料視為同步走在同一個 diffusion timestep。相反地,它讓不同維度、patch,甚至可能的屬性使用非同步時間步,藉此更完整覆蓋高維資料中的組合空間;這也是它和一般只調 loss、scheduler 或採樣器的做法最不一樣之處。

實務上,它延續 SiT 風格的實作思路,並提供基於 PyTorch DDP 的訓練流程,代表它不是紙上談兵,而是可在分散式訓練中直接測試。推論端也不只是在既有 checkpoint 上出圖,還能利用非同步時間步做更細緻的控制;若參考論文描述,這種機制對局部條件控制或結構化生成尤其有意義。

最能受益的族群,會是正在研究影像生成、擴散模型訓練效率,或需要面對高度結構化資料的人。若你關心的是更快收斂、較低 FID,或想把相同模型延伸到更有屬性組合複雜度的任務,這個專案值得細看;至於 3D structured shape 的完整程式,儲存庫目前看來仍是後續補上。

  • 特色在於非同步 diffusion timestep,不是單純更換 backbone
  • 以 PyTorch 實作,並提供 DDP 訓練腳本
  • 已附預訓練的 ComboStoc-XL-2 權重,可直接做採樣比較
  • 適合拿來研究高維資料中組合複雜度對生成品質的影響

Source: https://github.com/Xrvitd/ComboStoc

Categories: 開源, 香港大學, 模型, 影像模型

Moonlake AI 3D 建模代理

Moonlake AI 推出的 3D Agent 是其世界建模代理的重要更新,能直接在 Blender 中操作電腦,自動建立 3D 場景、關節資產與複雜環境。 主要功能 它能從單一圖像重建可編輯的室內外場景,無需預定義規則;同時建模具零件與關節的資產,並持續精煉數千步驟。代理像技術藝術家般運作,整合現有製作流程,支援資產管理系統並批量啟動任務。早期合作夥伴已用於模擬資產創作、遊戲世界建置與場景清理等重複工作自動化。 應用場景 適用於遊戲開發、3D 內容生成與生產線自動化,能加速互動世界建置達 100 倍。Moonlake AI 獲 NVIDIA 等投資,聚焦多模態推理模型與生成遊戲引擎。

Moonlake AI 推出的 3D Agent 是其世界建模代理的重要更新,能直接在 Blender 中操作電腦,自動建立 3D 場景、關節資產與複雜環境。

主要功能

它能從單一圖像重建可編輯的室內外場景,無需預定義規則;同時建模具零件與關節的資產,並持續精煉數千步驟。
代理像技術藝術家般運作,整合現有製作流程,支援資產管理系統並批量啟動任務。
早期合作夥伴已用於模擬資產創作、遊戲世界建置與場景清理等重複工作自動化。

應用場景

適用於遊戲開發、3D 內容生成與生產線自動化,能加速互動世界建置達 100 倍。
Moonlake AI 獲 NVIDIA 等投資,聚焦多模態推理模型與生成遊戲引擎。

Categories: Agentic, NVIDIA, 3D

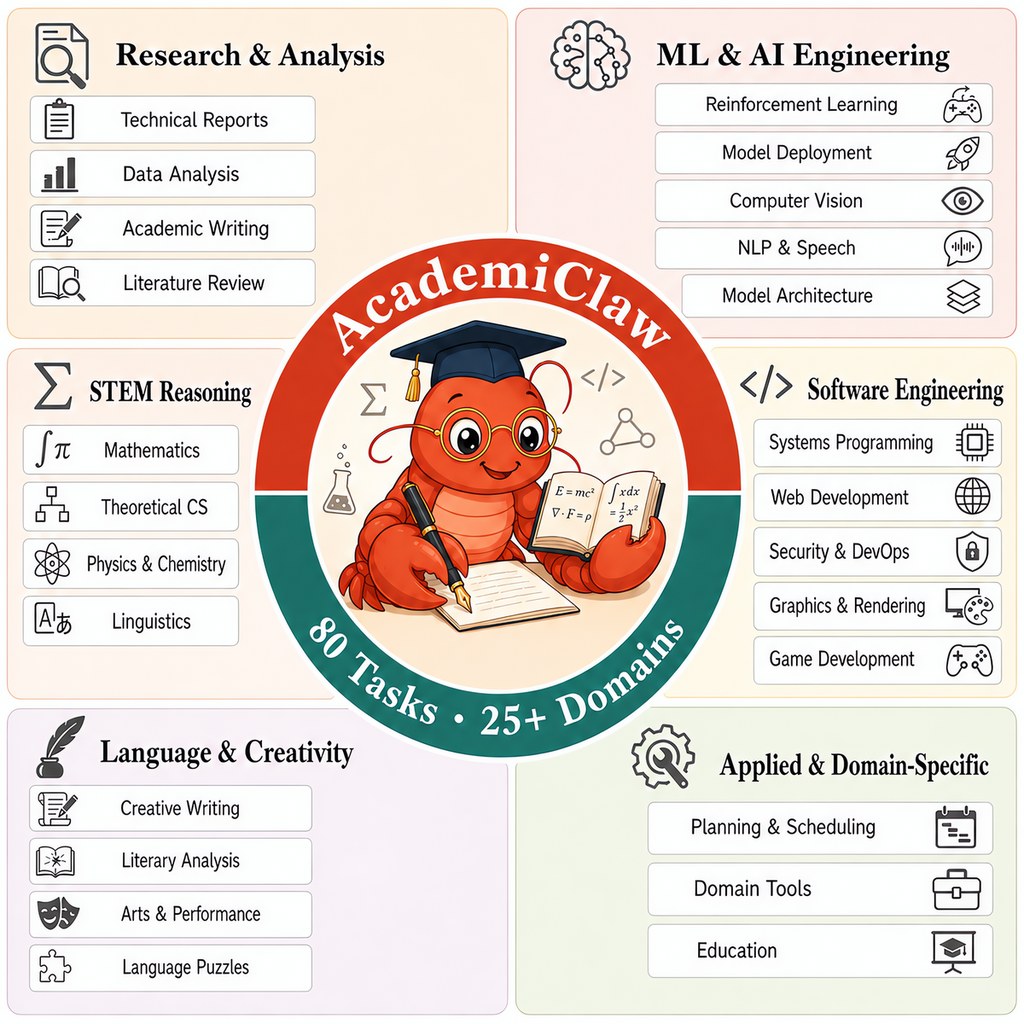
AcademiClaw 包含80個大學生的學術任務雙語基準測試

OpenClaw在真實學生任務上測試AI。

OpenClaw學術評估流程
GAIR-NLP/AcademiClaw

AcademiClaw 包含80個大學生的學術任務雙語基準測試 為AI代理呈現了一項獨特的學術 挑戰,透過使用真實世界的學術任務。這80個任務直接來自學生,突顯了當前AI不足之處。

該基準測試涵蓋了各種類別,如研究、軟體工程和語言創意,確保了全面的測試。研究人員和開發者可以專注於這些類別,以識別AI的優勢和弱點。每個任務都經過精心設計,並進行多維度評估,增強其可靠性。

在實際應用中,AcademiClaw 使用CPU和GPU任務的混合,根據需求自動路由。這種設置確保了在測試不同AI模型時的可重現性和公平性。用戶從詳細的評分維度和安全審核中受益,提供了對模型性能的洞察。

教育工作者和AI研究人員將發現 AcademiClaw 對於提升AI能力極具價值。它需要能夠處理複雜、長時間範圍任務的強大LLMs。

主要收穫:
–  AcademiClaw 使用真實的學生挑戰來測試AI。
– 它涵蓋了多樣化的學術領域,並進行詳細評估。
– 需要堅固的LLMs才能有效完成任務。
– 為AI開發和教育提供寶貴的見解。
– 支援CPU和GPU任務,以實現靈活的測試。

Source: https://github.com/GAIR-NLP/AcademiClaw

Categories: 開源, Agentic, OpenClaw

SenseNova-U系列:一種突破性的多模態AI

SenseNova U1重新定義了多模態AI。深入探索吧!

SenseNova-U1
OpenSenseNova/SenseNova-U1 on GitHub

[2026-08-21] SenseNova-U1.5 更新版模型下載

SenseNova U1引入了一種突破性的多模態AI方法,通過單一架構統一語言和視覺。這種創新允許文本和圖像之間無縫互動,而不需要單獨的適配器,增強了效率和一致性。

在探索SenseNova U1時,最初應關注其核心架構NEO-Unify,這使得模型能夠將視覺和文本數據作為統一的複合體進行處理。實際上,這意味著模型可以更有效地跨不同類型的輸入進行推理,保留語義豐富性和視覺忠實度。

研究人員和開發者最能受益於SenseNova U1的能力,特別是那些從事需要高密度資訊渲染或交錯圖文生成應用的人。該模型處理複雜任務(如創建知識插圖或旅行日誌)的能力使其成為一個寶貴的工具。

為了充分利用SenseNova U1,用戶應擁有能夠支援多模態任務的強大大型語言模型(LLM)。該模型的開源性質也鼓勵社區貢獻和進一步發展。

• SenseNova U1原生統一多模態處理。
• 它擅長交錯圖文生成。
• 用戶需要一個穩健的LLM以實現最佳性能。
• 適合研究人員和開發者。
• 在開源多模態AI中設定了新的標準。

Source: https://github.com/OpenSenseNova/SenseNova-U1

Categories: 開源, 模型, 影像模型, 影像處理

ClawMetry:看見您的代理思考

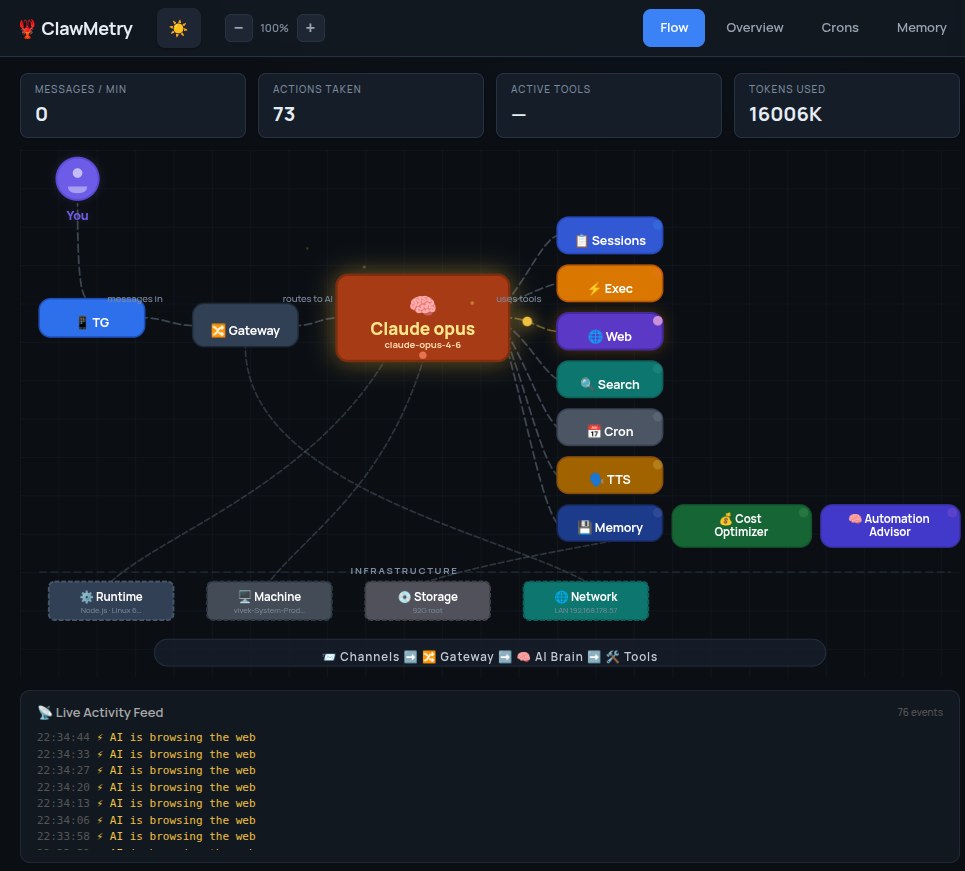
ClawMetry 可視化 AI 代理流程。零配置設置。

流程可視化

實時動畫流程儀表板是一個突出的功能,展示了通道、大腦、工具等之間的消息交換。這種可視化幫助開發者一目瞭然地理解複雜的交互。

Clawmetry 是一個專為 OpenClaw 設計的開源即時監控儀表板,它會自動讀取 OpenClaw 的現有 openclaw.json 配置文件和 Session 日誌,顯示 Agent 活動、工具呼叫、Token 消耗等資訊 。
它是獨立運行的 Python 服務,使用 pip install clawmetry 安裝後啟動,就能透過 Web 介面(預設 http://localhost:8900)查看資料,無需任何額外配置 。
Clawmetry 只讀取資料,不會寫入或改變 OpenClaw 的任何設定檔案,對 OpenClaw 性能影響極小(獨立進程,額外記憶體約 30MB)。

安裝與使用

安裝後,它會掃描你已配置的 OpenClaw 頻道,只顯示實際在 openclaw.json 中設定的項目 。
若要自訂,可用 clawmetry --port 9000 --workspace /path/to/openclaw/workspace 指定路徑,但仍僅讀取不修改 。
適合你作為 AI/ML 工程師,用來監控 RAG 系統或 Cantonese NLP Agent 的運行狀態 。

主要功能:
* 自動偵測 AI 代理配置
* 提供實時流程圖以提高清晰度
* 高效追蹤令牌使用和成本
* 支援多種大型語言模型

Source: https://github.com/vivekchand/clawmetry

Categories: 開源, OpenClaw

AnyRecon:使用視頻擴散模型進行任意視角3D重建

AnyRecon將視頻轉換為3D視圖。適合創作者使用。

logo
OpenImagingLab/AnyRecon 在 GitHub 上

AnyRecon利用視頻擴散模型從輸入視頻中重建任意的3D視圖。這個創新的工具對於希望探索視覺敘事新維度的內容創作者和研究人員特別有用。

在開始使用AnyRecon時,最初應專注於理解其核心功能——將連續幀轉換為空間上一致的3D重建。該過程涉及將視頻數據通過預訓練模型,該模型輸出詳細的3D模型。此工作流程需要仔細準備輸入視頻並精確配置模型參數。

研究人員和藝術家最能受益於AnyRecon的功能。它使他們能夠從現有的視頻內容生成沉浸式的3D環境,為虛擬現實應用和互動媒體打開了可能性。然而,用戶應該意識到該工具需要強大的大型語言模型(LLM)才能達到最佳性能。

主要收穫包括:
* AnyRecon使用視頻擴散模型進行3D重建。
* 適合內容創作和研究目的。
* 需要堅固的LLM以獲得最佳效果。

了解AnyRecon的底層機制有助於用戶有效地量身定製他們的項目。通過嘗試不同的視頻輸入和調整設置,創作者可以解鎖獨特的視覺體驗。

Source: https://github.com/OpenImagingLab/AnyRecon

Categories: 開源, 香港中文大學, 香港大學, 模型, 影像處理

詳細的AI影視劇創作專業流程講解

創作者用 AI 生成影視素材後,處理如何把畫面組成完整作品。

目前最详细的AI影视剧创作专业流程讲解,运用传统影视工业流程思维帮助你制作出更好的AI影视作品

這段 YouTube 講解以傳統影視工業流程,介紹專業的 AI 影視創作流程,讓製作思維不只停留在生成素材。這是一個較詳細的 AI 影視劇創作專業流程講解,運用傳統影視工業流程思維幫助你製作出更好的 AI 影視作品。描述附有 RunningHub 畫布工作流連結,供讀者查看相關工作流。

內容方向:
• 借用傳統影視工業流程思維組織 AI 創作。
• 聚焦如何把生成內容帶入影視作品製作流程。
• 提供 RunningHub 畫布工作流連結,並附交流社群及註冊資訊。

對正在製作 AI 短片或影視內容、希望更有系統地安排創作步驟的人,影片可作流程思維的入門參考。

Categories: 影像處理, 教學

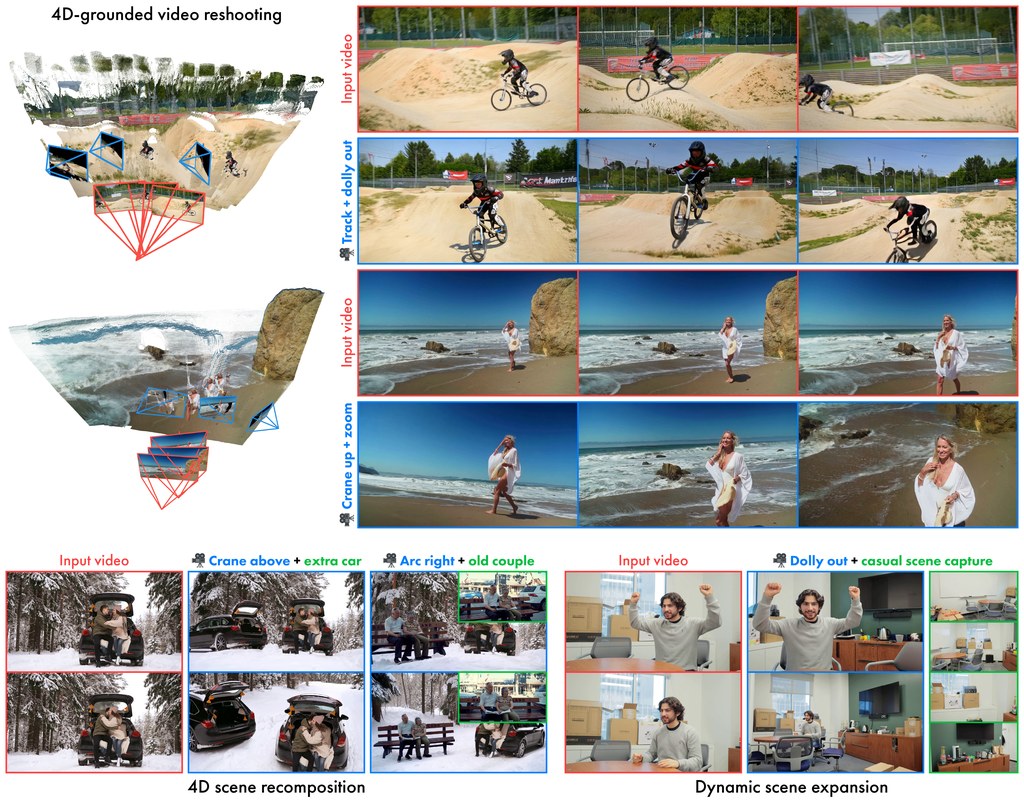
Vista4D 使用 4D 點雲進行視頻重拍

Vista4D 動態地重新拍攝視頻。對於創作者來說非常理想。

Vista4D 預告圖
Eyeline-Labs/Vista4D 在 GitHub 上

Vista4D 提供了一種獨特的視頻重拍方法,通過從新的角度合成場景。它利用 4D 點雲有效地處理現實世界中的視頻缺陷。這使得它特別適合希望擴展其視覺敘事能力的創作者。

在開始使用 Vista4D 時,重點是理解其核心功能——從新穎的角度重拍視頻。該框架對點雲工件的強健性確保了即使在不完美的重建下也能可靠運行。此特性對於維護場景完整性至關重要。

在實際應用中,Vista4D 受益於動態場景擴展和 4D 場景重組的專業人士。它在保留場景內容的同時允許精確的相機控制,為創意編輯打開了大門。用戶可以預期在視頻製作流程中獲得增強的靈活性。

該框架需要一個強大的大型語言模型(LLM)以獲得最佳結果。創作者和編輯人員將發現 Vista4D 因其創新性的視頻操作方法而極具價值。

• 使用新穎視角增強視頻重拍
• 對點雲工件具有強健性
• 適合動態場景擴展和重組

Source: https://github.com/Eyeline-Labs/Vista4D

Categories: 開源, 模型, 視頻模型, 影像模型, 影像處理

MocapAnything 創新的動作捕捉方法

MoCapAnything V2 提供了一種創新的動作捕捉方法。對於尋求高效、多功能解決方案的動畫師和研究人員來說,這是理想的選擇。

MoCapAnything V2 預告片 — 點擊以在項目頁面觀看視頻
animotionlab26/MocapAnything 在 GitHub 上

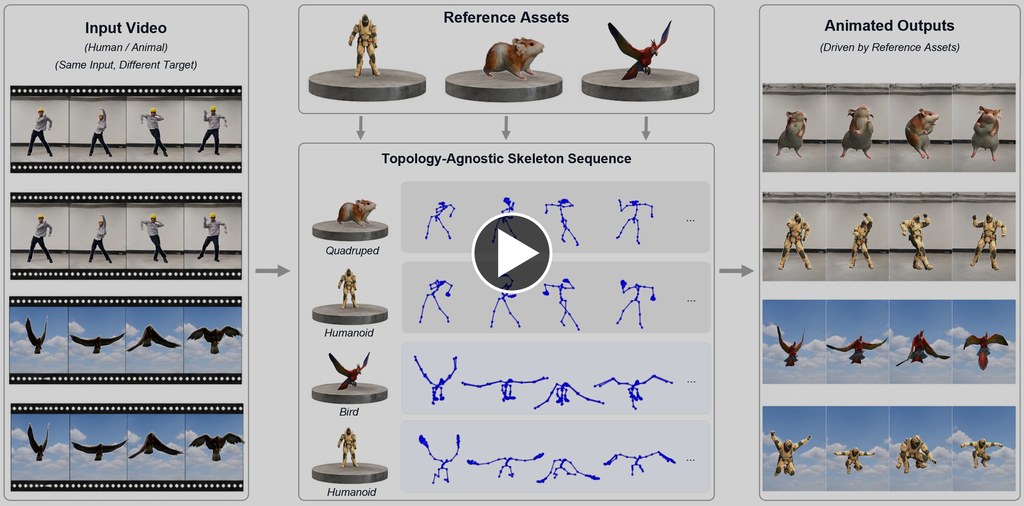
MoCapAnything V2 為那些從事動畫、遊戲開發和需要動作捕捉能力的研究人員提供了一個令人信服的解決方案。該工具通過將單目視頻轉換為詳細的骨骼動畫而脫穎而出,而不依賴於中間網格模型。對於希望在保持高精度的同時簡化工作流程的專業人士來說,MoCapAnything V2 值得探索。最初,用戶應專注於理解參考錨定旋轉的核心概念,這簡化了使用單一參考姿勢-旋轉對將姿勢轉換為旋轉的過程。這種方法確保生成的動畫既精確又在不同資產之間保持一致。

在實踐中,MoCapAnything V2 通過其主要模型 video2pose2rot 運行,該模型整合了兩個子任務:從視頻幀預測關節位置(video2pose)和將這些位置轉換為關節旋轉(pose2rot)。這些任務共同優化,消除了對分析逆運動學的需求。結果是一個無縫的管道,可以直接從輸入視頻提供 BVH 準備好的關節旋轉。這種方法不僅提高了效率,還為速度至關重要的實時應用打開了可能性。處理多樣角色模型的動畫師和開發人員將發現這特別有益,因為該系統可以使用匹配物種的參考框架來適應各種骨骼結構。

在其項目中處理複雜、任意骨骼的人。無論是動畫人類角色還是奇特生物,該工具的靈活性都允許在沒有傳統方法約束的情況下進行準確的動作捕捉。計算機視覺和機器學習領域的研究人員也會欣賞這一端到端優化的創新,為動作捕捉技術的進一步發展提供了堅固的框架。

然而,也有一些權衡需要考慮。雖然無網格的方法顯著提升了處理速度,但它可能無法捕捉到基於網格系統所能處理的細節。用戶應評估 MoCapAnything V2 提供的細節水平是否符合他們項目的要求。此外,對參考姿勢的依賴意味著為了獲得最佳結果,需要仔細選擇和校準。儘管有這些考慮,MoCapAnything V2 所提供的優勢使其成為任何從事動作捕捉的人的工具箱中有價值的添加。

MoCapAnything V2 在動作捕捉技術方面代表了一個重要的進步。其端到端設計,加上參考錨定旋轉和無網格處理,使其成為動畫師、遊戲開發者和研究人員的強大工具。通過專注於關鍵特徵並理解實際影響,用戶可以有效地利用此工具。雖然有一些限制需要注意,但對於許多應用而言,提高效率和靈活性的好處遠遠超過缺點。

Source: https://github.com/animotionlab26/MocapAnything

Categories: 開源, 影像處理

Page 114 of 185
1 … 112 113 114 115 116 … 185