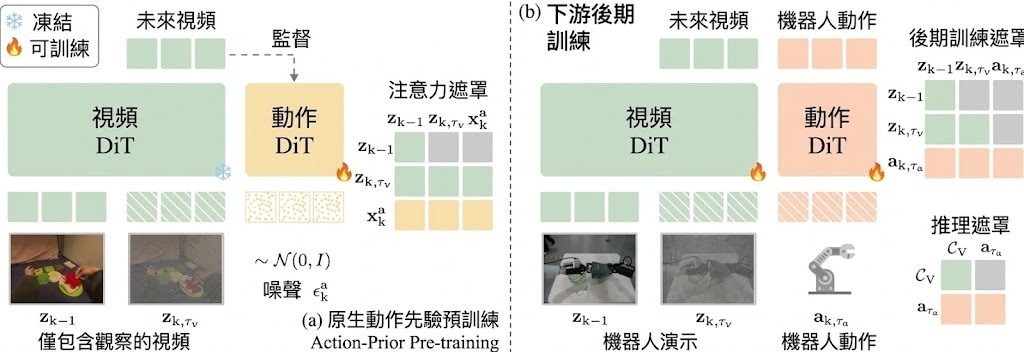
機械人只看過人類操作影片,未必需要先建立中間視覺表徵或獨立的潛在動作模型,便能學習下一步應怎樣移動。NAVA-WAM(Native Action-Prior Learning from Videos for World Action Models)是一個 World Action Models(WAM)項目,直接從 observation-only videos 預訓練 action policy,處理動作標註機械人軌跡不足的問題。
訓練分為兩個階段:第一階段利用影片中的未來視覺變化作 flow-matching supervision,透過 transition-structured joint attention 將與動作相關的資訊傳入 Action-DiT;第二階段再加入動作資料,讓策略對應到機械人控制。這種做法避開先學視覺、再轉換成控制訊號時可能出現的落差。
實驗把經 DROID 訓練的策略直接放到實體 Franka FR3,沒有針對個別任務再微調。在三項任務共 15 次測試中,NAVA-WAM 平均成功率為 93.3%,DreamZero 為 66.7%,π0.5 為 53.3%;伺服器端每次 policy call 為 379.2 毫秒,按每次重新規劃實際執行的動作數計算,每個動作約 15.8 毫秒。
• 從 observation-only videos 直接學習 action policy
• 不依賴中間視覺表徵或獨立 latent-action model
• 在空間關係任務中,NAVA-WAM 成功 4/5 次,兩個基線均為 0/5
• 已在實體 Franka FR3 上測試,未作任務專屬微調
T1 要求把方塊放到碗的左側,基線模型雖能正確定位和抓取方塊,卻未能理解指令中的空間關係;NAVA-WAM 則較能將視覺互動經驗連接到具體控制行動。項目的限制是訓練仍需要第二階段的動作資料,並非完全脫離機械人示範,因此更適合用作擴充動作先驗,而不是取代所有實體機械人資料。