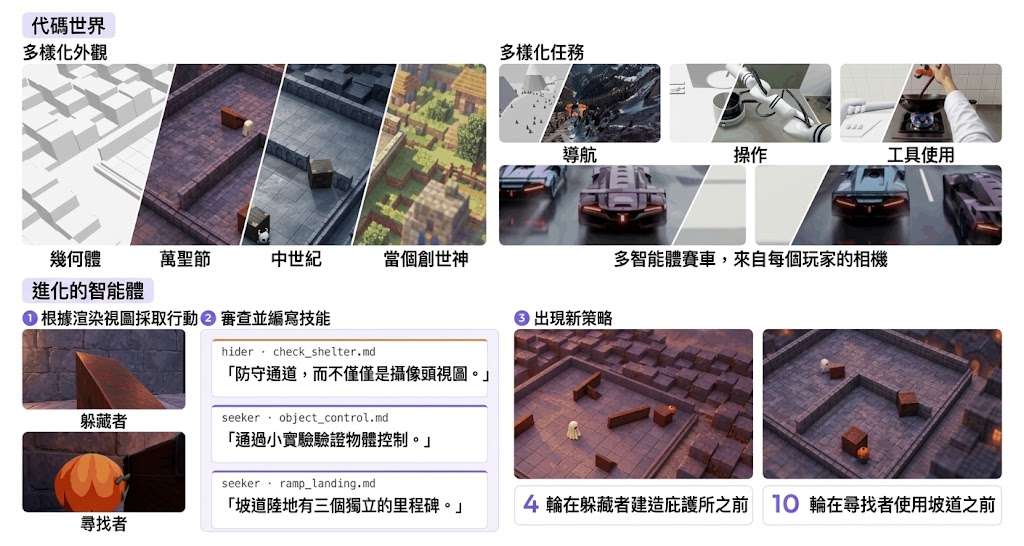
讓智能體在同一個世界反覆試錯,關鍵不只在模型能力,也在環境是否真的記得狀態、遵守規則,並以接近真實的畫面回應行動。AgentGarten 屬於面向 Agentic 系統的互動環境與神經渲染器項目,處理的是可執行世界難以同時兼顧規則一致性、視覺質感與即時速度的問題。
世界中的物件、目標和變化由程式保存,程式輸出的 depth 或 surface normals 則交給共享 neural renderer 生成智能體看到的畫面。renderer 以 NVIDIA Cosmos3-Nano 為基礎,先用 bidirectional rectified-flow 訓練完整影片,再以 autoregressive block-causal 方法配合 teacher forcing 或 diffusion forcing 生成後續畫面,最後透過 Adversarial Forcing 將模型蒸餾成較少步驟的學生模型。
目前公開內容集中在 neural renderer、訓練配方及 streaming inference;code worlds 和完整 agent practice loop 仍會逐步加入。試用需要 Python 3.11 或以上、PyTorch 2.9 或以上,以及 CUDA 主機,較適合研究智能體、模擬環境或自製互動遊戲的團隊,而非只想即時調用一個現成聊天模型的讀者。
- 可控狀態:規則和世界變化留在可檢查、可修改的程式內。
- 統一視覺介面:只要提供幾何條件,同一世界可以切換不同視覺風格。
- 即時能力:官方資料指在單張 H100、480×832 解析度可超過每秒 30 幀。
- 學習閉環:智能體每輪把經驗整理成 playbook,交給後續輪次繼承。
這種做法以幾何條件取代為每個世界重新製作完整視覺資產,換來較高彈性,但畫面質素仍取決於 renderer 訓練資料、條件輸出和硬件。項目展示的 shelter、bridge 及 companion dog 場景說明它可支援 self-play RL;不過完整程式世界尚未全部公開,現階段更適合作為研究原型和 renderer 實驗基礎。