Motion Prompt:萬用 AI Motion Graphic

想叫 AI 加入某種鏡頭運動或網頁效果,卻不知道該怎樣描述?Motion Prompt 把名稱、動態示例和提問範本放在一起,方便查找與轉交創作要求。

描述鏡頭運動、動態圖像或網頁效果時,光靠「有感覺一點」往往難以讓 AI 掌握方向。Motion Prompt 是一個創作名稱與示例庫,收錄 192 個名稱,每項附有動態示範、簡短解釋和提問例句,涵蓋動態圖像、鏡頭運動、UI 元件、網站效果和攝影風格。

使用者可在網上 Gallery 播放示例、搜尋名稱,再選取多項並附上備註,將整理好的要求交給 AI;不使用技能時,也可複製提示詞和示例連結。 packs/ 提供五種語言的名稱清單,包括繁體中文。項目亦提供建立自訂領域及語言版本的提示詞;說明了技能安裝方式,但沒有提供完整的手動部署流程。

與只列術語的詞典相比,Motion Prompt 把可觀看的動態參考和可直接改寫的提問放在同一項目;每個示例的參考實作以 Canvas 2D 撰寫,不依賴外部程式庫,並可逐格繪製及用於影片輸出。它提供的是創作參考與溝通素材,不代表不同 AI 模型都能產生相同效果,也沒有提供量化性能評測。

  • 可播放示例,並按名稱或編號查找。
  • 多選示例、加入備註,再把要求交給 AI。
  • 不使用技能時,可複製提示詞及參考連結。
  • 提供繁體中文清單,以及製作自訂名稱庫的提示詞。

影片創作者、設計師和需要以 AI 協作的前端團隊,可用它把抽象的視覺想法轉成較具體的術語與參考。若工作流程依賴特定模型或成品品質,仍需自行測試提示詞能否帶出預期結果;現有內容主要是示例庫,並非生成模型或效果保證。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, Video, Image, 提示詞, Content Creator, 庫, Anthropic, Skill 技能, UI/UX

AesCode 以圖像生成資訊網頁

生成式 AI 做海報或儀表板時,常要在視覺美感與文字、數據正確之間取捨。AesCode 把圖片生成器當作設計參考,再輸出可編輯、可驗證的 HTML 與 CSS。
Infographics generated as editable HTML and CSS by AesCode

想用 AI 製作簡報、海報、儀表板或網頁,往往不只要內容齊全,版面層次和配色也要合適。AesCode 是一個視覺程式碼生成模型,透過圖片生成器提供美感參考,再把結果寫成可編輯、可驗證的 HTML 與 CSS;文字和數據仍以使用者提示為準,避免把參考圖中的錯誤內容照搬進成品。

AesCode 不把參考圖片當成正確答案,而是訓練模型分開處理內容要求與視覺線索。它先用設計圖表示文字、圖表、表格和版面區域之間的關係,再以多項可程式化檢查評估執行結果、文字、邊界、圖表數據、版面及留白;視覺評分則採用與設計圖連結的評分規準,並把不同評分渠道分開處理。

簡單講,就係「用 AI 將內容變成有設計感、而且可以修改嘅 HTML/CSS」:你提供文字要求,可以再加一張參考圖片,佢就生成資訊圖、簡報頁、海報或者儀表板,而唔係只生成一張平面圖片。

訓練從既有的 8B 和 32B 模型出發,並非從零訓練;項目提供 AesCode-8B 與 AesCode-32B 模型。首頁列出 3,000 個冷啟動監督微調示範和約 7,408 個強化學習提示,並提醒提示數量不等於完整強化學習生成次數。使用者可透過公開模型測試生成結果,再按需要修改 HTML 與 CSS;複雜插圖和照片則保留為語義佔位區,圖表交由 ECharts 處理,未涵蓋的視覺素材可在後續流程交給圖片生成器或人工補上。

測試結果顯示,移除推理階段的參考圖片後,AesCode-8B Visual 分數只下降 1.0 分,基礎模型則下降 19.6 分;即使政策模型推理時看不到參考圖,採用參考圖評分訓練後,僅依提示生成的 Visual 分數仍由 25.17 升至 69.71。AesCode-32B 在 GDB/lica、SlidesBench 和 Design2Code 的 14 項指標均高於 Qwen3-VL-32B 基礎模型,提升較多的項目集中在設計相關指標;這些結果支持設計能力能遷移至其他基準,但不代表每種版面都能一次生成妥當。

  • 參考圖片提供版面與風格線索,不作為文字和數據的事實來源。
  • 設計圖把元素及其對齊、包含和排列關係納入評估。
  • HTML 與 CSS 保留編輯空間,適合需要後續人工調整的設計工作。
  • 複雜插圖採用佔位區,圖表使用 ECharts,生成範圍因此有所限制。

需要大量製作資訊圖像、簡報或儀表板的設計與內容團隊,可以把 AesCode 納入生成及後期修改流程;熟悉 HTML、CSS 的開發者亦較容易檢查版面並修正細節。它的優勢在於把視覺指引轉化為可修改的程式碼,而非交付一張難以局部調整的平面圖;若成品需要精細插畫或照片,仍要安排額外素材生成或人工處理。

項目主頁 · GitHub · 模型
Categories: 開源, 模型, 模型訓練, Qwen, 微軟, Image, Dataset 數據集, UI/UX, 強化學習

ExpActivator:讓 GUI 代理學懂何時啟用個人經驗

ExpActivator 不再把所有相關歷史硬塞進每一步,而是按畫面、時間與情境判斷哪些經驗真正適用。

當個人 GUI 代理執行多步任務時,相關歷史未必適合每一個畫面;ExpActivator 把這個取捨轉化成經驗啟用問題。它屬於免訓練的個人 GUI 代理框架,處理歷史操作何時應該介入當前決策,以及何時應該保持沉默。

逐步啟用會把新畫面放入凍結 GUI backbone 的 latent space,尋找相近的歷史狀態,再把對應動作交給 policy 作參考,代理可以採用、修改或拒絕。任務級啟用則只會在時間和情境都支持時提出重複意圖,否則選擇 abstain;相比把整段檢索歷史附加到 context,歷史不再被視為每一步都有效。

PersonalAlign 評估涵蓋 775 個個人化執行 episodes、7,915 個 actions,以及 215 個正面和 100 個負面 proactive suggestion states,測試 Qwen3-VL-8B、MAI-UI-8B、Qwen3.5-9B 和 GUI-Owl-1.5-8B。以 Qwen3-VL-8B 為例,ExpActivator 的開首步驟成功率為 70.06%,後續步驟為 26.67%,高於無歷史的 28.26%和 18.43%;研究頁亦報告平均軌跡步驟成功率提升約 28%,proactive suggestion 的 MCC 約為最強基線的 2.3 倍。

適合研究個人化 GUI 代理、重複工作流程和主動建議的團隊測試。項目不會訓練模型或預測參數,PersonalAlign 提供安裝及執行流程,但需另取 PersonalAlign 的 Fingertip20k;記憶應採用每位使用者按時間排列的前 80%,避免與執行測試 episodes 重疊。

  • 按畫面逐步啟用歷史動作,而非只按任務檢索
  • 按時間與情境判斷是否提出主動建議
  • 凍結 backbone,無需重新訓練模型
  • 同時測試個人化執行與 proactive suggestion
  • 依賴外部 Fingertip20k 歷史資料及多個 GUI backbone

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 框架, 庫, UI/UX

AutoGUIWorld:跨平台 GUI Agent 訓練場景及模型

以圖像生成模擬 GUI 狀態轉換,降低建立跨平台對真實軟件環境的依賴。

GUI Agent 要學懂跨平台操作,往往受限於收集資料時能夠安裝和重設的軟件環境。AutoGUIWorld 會生成 Windows、macOS、Ubuntu、Chrome、Android 或 iOS 的 GUI 場景,再由模型規劃點擊、開啟、切換等動作,透過圖像編輯生成每一步的畫面。它屬於面向 Computer-use agents 的資料生成框架,在毋須逐一啟動真實應用程式的情況下,建立有畫面、有動作、有座標標註的訓練軌跡。

AutoGUIWorld 把語意規劃和畫面轉換分開。Meta Planner 先按場景建立任務及動作序列,Voyager 讀取最新的乾淨截圖,描述下一個視覺狀態,再交由獨立的模型 adapter 處理文字、視覺和圖像生成或編輯;grounding backend 則負責找出指向目標的位置。每條軌跡會保留 obs_k.png、帶有目標框的 act_k.png,以及記錄任務、計劃、動作、畫面對應、grounding boxes 和 provenance 的 meta.json,方便日後檢查和重用。

  • 覆蓋 Windows 11、macOS、Ubuntu 24.04、Chrome、Android 和 iOS 場景
  • 技術報告使用的 AutoGUIWorld 訓練集包含 79,266 個 grounded and filtered examples
  • 支援 LocateAnything-3B、MAI-UI 或視覺語言 backend 進行 pointing grounding
  • 固定 random seed 可重現結構化場景,但模型輸出的文字和像素仍可能改變
  • 生成資料不會在真實桌面執行動作,也不會自行驗證任務是否完成

雖然 AutoGUIWorld 以視覺生成換取更快的場景擴展和較低的環境管理成本。代價是生成畫面未必等同真實軟件狀態,圖像模型也可能產生不合理的介面轉換,因此項目提供 scene validity、action alignment 和 transition fidelity 等品質檢查,但不能把這些檢查視為真實執行結果。

目前公開結果集中在資料生成和模型訓練流程。用家可隨時以軌跡微調 Qwen3.5-35B-A3B ,建立合成訓練資料。對只需要真實操作成功率、而且不能接受模擬畫面偏差的工作流程,仍應把真實環境測試放在資料生成之後。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Image, 框架, 軟件, Mac, Linux, Win, Dataset 數據集, UI/UX

Ming-Image 把設計圖拆成可編輯圖層

Ming-Image 同時處理視覺設計生成與圖層還原,令 UI、海報和簡報內容更容易交由代理程式接手修改。

Ming-Image-0.1-Design on the Artificial Analysis UI/UX Design leaderboard

由文字生成完整 UI、資訊圖表、海報,再把扁平化圖片拆回透明可編輯圖層,Ming-Image 0.1 Design 系列處理的是設計稿難以延續修改的問題。它屬於視覺設計生成模型系列,實際用途是協助代理程式建立、檢查和重組圖像內容,而不只產生一張不可拆分的圖片。

系列包括兩個 6B 參數模型,Ming-Image-0.1-Design 負責生成文字密集的完整視覺構圖,Ming-Image-0.1-Design-Layer 則把成品分解成獨立、透明背景的圖層。後者支援將文字和簡單形狀抽出,配合 Image to Editable PPT 工作流程,把一頁設計或簡報圖片重建成可編輯 PowerPoint 元素;Ling UI Design 工作流程則利用生成參考圖和圖層分解,協助代理程式編寫及視覺檢查 UI 程式碼。

模型支援 RGBA 輸出,透明背景生成需使用指定的 RGBA 提示語。公開模型卡列出 1024 或 2048 解析度、12 sampling steps、CFG scale 1.0 及 BF16 等建議設定;2048 x 2048 生成在一張具備 80 GiB VRAM 的 CUDA GPU 上驗證,較適合有圖形運算資源的設計團隊,而非一般辦公室電腦即時使用。

Ming-Image-0.1-Design GGUFs | LOW VRAM Workflow
  • 生成 UI、資訊圖表、海報及其他文字密集設計
  • 將扁平圖片拆成獨立透明圖層
  • 可支援 UI 程式碼視覺檢查及可編輯 PPT 重建
  • 需要 Python 3.10+、CUDA-capable PyTorch 和模型 checkpoint

完整推理仍需按 companion Ming-Image 項目的依賴和模型服務配置處理。適合需要從參考圖快速建立設計草稿、處理透明素材,或把 AI 生成結果交回設計工具繼續修改的團隊;對只有一般 GPU 資源的使用者,VRAM 要求會是主要限制。

GitHub · 模型

Categories: 開源, 模型, Qwen, NVIDIA, Image, 工具, Python, UI/UX

[技術文章] MintAct 把跨平台視覺代理整合到單一模型

由手機、桌面到網頁操作,MintAct嘗試用一個輕量模型兼顧定位、導航與視覺工具使用。

Hero image preview

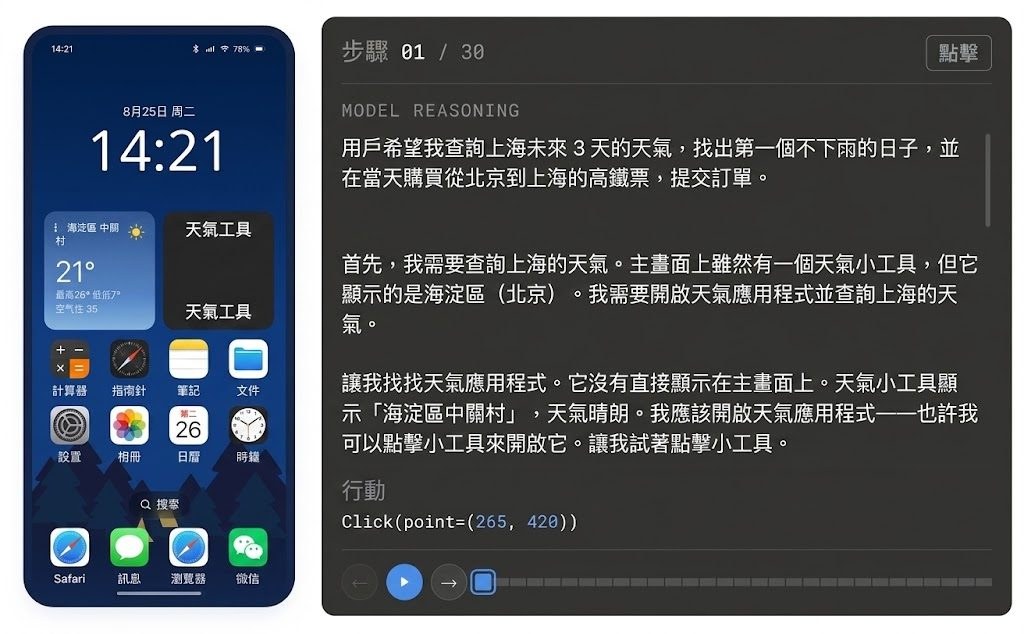
蘋果電腦即將推出一個視覺語言模型系列,它統一了跨行動裝置、桌面和Web的多步驟導航以及視覺化工具,並已在 2B 、4B 和 8B 上進行了訓練。蘋果認為讓 AI 直接操作手機、桌面或網頁,單是看懂畫面並不足夠,還要準確點擊目標、完成多步驟任務,以及在需要時呼叫外部工具。MintAct 是一系列統一的 vision-language models,針對這些分散能力提供單一視覺代理,並推出 2B、4B 與 8B 三種規模。

通常做法是 UI grounding、手機導航、桌面控制、網頁導航及視覺工具使用各自訓練專門模型。這種 per-domain specialist 範式需要分開維護,模型之間亦可能因觀察空間、動作方式和資料來源不同而互相干擾;直接混合資料,更可能令各領域表現下降。MintAct 改用多階段訓練,先以 grounding 和多步驟監督學習建立基礎,再配合強化學習(reinforcement learning,RL)整合跨平台能力。

項目的關鍵不只在模型本身,也包括支援訓練的環境和資料基礎設施。團隊讓數百個不同後端的環境並行運作,同時收集 trajectory data 和進行 online RL;非同步框架則控制不同領域的訓練比例,減少環境速度不一、回饋雜訊及 off-policy drift 帶來的不穩定。

MintAct 在相近模型規模下,聲稱能追平各領域專門模型的表現,並在 OSWorld-Verified 取得 48.9 分的結果。對需要在裝置端運行、又不想同時服務多個專門模型的工作流而言,這種統一設計具備實際吸引力,但跨領域互相干擾、環境回饋可靠性和長時序任務穩定性,仍是部署時需要持續驗證的限制。

  • 統一 UI grounding、多步驟導航及視覺工具使用
  • 覆蓋手機、桌面與網頁環境
  • 提供 2B、4B、8B 模型規模
  • 透過非同步 RL 控制跨領域訓練分佈
  • OSWorld-Verified 得分為 48.9

Paper

Categories: Agentic, 模型訓練, Google, 框架, 工具, 蘋果, UI/UX

LLaDA-UI 首個開源擴散 GUI Agent 16.7B MoE 力壓 Qwen3-VL

Inclusion AI 把 block-wise 擴散語言模型搬進螢幕操作場景,推出約 16.7B 參數的 LLaDA-UI,在六個 GUI 基準上贏 Qwen2.5-VL-7B,部分項目更超越 Qwen3-VL-8B。

LLaDA-UI GUI-agent benchmark comparison and animated qualitative diffusion decoding

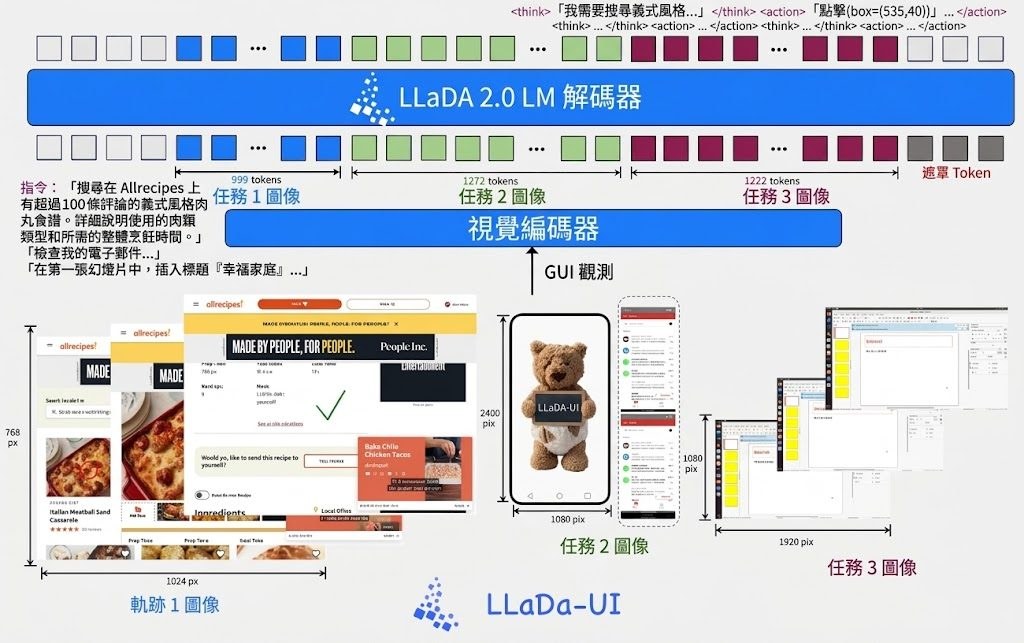
一般講 GUI Agent,都預設底層係自回歸 VLM;Inclusion AI 同螞蟻集團 Venus Team、西湖大學合作推出的 LLaDA-UI,偏偏選擇用 block-wise 擴散語言模型做骨幹,直接從遮罩 token 逐塊 denoise 出推理同動作,配合原生動態解像度視覺編碼器,覆蓋手機、桌面、網頁同 grounding 任務。模型全段約 16.7B 參數嘅 MoE 架構,訓練分兩階段,先做大規模多模態預訓練對齊 LLaDA2.0-mini-base,再做 GUI 監督微調。

喺 ScreenSpot-Pro、AndroidWorld、MobileWorld、WebVoyager 等六個基準上,LLaDA-UI 全部贏過 Qwen2.5-VL-7B,其中 ScreenSpot-Pro 52.9、AndroidWorld 53.5、WebVoyager 56.9,喺呢四項仲壓過 Qwen3-VL-8B;官方同時提到 API 速度最高有 8.95 倍 mean speedup。佢仲針對擴散解碼做咗一輪分析,包括動作合法性、軌跡長度、EOS 處理、denoising 步數同 block size 對表現嘅影響。

如果你做開手機或桌面自動化、需要 GUI Agent 處理長步驟任務又想避開自回歸延遲,LLaDA-UI 提供咗一套唔同嘅技術路線選擇;研究擴散語言模型落地嘅人,亦可以直接拎佢嘅 block-parallel 解碼行為做案例。

重點摘要

  • 約 16.7B 參數 MoE 擴散 GUI Agent,由 Inclusion AI、Ant Group Venus Team 與西湖大學共同發表
  • 骨幹為 LLaDA2.0-mini-base 配合 SigLIP 初始化嘅動態解像度 ViT
  • 六個 GUI 基準全部超越 Qwen2.5-VL-7B,ScreenSpot-Pro 等四項高過 Qwen3-VL-8B
  • 訓練涵蓋 100+ 中文與 70+ 英文手機 App,覆蓋 mobile、desktop、web、grounding
  • 附帶針對 block-wise 擴散解碼嘅分析,包括結構化動作有效性、EOS、denoising 步數等

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, UI/UX

Ambient CSS 用物理光照重新定義 box-shadow

一個以光線方向驅動嘅 CSS 工具庫,唔再需要逐個元素微調 shadow-sm、shadow-lg,所有陰影同邊緣高光會跟住同一個光源自動生成。

A hardware panel raytraced in Blender, rotating to a flat-on view, then wiped across to reveal the same panel rendered b

Ambient CSS 最大嘅改變係將 UI 表面當作真實物料嚟處理。傳統嘅 CSS 陰影階只係裝飾,卡片用 shadow-lg、掣用 shadow-sm,兩個元素之間並無物理關係。呢個工具庫引入咗 key light 同 fill light 兩盞光源嘅概念,所有陰影、邊緣高光、表面漸層都由同一組 CSS 自訂屬性推算出嚟。當你改變容器嘅光線方向,底下每一個子元素都會即時跟住調整,唔使逐個改。

引擎將每個元素拆成五層 box-shadow 合成:方向性嘅 drop shadow、面對光源嘅 fillet 高光、背光邊嘅 fillet 暗影、斜面嘅 chamfer 高光同暗影,加埋材質表面嘅漸層。表面類型分 flat、concave、convex 三種弧度,邊緣可以揀 chamfer、fillet 或 groove,仲有 matte、shiny、glass 呢幾種材質,最後用 elevation 0–3 控製投影高度。所有參數都係用 Blender raytrace 嘅結果做標定。

對一般開發者嚟講,安裝同整合都幾直接。純 CSS 版可以喺 HTML 直接掛入,框架版本分別支援 Tailwind、PureCSS、React 同 React-Bootstrap。命名空間用 .ambient 做容器、再用 .amb-surface、.amb-chamfer-2 等工具類調整細節,常用距離值跟 12/20/32 mm 嘅間距比例,避免頁面入面出現零碎數值。Demo 頁面將 Blender raytrace 同 live DOM 並排展示,幾容易睇出差距。

重點摘要

  • 將 UI 視為真實光照環境,所有陰影、高光、表面漸層由統一光源參數衍生
  • 每個元素由五層 box-shadow 合成,包含 drop shadow、fillet 同 chamfer 嘅高光與暗影
  • 表面類型(flat/concave/convex)、邊緣類型(chamfer/fillet/groove)、材質(matte/shiny/glass)同 elevation 0–3 可自由組合
  • 參數以 Blender raytrace 結果做物理標定,唔係靠肉眼調較 blur 值
  • 支援 PureCSS、Tailwind、React、React-Bootstrap 幾種整合方式

對需要管理大量卡片、面板、控制台介面嘅團隊嚟講,呢套系統可以避免每個設計師各自調較 shadow 嘅問題。對於追求像素級一致嘅硬件風格介面、儀表板或產品頁,效果會特別明顯;但若然你嘅介面本來就偏好扁平設計、唔需要表面弧度嘅呈現,呢層物理光照帶嚟嘅額外 box-shadow 開銷同學習成本就未必值得。

項目主頁 · GitHub

Categories: 開源, 框架, 工具, 庫, UI/UX

UI-Venus:多平台介面的高性能代理

UI-Venus 是一個針對手機、桌面和網頁介面的 GUI agent,重點處理視覺定位與互動導航。它用 35 萬筆專業標註資料和 RFT 提升長流程操作與跨平台泛化。

UI-Venus Performance Across Datasets

UI-Venus 是一個 GUI agent,直接面向手機、桌面和網頁介面,目標是解決看得懂畫面、點得準位置、又能沿著多步驟流程完成任務這幾個卡位。它把 Reinforcement Fine-Tuning(RFT)放進訓練流程,令動作預測不只是識判斷,仲可以連住環境回饋去修正下一步。

項目提供 7B 同 72B 兩個 checkpoint,亦交代咗評估流程同推理腳本,方便按截圖、標註檔同模型路徑去做測試。不過原始資料未提供完整安裝細節同實際部署步驟,較合理的理解係先用它的推理與評估流程驗證在 ScreenSpot-Pro、OS-World-G、AndroidWorld 等基準上的行為。

它的賣點不只是識辨認介面元件,而係把 credit assignment 放到長鏈路任務入面處理,令代理在連續操作時較易對齊目標。官方聲稱它在 AndroidWorld、ScreenSpot-v2、UI-Vision 同相關跨平台基準有競爭力,對需要自動化操作、界面導航同複雜任務拆解嘅團隊會較有吸引力。

  • 針對 GUI 理解同 action prediction,覆蓋 mobile、desktop、web 三類場景
  • 以 350K 高質量、專業標註樣本訓練,並加入 RFT
  • 提供 7B 與 72B checkpoint,以及評估和推理腳本
  • 強調長流程任務的 credit assignment,適合多步驟互動工作
  • 基準表現覆蓋 AndroidWorld、ScreenSpot-Pro、OS-World-G 等項目

對要做介面代理、手機自動化、網頁操作或桌面工作流整合的團隊,UI-Venus 比較像一個可以直接拿去評估能力邊界的基礎模型。它的限制亦清楚:原始資料未交代完整安裝與落地流程,實際接入時仍要按你手上的環境、介面類型同任務難度再做驗證。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, UI/UX

Ox Alpha 百萬 Token 上下文免費試用

Z.ai 最新模型 Ox Alpha 提供 1M-token context window,讓大型程式碼庫、圖像與影片可在同一個推理流程中處理。

Og image

面對大型程式碼庫、長篇規格文件或連續多步工作,Ox Alpha reasoning model(推理模型)可把最多 1M-token context window 的內容放在同一個脈絡中處理,減少反覆切分資料或遺失前文。它亦支援文字、圖像和影片輸入,適合除錯、重構及分析截圖或介面流程。

Ox Alpha 會先規劃和自我檢查,再產生答案,並以 visible thinking 展示推理過程。模型同時提供原生 tool calling、tool_choice,以及配合 response_format 的結構化 JSON 輸出,方便用於長時間運行的 agentic 工作流程。

網站列出的獨立測試涵蓋 10 項真實編程任務,Ox Alpha 完成 8 項,得分 80%;同一比較中,Fable 為 65%,GLM-5 為 62%,GPT-5 和 Grok 4 均為 52%。樣本只有 10 項任務,結果較適合作為參考,未足以代表所有編程場景。

• 1M-token context window,最高 131K tokens 輸出
• 支援文字、圖像和影片三種輸入
• 適合大型程式碼庫的 debugging 和 refactoring
• 原生 tool calling 與結構化輸出
• 免費試用、毋須登入,網站表示不會把聊天儲存在伺服器

項目主頁

Categories: Agentic, 模型, 多模態模型, Video, Image, 軟件, Python, 編程, 免費試用, UI/UX

Page 1 of 2
1 2