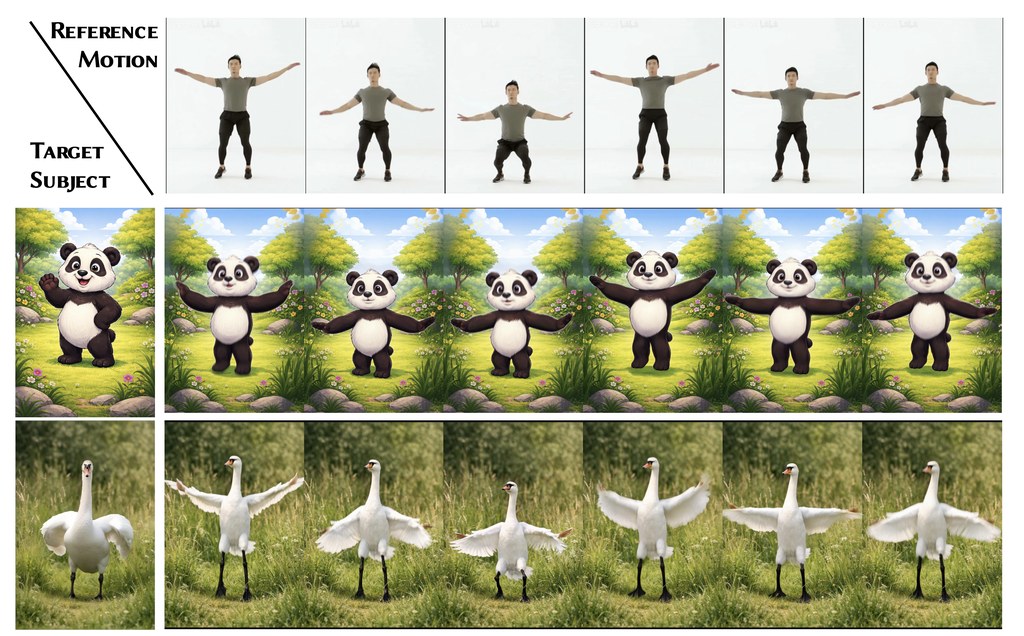
想為 AI 影片保留真人運鏡感,Film space 提供一個幾直接的方法。你可以先喺 3D 場景排位,再用 iPhone 把走位同鏡頭移動錄成參考片段。
拍 AI 風格化影片時,最難控制的往往唔係畫風,而係鏡頭點樣郁、人物點樣企。Film space 把呢個問題拆得幾務實:它屬於 3D 預演工具,用 iPhone ARKit 把你真實行走時的裝置移動,轉成可錄製的虛擬鏡頭路徑,之後再交畀 Seedance 2.0 呢類工具做 AI style transfer 參考。
它的定位唔係直接生成影片,也唔係完整剪接系統,而係補上 AI video workflow 入面最易失真的一段:先用虛擬 studio 做 blocking,再用手機走一次鏡頭。相比純文字提示詞或者只靠模型自己猜運鏡,Film space 換來的是更清楚的鏡頭方向感;代價是你需要親身拿住 iPhone 進行錄製,而且目前明顯偏向單機、裝置端流程。
部署方式:整個流程在裝置上完成,建議橫向畫面使用,錄好的片段會存入相簿,再帶去後續生成工具。場景編排包括棋盤地板、格線、座標軸,亦可加入 human stand-ins 來模擬人物站位;去到 Camera mode,手機的移動、轉向與傾斜會直接變成鏡頭運動,配合 35mm、50mm、75mm、200mm 焦段預覽,對做分鏡、音樂錄像、短片測鏡頭的人尤其有幫助。
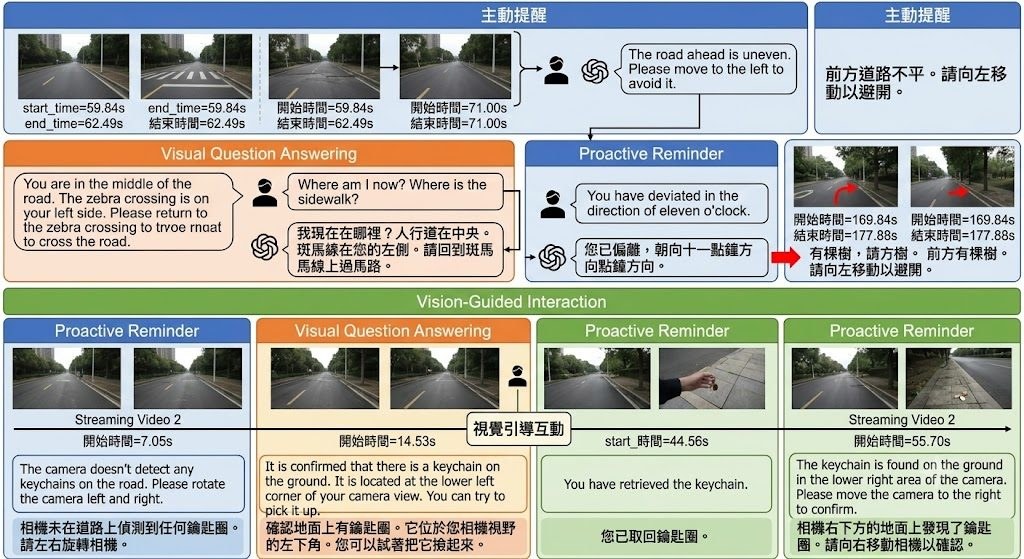
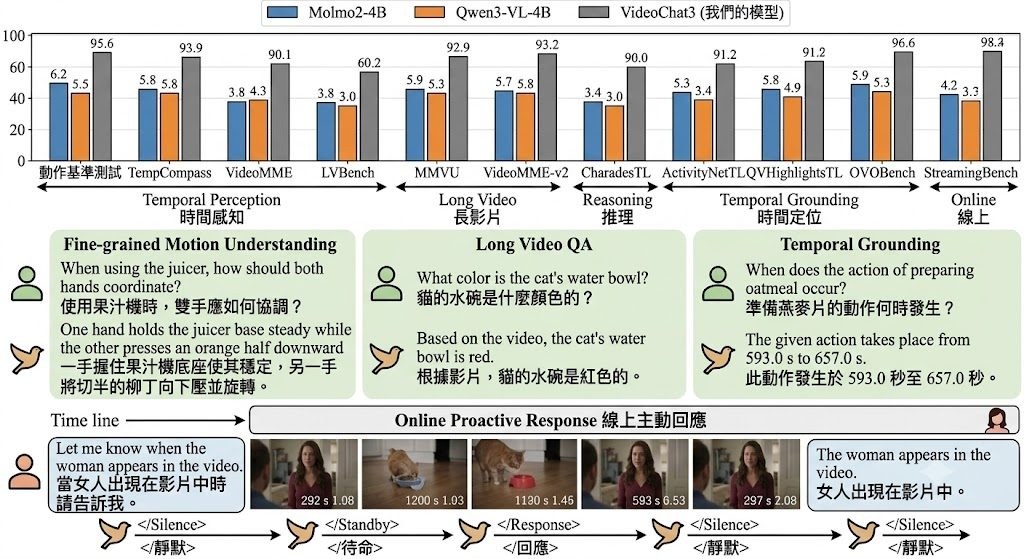
影片理解最麻煩的地方,往往唔係「識唔識睇」,而係要一邊保留動作細節,一邊捱得住長時間片段。VideoChat3 就係朝住呢個矛盾落手:它屬於多模態模型(Multimodal Large Language Model, MLLM),目標係用同一個 4B 模型處理細微動作、長片推理、temporal grounding 同 live streaming 回應。
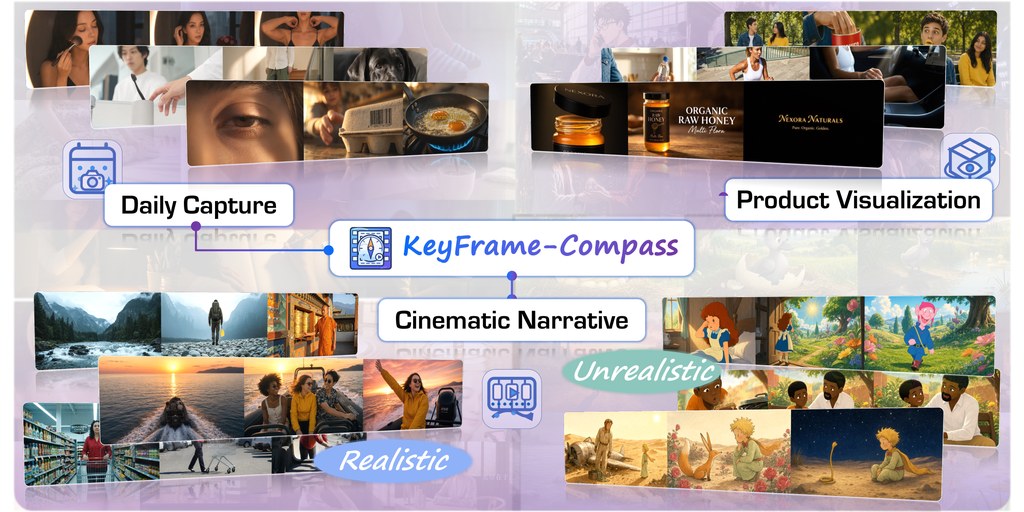
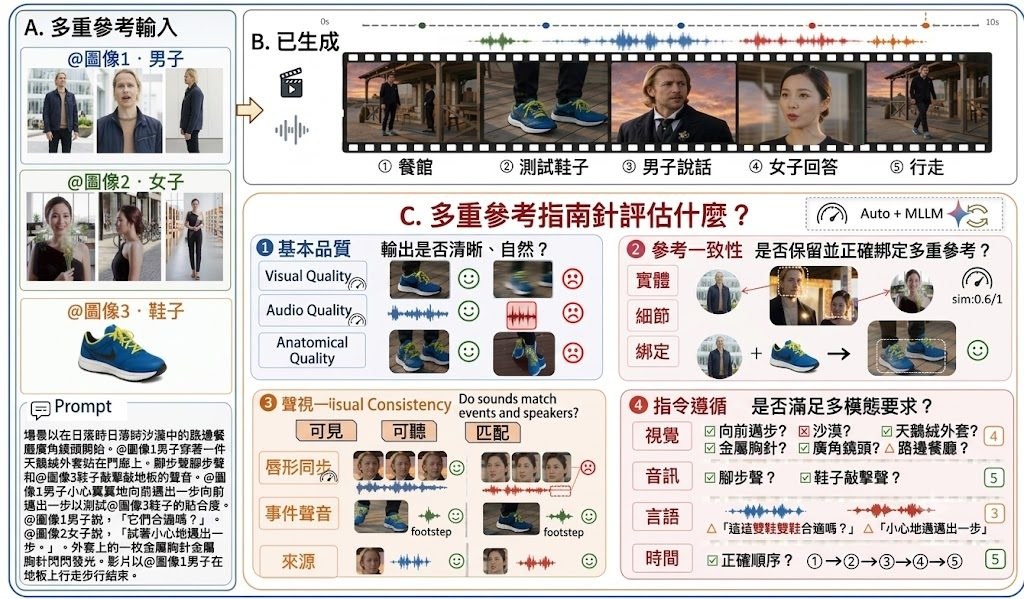
KeyFrame-Compass 是一個用來評測 keyframe-conditioned video generation 的基準項目,重點在於檢查模型能否同時跟住文字提示同一組按順序排列的 keyframes 生成影片。對做影片生成的人來說,這類測試最有價值的地方,是它不只看成片好不好看,還會追問畫面有沒有真係按要求出現、順序有沒有走樣。
這個項目把評測拆成兩層:一層看 keyframe execution,包括關鍵畫面存在、視覺還原、時間順序、定位、持續性同回應唯一性;另一層看 overall video quality,會用 evidence-grounded MLLM(Multimodal Large Language Model, MLLM)判斷,加上專門的感知模型去量度視覺質素、時間連貫性、指令遵從同音訊表現。這種分法比單純比對整體分數更清楚,因為它能分辨出模型係「畫得靚」定「跟得準」。
機械人控制最難受的地方,常常不是動作生成本身,而是模型一邊理解畫面、一邊預測未來場景時,推理成本高到難以閉環運作。GigaWorld-Policy-0.5屬於 World Action Model(WAM),重點是保留未來視覺動態對訓練的幫助,但在執行階段只解碼動作,減少為了生成未來影片而付出的額外開銷。
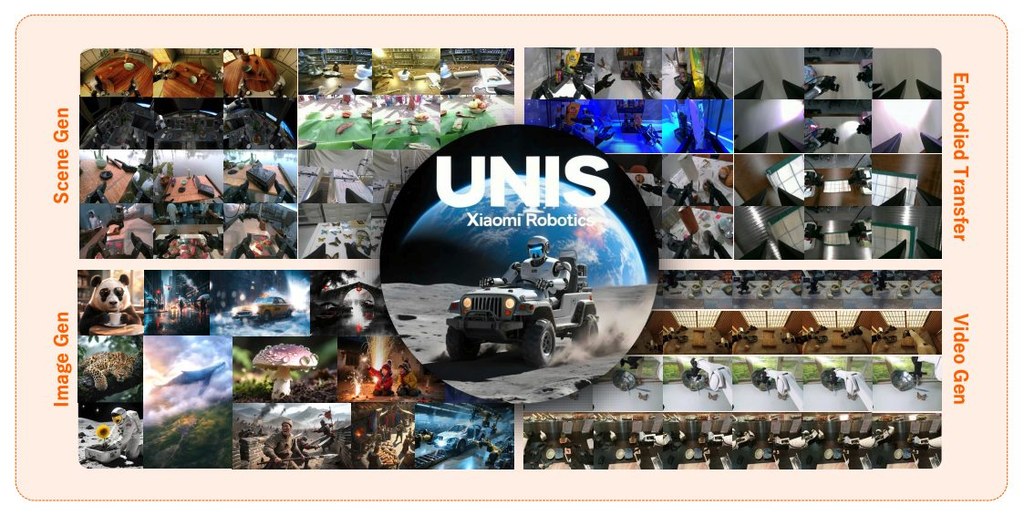
Xiaomi-Robotics-U0 屬於 world foundation model 路線,針對的正是這類 embodied synthesis 工作:一邊保留大型 image and video generation model 已學到的視覺知識,一邊補上機械人資料需要的可控性與一致性。
常見做法通常係用有限的機械人資料去微調 foundation model,但作者認為呢種範式容易犧牲大規模預訓練帶來的泛化能力。Xiaomi-Robotics-U0 改用 unified embodied synthesis 設計,把 text-to-image generation、image editing、embodied scene generation、embodied transfer 同 embodied video generation 放入同一個 38-billion-parameter multimodal autoregressive model 聯合優化,將 embodied generation 視為 foundation image and video generation 的延伸,而唔係另一條割裂的任務線。