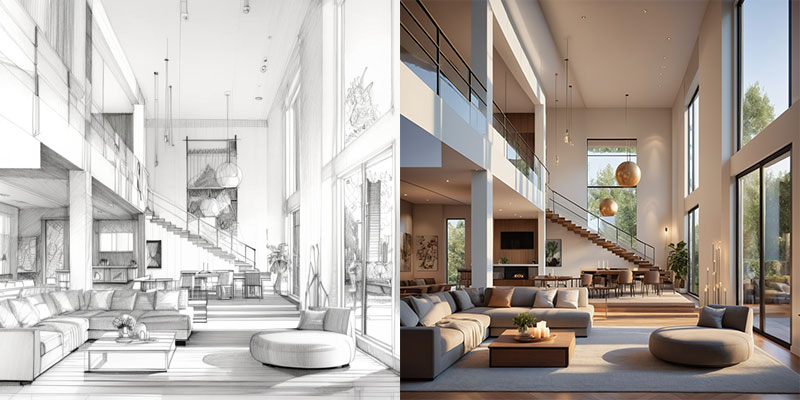
PromeAI – 使用終極 AI 藝術生成器釋放您的創意潛力。將草圖轉換為逼真的照片和高品質影片。從草圖、照片或文字生成令人驚嘆的 AI 藝術、3D 渲染、插圖、繪畫、標誌、動漫、逼真照片和影片。

PromeAI – 使用終極 AI 藝術生成器釋放您的創意潛力。將草圖轉換為逼真的照片和高品質影片。從草圖、照片或文字生成令人驚嘆的 AI 藝術、3D 渲染、插圖、繪畫、標誌、動漫、逼真照片和影片。

PromeAI – 使用終極 AI 藝術生成器釋放您的創意潛力。將草圖轉換為逼真的照片和高品質影片。從草圖、照片或文字生成令人驚嘆的 AI 藝術、3D 渲染、插圖、繪畫、標誌、動漫、逼真照片和影片。

新增了新版本的 BSRoformer 權重。目前它可能是世界上最好的可用模型。
按照您喜歡的方式設計角色,保留一致外觀於不同場景
GPT-SoVITS 開源語音合成,支援 5 秒零樣本與 1 分鐘少樣本克隆,提升聲音相似度。支援中英日跨語言推理,提供 WebUI 工具及 Windows 預打包檔,方便快速建置語音模型。
功能:
如果你是 Windows用戶(已在 win>=10上測試),可以直接通過預打包文件安裝。只需下載預打包文件,解壓後雙擊 go-webui.bat 即可啓動 GPT-SoVITS-WebUI。預訓練模型
從 GPT-SoVITS Models 下載預訓練模型,並將它們放置在 GPT_SoVITS\pretrained_models 中。
對於中文自動語音識別(另外),從 Damo ASR Model, Damo VAD Model, 和 Damo Punc Model 下載模型,並將它們放置在 tools/damo_asr/models 中。
對於UVR5(人聲/伴奏分離和混響移除,另外),從 UVR5 Weights 下載模型,並將它們放置在 tools/uvr5/uvr5_weights 中。
數據集格式
文本到語音(TTS)注釋 .list 文件格式:
vocal_path|speaker_name|language|text
語言字典:
示例:
D:\GPT-SoVITS\xxx/xxx.wav|xxx|en|I like playing Genshin.
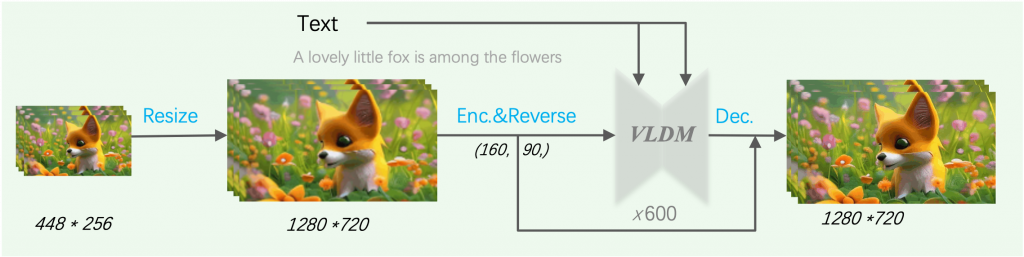
「MS- Video-to-Video」係一種深度學習模型,可以將一段視頻轉換成另一種風格、場景轉換、動作等操作。例如,可以將一段日本動畫轉換成中國水墨畫風格,或者將一段街頭表演轉換成動畫風格。 MS-Vid2Vid-XL 和 Video-to-Video 第一階段相同,都是基於隱空間的視頻擴散模型(VLDM),且其共享相同結構的時空UNet(ST-UNet),其設計細節延續我們自研 VideoComposer,具體可以參考其技術報告。

「MS- Video-to-Video」係一種深度學習模型,可以將一段視頻轉換成另一種風格、場景轉換、動作等操作。例如,可以將一段日本動畫轉換成中國水墨畫風格,或者將一段街頭表演轉換成動畫風格。
MS-Vid2Vid-XL 和 Video-to-Video 第一階段相同,都是基於隱空間的視頻擴散模型(VLDM),且其共享相同結構的時空UNet(ST-UNet),其設計細節延續我們自研 VideoComposer,具體可以參考其技術報告。
PromeAI 十分類似 RunwayML。除一般 txt2img、txt2video(暫時完全免費)、img2video 功能,亦提供料多種創意模式: AI Supermodel Generation – 上傳一張人體模型或業餘人像照片,馬上可建立多種風格和背景。目前版本支援個人真人照片或帶有臉部和四肢的照片。 Creative Fusion – 將草圖與藝術風格融合,創造出獨特且令人驚嘆的藝術品。而且可調整強度以控制影像與所選樣式之間的混合程度。 Background Diffusion – 自動移除背景並根據模板或文字產生理想的背景。而且您可以調整主要部分的大小和位置,以獲得更理想的效果。 Image Variation – 這是 img2img,產生具有相似風格、佈局、視角和感官體驗的圖像。而且您可以控制相似度。 Outpainting – 根據比例或尺寸擴展圖像內容。而且您可以調整原來相片的位置來控制擴展方向。 避免一次將面積擴大太多。
PromeAI 十分類似 RunwayML。除一般 txt2img、txt2video(暫時完全免費)、img2video 功能,亦提供料多種創意模式:
AI Supermodel Generation – 上傳一張人體模型或業餘人像照片,馬上可建立多種風格和背景。目前版本支援個人真人照片或帶有臉部和四肢的照片。
Creative Fusion – 將草圖與藝術風格融合,創造出獨特且令人驚嘆的藝術品。而且可調整強度以控制影像與所選樣式之間的混合程度。
Background Diffusion – 自動移除背景並根據模板或文字產生理想的背景。而且您可以調整主要部分的大小和位置,以獲得更理想的效果。
Image Variation – 這是 img2img,產生具有相似風格、佈局、視角和感官體驗的圖像。而且您可以控制相似度。
Outpainting – 根據比例或尺寸擴展圖像內容。而且您可以調整原來相片的位置來控制擴展方向。 避免一次將面積擴大太多。
(more…)人工智慧的力量正進入第三維度。 使用提示產生 3D 物件、動畫和紋理。 在人工智慧的幫助下,更快地設計並觀看您的想法變為現實。
人工智慧的力量正進入第三維度。 使用提示產生 3D 物件、動畫和紋理。 在人工智慧的幫助下,更快地設計並觀看您的想法變為現實。
(more…)Audiobox 是 Meta 的新音訊生成基礎研究模型。 集 TTS、聲效、音樂於一身。它結合使用語音輸入和自然語言文字提示來產生語音和聲音效果,從而可以輕鬆地為創建任何音訊。 Audiobox 模型系列亦包括專業模型 Audiobox Speech 和 Audiobox Sound,所有 Audiobox 型號都基於共享的自我監督模型 Audiobox SSL 構建。 馬上體驗 – 多種聲效 – 創作故事
Audiobox 是 Meta 的新音訊生成基礎研究模型。 集 TTS、聲效、音樂於一身。它結合使用語音輸入和自然語言文字提示來產生語音和聲音效果,從而可以輕鬆地為創建任何音訊。 Audiobox 模型系列亦包括專業模型 Audiobox Speech 和 Audiobox Sound,所有 Audiobox 型號都基於共享的自我監督模型 Audiobox SSL 構建。
Genmo 致力於建立跨模式創作和分享生成藝術的工具。 我們正在推動生成模型能力的前沿。 如今的免費平台只需單擊即可社交創作無限量的影片。 Genmo 目前處於測試階段,將來會添加更多內容。 免費版可生成最長 6 秒 2304 x 1280 的高清影片。 亦可控制鏡頭的運鏡方式 除此,Genmo 亦提供生成圖片,文字對話等。
Genmo 致力於建立跨模式創作和分享生成藝術的工具。 我們正在推動生成模型能力的前沿。 如今的免費平台只需單擊即可社交創作無限量的影片。 Genmo 目前處於測試階段,將來會添加更多內容。
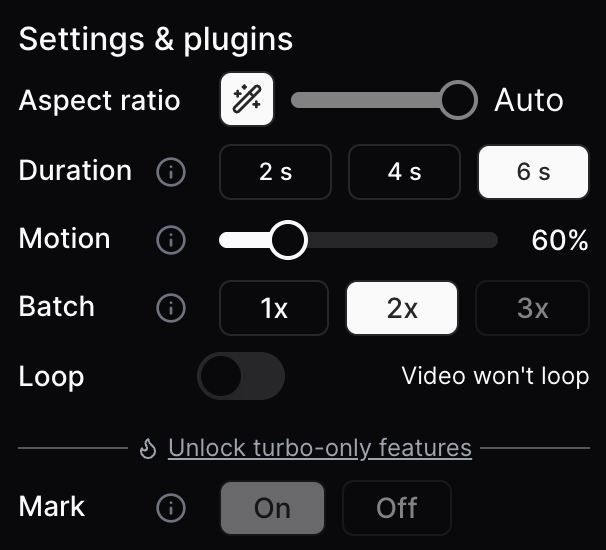
免費版可生成最長 6 秒 2304 x 1280 的高清影片。

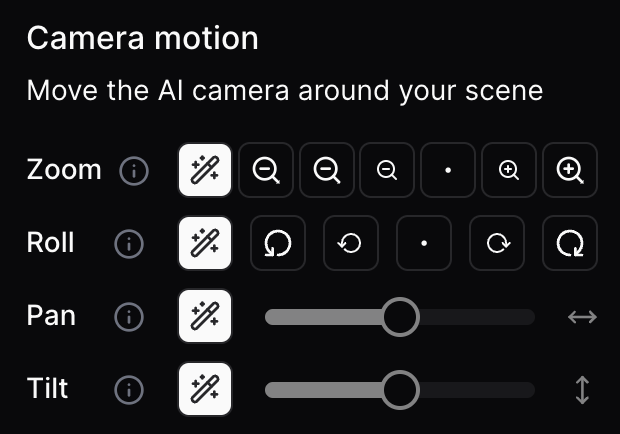
亦可控制鏡頭的運鏡方式

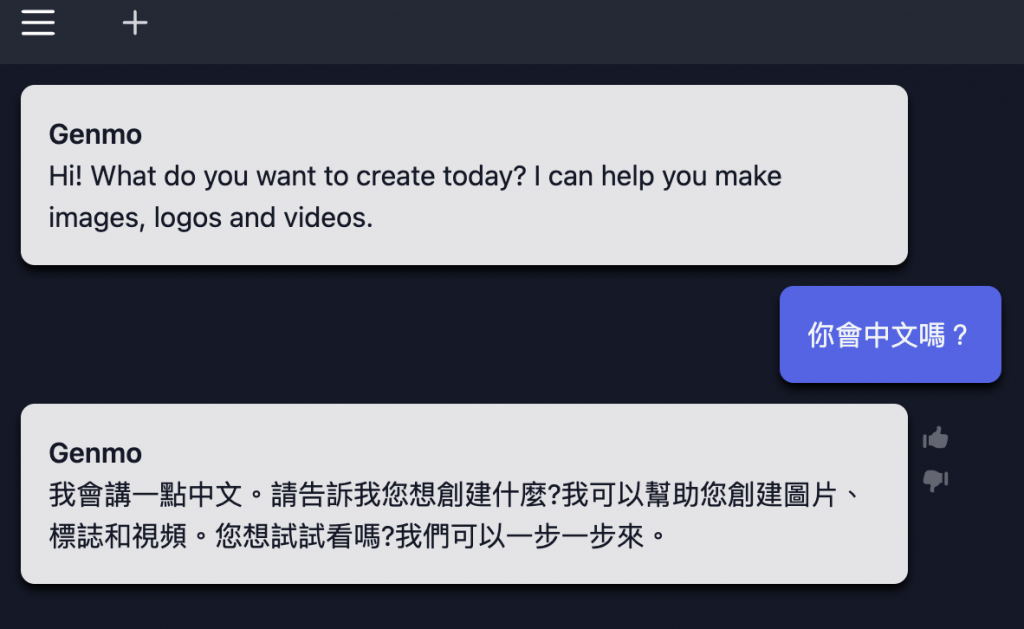
除此,Genmo 亦提供生成圖片,文字對話等。