HDR mini-skill 讓 AI 片由 SDR 轉為 HDR

纯 ffmpeg + 自己生成的 3D LUT,不依赖 zscale / libplacebo / drawtext(Homebrew 的 ffmpeg 常常没带)。

Repository image for limin112/min-skill

把普通(SDR)視頻或其中一段,轉成 10-bit HEVC / HLG / BT.2020 的 HDR 文件:在 HDR 屏幕上,雲、太陽、水面反光、 金屬高光會“發光”。還能做左右對比:同一個文件里左邊 SDR、右邊 HDR。

  • 輸出 HLG HDR、10-bit HEVC 及 SDR/HDR 對比片。
  • 效果取決於素材。 米色卡片、文字、PPT 這類畫面轉成 HDR 只是把“紙”變亮,不適合。
  • 只有在 HDR 屏(Mac XDR、iPhone)上用 QuickTime 才有效果;普通播放器里會發灰、紅偏橙,這是正常的。
  • 原片已經是 HDR 的,腳本會拒絕(退出碼 2)。
  • 沒在真正的 HDR 屏上做過觀感驗證,也沒驗證過上傳各平台後是否保持 HDR;詳見 SKILL.md 末尾“已驗證 / 沒驗證”。

GitHub

Categories: 開源, 文字轉語音, AI productions, 數字人, 模型, Video, 框架, 工具, Content Creator, 3D, 庫, 語音, Anthropic, MiniMax, Skill 技能, LoRA

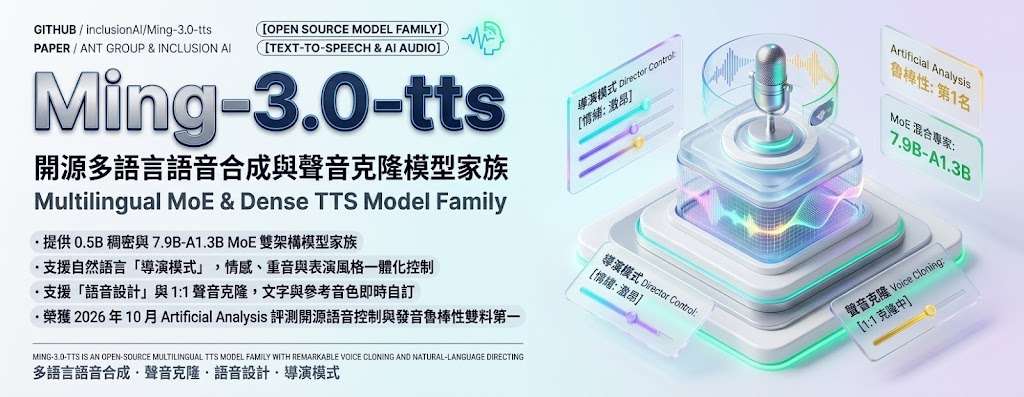
Ming-3.0-tts:0.5B 優化講東話語音合成、語氣控制!

需要複製聲線、調整情緒,或按劇本生成多角色對話時,Ming-3.0-tts 提供多種控制方式,並支援多種語言與方言。

Ming-3.0-tts Logo

要為短片配旁白、製作有情緒起伏的角色對白,或生成多角色 Podcast,Ming-3.0-tts 都提供相應能力。這個開源語音生成模型項目支援中文、英文等七種語言,以及廣東話和四川話兩種方言;使用者可克隆參考聲線、用文字描述設計音色,亦可用自然語言指示演繹方式。

支持中文、英文、德文、西班牙文、法文、韓文和日文語音,亦可選擇四川話或廣東話;語速、音高和音量也可以調整。項目提供兩個模型:0.5b 是 dense model,tiny 則是建基於 Ling V3 的 MoE model,總參數量為 7.9B、每次啟用 1.3B。只有 tiny 支援按劇本和參考聲線生成多說話者對話。

兩個模型各有取捨。0.5b 在廣東話 Base CER、ACC,以及部分情緒和屬性控制指標取得領先;tiny 在多項多語言、聲線相似度和播客測試中排名靠前。不過,部分歷史紀錄仍由 Ming-omni-tts 保持,例如播客 CER;tiny 的韓語準確度、音高控制和角色扮演指令遵循能力,亦列為後續改善方向。

模型支持聲線複製、自然語言控制及多角色對話。適合需要製作多語言旁白、有聲內容或角色語音的創作者和開發團隊;若工作依賴特定方言的聲線相似度,或要求穩定遵循複雜角色指令,仍應先用目標語料自行驗證。

  • 可用文字設計語氣聲線或選用內置中英文聲線。
  • 支援 14 種中文或英文語氣標籤,以及情緒、語速、音高和音量控制。
  • tiny 可按劇本生成多說話者對話;0.5b 不具備這項功能。
  • 公開測試涵蓋方言、多語言、情緒、屬性控制和播客,兩個模型的領先項目各有不同。
  • ComfyUI 整合

項目主頁 · GitHub · 模型

Categories: 開源, 文字轉語音, 模型, Content Creator, 語音, 廣東話

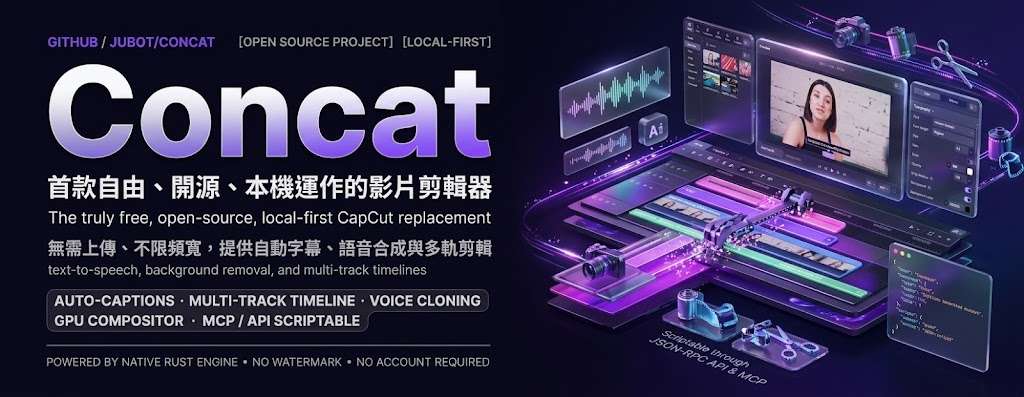
CapCut 以外,Concat 把影片剪輯搬回本機

想剪片但不想上載素材、註冊帳戶或處理浮水印?開源影片編輯器 Concat 提供本機字幕、語音與多軌剪輯功能。

Concat

剪短片、上字幕、替換背景,卻不想先建立帳戶,把原片交給雲端平台處理,Concat 提供了另一條路。這個跨平台開源影片編輯器把自動字幕、文字轉語音、聲音複製、背景移除、多軌剪輯及 4K 匯出放進同一個介面,支援 macOS、Windows、Linux 與 Android。

Concat 屬於桌面及流動裝置影片編輯工具,核心特色不是追求完整取代所有專業軟件,而是針對 CapCut 常用的剪輯流程,減少上載素材及依賴訂閱的摩擦。自動字幕由本機 Whisper 處理,選擇模型大小後即可把字幕放上時間軸,再配合文字轉語音、關鍵幀動畫、特效及標題完成內容製作。

這項取捨十分清楚:素材可完全留在本機,離線工作,不會因平台政策改變而失去作品控制權;但代價是本機運算能力會直接影響字幕生成等功能的處理速度。Concat 亦提供語音複製,只需數秒錄音便可建立聲音,適合處理旁白、角色對白及多語言版本,背景移除則涵蓋人物、物件,亦可自行修正遮罩。

  • 支援 macOS、Windows、Linux 及 Android
  • 本機 Whisper 自動字幕,無須上載影片
  • 提供文字轉語音、聲音複製及背景移除
  • 支援多軌剪輯、關鍵幀、特效、標題與 4K 匯出
  • 無浮水印、無需帳戶,亦沒有上載限制或訂閱費用

對內容創作者、獨立製作者、教育工作者及需要處理敏感素材的團隊而言,這是一套頗完整的本機工作流。多軌剪輯、位置、縮放、旋轉、透明度及音量關鍵幀控制,令它不只停留在簡單裁片工具;惟目前版本號仍為 0.2.8,跨平台的成熟度、介面細節及不同裝置上的匯出表現,仍須經實際作品驗證。

GitHub

Categories: 開源, 文字轉語音, AI productions, 模型, Video, Audio, 軟件, 工具, Content Creator, Mac, Linux, 語音, 動畫

騰訊混元開源 AuK:1.5B 模型統一語音生成與編輯

騰訊混元把零樣本 TTS、語音編輯、分離與增強收進同一個自然語言指令介面,並同步釋出追求速度的蒸餾版本 AuK-Flash。

AuK performance across speech generation, editing, enhancement, and separation benchmarks

語音模型一直存在一個尷尬:零樣本合成、語音克隆、音色替換、分離、降噪往往是幾套獨立系統,要串起來就得堆 pipeline。騰訊 Hunyuan 開源的 AuK 想打破這個分工,以 1.5B 參數的基礎模型為核心,讓一句自然語言指令直接對應到編輯後或生成的音訊。

AuK 由三部分組成:負責語義條件的多模態語言模型、提供聲學潛在空間的 50 Hz VAE,以及一個混合 rectified-flow Transformer,用雙流 MMDiT 塊融合兩種條件後再做單流 DiT 生成。訓練數據規模相當可觀——約 30.3 億條指令-音訊配對,加上約 195 萬小時的有效監督,覆蓋五大任務族:語音生成、內容編輯、增強與分離、副語言資訊編輯、聲學編輯。

同步釋出的 AuK-Flash 走速度路線:透過一致性初始化加上任務路由的 Decoupled DMD 蒸餾,做到 NFE=4、無 CFG 的 4 步推論,官方指在匹配條件下對比完整 AuK 有約 4.5 倍 wall-clock 加速,質量接近教師模型。這個分層策略對需要即時語音生成的應用場景(如對話 agent、實時配音)有直接意義。

部署層面,官方同時提供 Hugging Face Space、ModelScope Space、Gradio 互動介面、ComfyUI 節點、Python API,以及 uv 和 Conda 兩種依賴管理方式,並已獲 SGLang-Omni Day 0 支援。對於本地資源有限的團隊,AuK-Flash 配合 SGLang-Omni 是較合理的切入點;如果追求最高質量、且不在意推論延遲,則可選 AuK Base,並透過可配置的 NFE 與 CFG 做品質/速度取捨。

重點摘要:

  • 1.5B 統一模型:用自然語言指令統一零樣本 TTS、語音編輯、分離、增強、副語言與聲學編輯。
  • 三模組架構:多模態語言模型 + 50 Hz 音訊 VAE + 混合 rectified-flow Transformer,採雙流 MMDiT 接單流 DiT。
  • AuK-Flash 蒸餾:一致性初始化 + 任務路由 DMD,4 步推論無需 CFG,wall-clock 加速約 4.5 倍。
  • 後訓練策略:語音生成用獎勵強化學習,開放式編輯用人類偏好優化。
  • 部署支援完整:Hugging Face、ModelScope、Gradio、ComfyUI、Python API、SGLang-Omni 齊備。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, 文字轉語音, ComfyUI, Agentic, 模型, 多模態模型, 模型訓練, API, Audio, Python, 語音

anything2explainer:把任何主題變成科普影片

它不是 CLI,而是一套交給 AI 編碼 agent 用的方法包:從研究、旁白、字幕到分鏡,都用 Remotion 寫成 React 元件,產出可逐幀追溯的解說影片。

Repository image for Vincentwei1021/anything2explainer

當你丟一個主題或一篇文件給它,系統會先做資料蒐集並標註來源,再寫旁白、生成 TTS 語音,並把時間軸對齊到逐個鏡頭。接著多個建構 agent 平行運作,每個負責一個 Remotion(React + TypeScript)元件,QC agent 再依書面標準審查每一幀。輸出是 1280×720 H.264 MP4,配上字幕、章節卡與進度條,全程沒有現成影片或生成式影像模型的痕跡。

這套流程對創作者的最大意義在於可追溯。每個鏡頭都有自己的原始碼、QC 報告與研究文件,螢幕上出現的年份、數字、英文術語都要對得到來源 URL;live-action B-roll 也強制記錄在 MANIFEST 裡,附上 sha256、來源與授權。這種「紙本文書鏈」對需要審核的場景——例如企業內訓教材或品牌內容——比多數 AI 影片工具更有交代。

在同類做法裡,它明顯偏向工程化交付而非即興 demo。Remotion 元件庫、燈光與樣式規格、多 agent 協作協議都以可複用資產形式提供,並用一段完整的參考影片作為品質基準。對會寫程式、需要大量長版講解影片但又受版權與準確性束縛的團隊——例如 SaaS 團隊做產品教學、研究單位做技術普及——會比較感受到它的價值。

限制同樣明顯:不是 CLI,必須搭配 Claude Code 或 Codex 這類 agent 環境;TTS 要自備並處理對齊;中英文以外語言未提及支援;整個流程壁鐘 1 到 3 小時,瓶頸在並行建構鏡頭的數量與長度。授權採 PolyForm Noncommercial,商用前要先看清楚。

重點摘要

  • 全程程式碼繪製:用 Remotion 寫 React 元件產出每一幀,沒有生成式影片模型或現成素材。
  • 可審核的紙本文書鏈:研究文件、旁白、分鏡、鏡頭原始碼、QC 報告全部保留。
  • 多 agent 平行建構:研究、旁白、語音、分鏡後,由多個 agent 同時寫鏡頭元件,QC agent 再逐幀複查。
  • 多語言旁白:支援中文與英文,TTS 需自備並做強制對齊。
  • 非商業授權:採用 PolyForm Noncommercial,商用情境需自行評估。

GitHub

Categories: 開源, 文字轉語音, Agentic, AI productions, OpenAI, Video, Image, 工具, Content Creator, 庫, 語音, Anthropic, 動畫, Skill 技能

FireRedTTS3:廣東話與各地方言內容創作,覆蓋 24 種語言與 21 種方言

FireRedTTS3 是把零樣本克隆、語音編輯、聲線設計整合進同一個模型的開源 TTS 項目,支援 24 種語言及 21 種中文方言,亦可純靠文字描述生成全新聲音。

做多語言配音或本地化短片時,最麻煩往往不是翻譯,而是要為每種語言找一個聽起來自然的聲線,又要顧及四川話、閩南話、上海話等方言差異。FireRedTTS3 想處理的就是這個矛盾:它是一個統一式的語音生成框架,把零樣本聲線克隆、語音編輯、以自然語言設計全新聲線三件事放在同一個模型裡,靠的是語義增強的連續語音表徵。

項目分兩個版本。FireRedTTS3-Base 主打多語言克隆,覆蓋 24 種語言(包括粵語在內)以及 21 種中文方言;FireRedTTS3-Instruct 則做到純文字驅動的聲線設計,不需參考音頻,只要描述性別、年齡、音色、語速等特徵,就能合成全新聲音,並且支援語義層與聲學層的自由形式編輯,例如改寫某段對話、調整語速或音量。

相對同類做法,它的差異在於把克隆、編輯、聲線設計整合成單一流程,而非各自獨立訓練模型。在 MiniMax-MLS-Test 上平均 WER/CER 約 3.754%、說話人相似度約 84.8%;在 Seed-TTS-eval 上克隆 WER/CER 約 3.04%、相似度約 78.8%,從公開數字看在多語言與中文方言任務都做到當前較高的水準。

本地配音、廣東話與各地方言內容創作、Podcast 或短影片自動化產出,以及需要快速原型不同聲線的產品團隊,都比較容易受惠。程式碼以 PyTorch 開源,模型已上架 Hugging Face 與 ModelScope,可透過 Python API 呼叫,亦提供 Instruct API 處理聲線設計與編輯。

重點摘要:

  • 多語言零樣本克隆:覆蓋 24 種語言及 21 種中文方言,包括粵語、四川話、上海話、福建話等。
  • 統一語音生成框架:把克隆、聲線設計、語音編輯整合在同一模型內,避免切換多套工具。
  • 純文字聲線設計:以自然語言描述性別、年齡、情緒等特徵即可合成全新聲音,無需參考音頻。
  • 自由形式語音編輯:支援語義層改寫(插入、刪除、替換)及聲學層調整(語速、音量、音調)。
  • 開源易取用:PyTorch 實作、Apache 2.0 授權,模型於 Hugging Face 與 ModelScope 提供下載。
GitHub · 模型

Categories: 開源, 文字轉語音, AI productions, 模型, API, Video, Audio, 語音, 廣東話

OmniEvalKit:唔使重新訓練 VLM 都可以聽聲答問題

MBZUAI Oryx 團隊把 OmniEvalKit 開源出嚟,主打唔使改動 VLM 任何參數,就為佢加掛語音理解能力。對於想評估或部署多模態模型嘅團隊,可以直接拎現成骨幹即試。

Training-Free Omni

想為一個視覺語言模型加入語音理解,但又唔想重新訓練?MBZUAI Oryx 團隊開源嘅 OmniEvalKit(Training-Free Omni)就正正針對呢個痛點。它把語音先經 Whisper 抽取成帶時間戳、語言同信心分數嘅結構化文字,再連同圖片或影片幀一齊餵俾凍結嘅 VLM,所有推理都沿用原本嘅 prompt 接口,骨幹權重全程不動。換句話講,任何新嘅視覺骨幹都可以即插即用,毋須再做語音—視覺對齊微調。

它同時係一個統一嘅多模態評測框架,支援文字、圖片、影片、音頻同音視頻任務,並預載 118 個資料集適配器,涵蓋 Qwen、Gemma、MiniCPM、VILA、OmniVinci 等模型,方便做公平對齊測試。對研究人員同部署團隊而言,最直接嘅好處係可以一次過跑 56 個 benchmark、21 種語言,直接比較凍結骨幹同原生 omni 模型之間嘅差距,睇下語音能力究竟係新加出嚟定係由舊能力交換得嚟。

如果你關心 VLM 加掛語音後會唔會「失憶」,呢套框架正正提供 matched comparison,可以量化評估圖像理解、視覺定位、編碼、數學等原有強項有冇被削弱。額外支援嘅 CosyVoice3 文字轉語音輸出,亦令文本答案可以直接變成語音回覆。

要本地跑得起嚟,需要 Python 3.10+、ffmpeg,再針對 CPU、CUDA 或 ROCm 安裝對應嘅 PyTorch。之後透過 eval.sh 配環境變數指定模型同資料集即可開跑,加 MAX_SAMPLES=3 可以做煙霧測試,中斷後設 RESUME=True 可以接返。

以下係幾個值得留意嘅重點:

  • 凍結骨幹、零微調:所有 VLM 權重完全不變,語音理解透過 Whisper 抽取文字證據再加 prompt 融合達成。
  • 即插即用嘅 omni 能力:支援 Qwen2.5-Omni、Gemma、MiniCPM、VILA、OmniVinci 等多個模型適配器,方便横向比較。
  • 覆蓋廣嘅評測矩陣:內置 118 個資料集適配器,涵蓋 56 個 benchmark 與 21 種語言。
  • 原生 omni 同凍結骨幹嘅 matched 對照:可以清晰分辨新增能力同保留能力,避免重訓帶嚟嘅 capability drift。
  • 可選語音回覆:透過 CosyVoice3 把文字答案合成語音輸出,適合對話式場景。

項目主頁 · GitHub

Categories: 開源, 文字轉語音, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, Image, 框架, Python, 語音, Dataset 數據集

Hojo TTS Light 輕量語音合成,4000 萬參數就做到 15 種聲線

Hojo-TTS-Light 僅約 0.08B 參數,以 ONNX 格式在 CPU 即時合成 24 kHz 語音,並預載 15 種聲線,免依賴 PyTorch。

Og image

想把文字轉語音(TTS)嵌入邊緣裝置或本地腳本,最大阻力往往來自 PyTorch 依賴肥大、GPU 門檻高。Hojo-TTS-Light 直接以 ONNX Runtime 執行,連 PyTorch 都不用安裝,對只有 CPU 或資源受限的環境相當友善。模型檔約 4000 萬參數(0.08B),輸出 24 kHz 音訊,並內建 15 種預設說話人聲線,開發者只需切換 embedding 即可換聲,省下自行收集語料或微調的工序。

隨倉提供的 infer.py 與 onnx_model.py 展示完整推理流程,搭配 requirements.txt 即可用幾行程式碼完成合成。對需要快速在本地或伺服器側加入語音回饋的項目而言,這種「開箱即播」的設計,比傳統 TTS pipeline 更貼近部署需求。

不過,15 種聲線屬於 preset 性質,若要新增自訂說話人,就需要額外準備參考音訊與對應 embedding,無法像大型 TTS 模型那樣靠一句話克隆。整體取向偏向「輕量、即用」,而非追求擬真度或表現力。

重點摘要:

  • 參數量約 0.08B,屬輕量級 TTS 模型
  • 採用 ONNX 格式,免安裝 PyTorch 即可在 CPU 環境執行
  • 預載 15 種 speaker-conditioned 聲線,可即時切換
  • 隨附 infer.py、onnx_model.py、requirements.txt,方便快速整合
  • 發佈平台為 Hugging Face,授權與權重可至該頁查閱

適合需要把語音合成嵌進邊緣裝置、CLI 工具或本地自動化流程的開發者;對追求高擬真或自訂聲線克隆的場景,則需要再評估擴充成本。

項目主頁

Categories: 開源, 文字轉語音, Agentic, Embedding, 模型, Audio, 語音, Skill 技能

Qwen-Audio Realtime API 上線:以 WebSocket 即時串接語音對話

阿里巴巴雲 Model Studio 推出 Qwen-Audio Realtime API,用 WebSocket 串流處理語音輸入與輸出,支援 VAD 偵測與雙向文字回傳,適合即時語音助理開發。

Og image

想在應用程式裡加入即時語音對話,但又不想自己串接一堆音訊前處理、ASR、TTS 的流程?阿里巴巴雲 Model Studio 這次直接把 Qwen-Audio 做成可即時呼叫的 Realtime API,開發者只要透過 WebSocket 連線,就能處理語音輸入、文字輸入,並即時收到串流音訊與文字回應。

這個 API 的設計重點在於「一條連線做完整件事」。客戶端與伺服器以 JSON 事件雙向溝通,支援語音活動偵測(VAD),讓系統知道用戶何時開始與結束說話,省去自行判斷靜音的麻煩。對話中的每一則訊息會以 conversation item 形式保存,整個 session(即一條 WebSocket 連線)則負責維護設定與上下文狀態。

服務端點分為中國(北京)與新加坡兩個區域,皆已改用 workspace-specific 專屬網域,官方表示穩定度與推論表現都比原本的共用網域更好。連線時需使用 wss:// 協定,並在 request header 帶上 Authorization: Bearer <your_api_key>,API key 會在 WebSocket 握手階段驗證,若無效會直接回 HTTP 401/403。

若你的項目是語音助理、即時翻譯、客服 robot 或電話自動化,會感受到整合成本明顯降低——不用分別串 ASR、LLM、TTS,只要管理好 WebSocket 的事件流即可。舊網域雖然仍可用,但官方強烈建議遷移至新網域以取得更佳體驗。

重點摘要

  • 即時雙向串流:WebSocket 連線同時處理音訊輸入與串流輸出,搭配 VAD 自動偵測語音起止。
  • JSON 事件溝通:所有互動以結構化事件傳遞,方便除錯與日誌記錄。
  • 雙區域專屬網域:中國(北京)與新加坡皆提供 workspace-specific 端點,穩定度與推論表現提升。
  • 簡化整合流程:免去自行串接 ASR、LLM、TTS 的負擔,適合快速建構語音應用。
  • 原有網域仍可用:但官方建議盡快遷移以享受新網域的效能改善。

項目主頁

Categories: 阿里巴巴, 文字轉語音, Qwen, API, Audio, Robotic, 語音, 中國

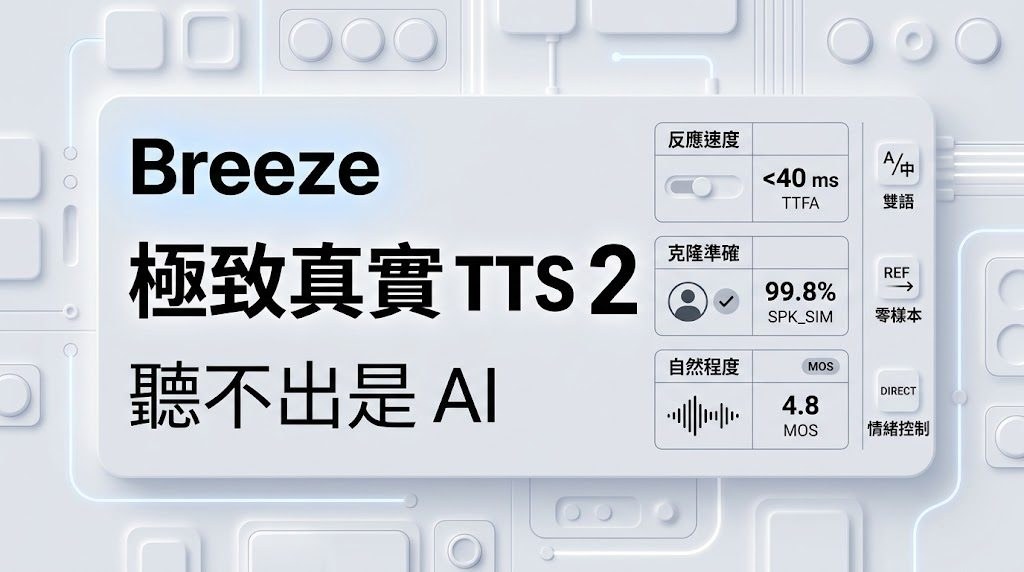
Breeze TTS 2 即時語音生成

Breeze TTS 2 主打即時語音互動,兼顧聲線設計、聲線模仿與低延遲串流。它把自然語言指令和參考音訊結合起來,令語音生成更靈活。

Og image

Breeze TTS 2 屬於 text-to-speech(TTS)模型,核心目標是把即時語音互動做得更自然,並同時處理聲線模仿、聲線設計和語氣控制。它基於自然語言指令,既可以用參考音訊去保留聲線特徵,也可以不靠參考音訊直接設計聲音,這令使用場景比一般單一路徑的 TTS 更廣。

模型權重只限研究與非商業用途,而原始程式碼則採用 Apache 2.0,這表示權重與程式碼的授權條款並不相同。

Breeze TTS 2 支援 Voice Clone、Voice Design、Voice Direction,同時提供 Vocal Events,讓使用者可在文字中加入 (laugh)、(cough) 之類的表現指令。頁面亦強調它有 ultra-low-latency streaming,適合需要即時回應的對話式語音互動。

重點主要集中在功能和評測定位,沒有提供 GGUF 檔案、mmproj、量化版本、檔案大小,亦未提到 llama.cpp、Ollama 或 LM Studio。只見到它在 Artificial Analysis TTS leaderboard 排名第一,並聲稱表現超越部分閉源前沿系統;但由於頁面未展示完整測試細節,較適合把它視為一個以互動延遲、可控性和聲線表現力作賣點的語音模型。

  • 支援參考音訊模仿,也支援純文字描述生成新聲線
  • 可以用文字內嵌事件控制笑聲、咳嗽等表現細節
  • 主打低延遲串流,適合即時語音互動
  • 權重屬研究與非商業用途,授權限制要先看清
  • 頁面未提供量化、GGUF 或本地推論框架資訊

模型

Categories: 開源, 文字轉語音, 模型, 語音

Page 1 of 3
1 2 3