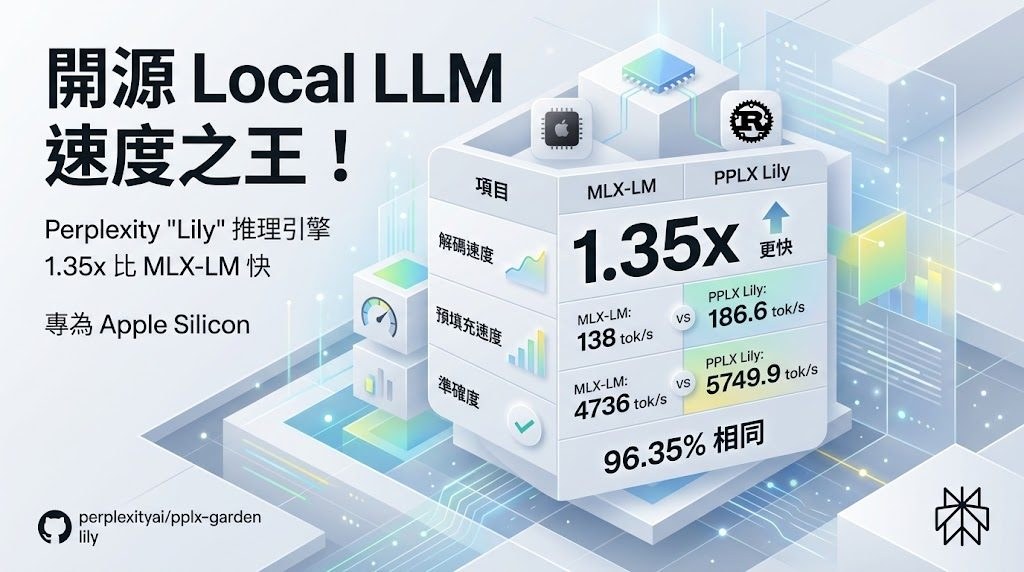
Perplexity 開源 Lily:Mac 本地推理專用提速引擎

Perplexity 推出針對 Apple Silicon 與 Qwen3.6-35B-A3B 的本地推論引擎 Lily,繞過 PyTorch 與 MLX,以 Rust 和自訂 Metal kernels 改善預填充及解碼效率。

Repository image for perplexityai/pplx-garden

當大型模型開始負責處理 Mac 上的私人檔案與應用程式,本地推論速度就不再只是開發者實驗的指標。Perplexity 開源嘅 pplx-garden 入面,Lily 以工具項目形式處理 Apple Silicon 上 Qwen3.6-35B-A3B 的推論,目標係令提示詞處理及文字生成更快,並透過 OpenAI-compatible HTTP API 串接聊天流程。

Lily 唔似 MLX-LM 般追求支援多款模型,而係集中服務 Qwen3.6-35B-A3B:Rust runtime 負責載入 checkpoint、管理 session state 同生成迴圈,自訂 Metal kernels 就處理模型特定運算。呢種單一進程、模型與 runtime 共同協調嘅做法,減少通用 kernel 帶來嘅額外調度,亦避開 PyTorch 和 MLX execution path。

pplx-garden 不只是 Mac 本地推論工具。fabric-lib 提供 RDMA TransferEngine,同時涵蓋 P2P MoE dispatch 與 combine kernel;pplx-unigram 則係針對 Unigram tokenizer 嘅 CPU encoder。相關內容亦包括 trillion-parameter model 喺 AWS EFA 上嘅部署,以及 RL post-training 權重轉移、分離式 prefill 和 decode 等系統研究,顯示儲存庫涵蓋由裝置端推論到分散式 LLM infrastructure 嘅多個瓶頸。

適合需要喺 Mac 處理敏感資料、又希望保留本地生成能力嘅開發者及研究團隊;需要 RDMA、MoE 溝通或 tokenizer 優化嘅系統工程人員亦可參考相關元件。現有資料集中講述 Lily 分別量度 prefill throughput 同 decode throughput。

重點摘要:
– Lily 專為 Apple Silicon 與 Qwen3.6-35B-A3B 設計,支援 OpenAI-compatible HTTP API。
– 以 Rust runtime 配合自訂 Metal kernels,分開處理 prefill 同 decode。
– 不經 PyTorch 或 MLX execution path,代價係模型及硬件支援範圍較專門。
– fabric-lib 同 p2p-all-to-all 面向 RDMA、MoE dispatch 與 combine 等分散式推論問題。
– 效能應按裝置、上下文及生成負載實測,不能只依賴官方定位作比較。
項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Qwen, OpenAI, API, 提示詞, 工具, Mac, Python, 庫, 蘋果, Dataset 數據集

Dr. Claw 把 AI 研究流程收進一個可審核工作台

一款開源 AI 研究助理,把文獻回顧、實驗、寫作整合在同一介面,讓人類決策與 AI 執行之間留下可追蹤的紀錄。

Dr. Claw

跑過 AI 研究的團隊都遇過同樣的痛:Claude Code、Gemini CLI 等命令行編碼代理(coding agents)能讀寫檔案、撐住長對話,但文獻回顧、構思、實驗、寫論文、投期刊這些步驟散落在聊天工具、IDE、終端機、寫作軟件之間,中間決策也難以回頭追溯。Dr. Claw(GitHub: OpenLAIR/dr-claw)針對的正正是這個碎片化問題——它不是另起爐灶造一個新代理,而是把現有命令行編碼代理(Claude Code、Gemini CLI、Codex,以及透過 OpenRouter 接入的數百個模型)包進一個可控、可審核、人在回路(human-in-the-loop)的工作流。

項目覆蓋 survey → ideation → experiments → paper writing → slides & promotion 整條研究生命週期,與只懂執行程式碼的 CLI 代理相比,差異在於「全流程編排層」。底層靠三個關鍵設計撐起這層:持久化狀態物件(persistent state objects)、可重用技能庫(reusable skill library),以及多執行器協調(multi-executor coordination),把計劃、執行、寫作綁成一條可恢復的循環。論文亦明確指出,比起只共享同一後端執行器的裸 CLI 代理,Dr. Claw 在研究完整性上得分更高,同時保留可審計、可回溯的過程痕跡。

對獨立研究者、AI 實驗室團隊、需要把研究流程制度化的單位而言,這套架構的價值在於把人類決策(目標、約束、驗收)與 AI 執行清楚分開,並透過 checkpoint 反饋(Verify / Revise / Retry / Handoff)保留介入點。它支援本地部署(自家機器、自家 GPU、自家資料),亦提供桌面版(.dmg / .exe)或 npx dr-claw 零安裝啟動,甚至能在終端機直接 dr-claw chat 跑 agentic 對話。

項目已被 EMNLP 2026 System Demonstrations track 收錄(arXiv: 2609.00365),並採用 AGPL-3.0 搭配上游 GPL-3.0 元件授權,免費、無訂閱。需要留意的是,它自定位為 Anthropic Claude Science 的開源、模型中立替代方案,主打全生命週期而非單純計算分析。

GitHub · Paper

Categories: 開源, Agentic, 模型, OpenAI, Gemini, 軟件, 工具, IDE, 庫, 編程, Anthropic, Skill 技能

E-CommerceBench 經營 365 日網店的 Agent 考試

代理人要由十萬元起步,經營最多四間網店並應付供應商、庫存與退貨,最後以全年資產增長分高低。

Mean end-of-year total assets, eighteen models, five 365-day episodes each

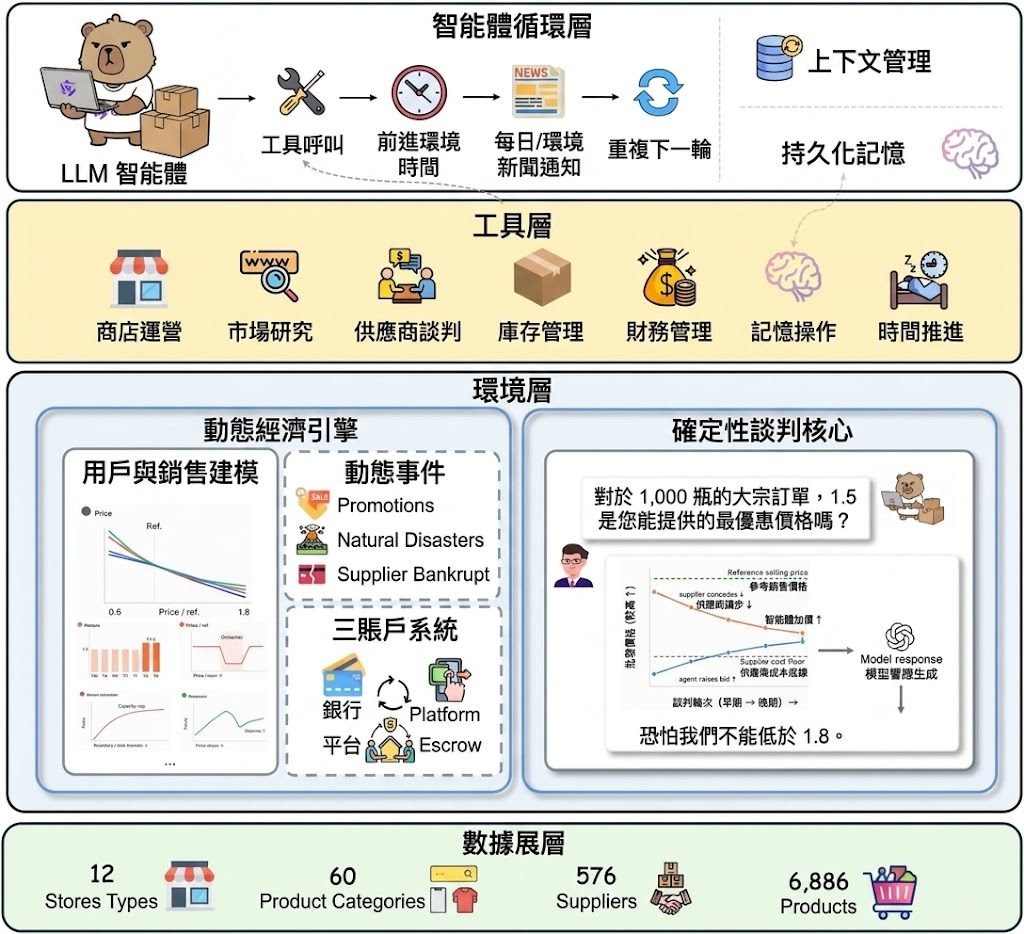
一個代理人由 ¥100,000 起步,連續經營最多四間網店 365 個模擬日,還要自行處理採購、定價、補貨、訂單履行及退貨。E-Commerce Bench 屬於長期自主商業運作的 LLM agent benchmark,實際處理的是代理人能否在現金流、庫存、風險和增長之間持續作出決策。

環境包含 6,886 個產品、60 個類別及 576 家供應商,其中 152 家涉及五種詐騙類型;全年亦有八次促銷和十項市場事件。客戶需求由固定多因素模型決定,供應商價格、讓步及接受與否則由 Deterministic Negotiation Kernel 計算,LLM 只負責把決策呈現成對話,避免抽樣回覆直接改變交易結果。

排行榜以五次獨立 episode 的年終總資產平均值計算 asset multiplier,同時提供標準差、CSE⁺、BadSpend%、回撤、每次工具呼叫帶來的收入、可控退貨比例、AnchorRatio、工具呼叫次數及破產次數等指標。GPT-5.6 Sol(max)平均資產達 ¥1,431,425,約為本金 14.3 倍;最佳 open-weight 模型 Qwen3.8-Max-Preview 為 ¥416,252,約 4.2 倍,18 個模型之間相差 1,264 倍,90 次運行有 10 次破產。

  • 測試場景涵蓋最多約 4,000 個回合,適合研究長期記憶、規劃和工具使用。
  • 固定需求與談判機制令模型差異較容易歸因,但未必代表真實市場的隨機性。
  • 模型排名同時呈現盈利能力、風險控制、浪費開支及資金壓力。
  • 項目資料提到 Python 3.10+,但提供內容沒有列出完整安裝、執行或下載流程。

研究代理人可靠性、商業決策、長期規劃或多步驟工具調用的團隊,會較容易從這套固定世界取得可重複比較的結果;網店經營者則可把它理解成壓力測試,而不是直接預測真實銷售額。它同時比較 proprietary 與 open-weight 模型,但資料未交代各模型的提示詞、工具策略或成本,因此資產排名不應單獨視為整體能力結論。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, Google, OpenAI, DeepSeek, Gemini, Python, Anthropic, Dataset 數據集

OpenClaw 2.0 重建介面與記憶連續性

OpenClaw 2.0把入門流程、對話延續同穩定性一併重做。對長時間使用 AI agent 的人,差別會先體現在找回上下文同減少中斷。

用得久嘅 AI agent,最怕唔係功能少,而係中途斷線、記唔住之前做過乜,或者想翻查舊對話時搵唔返內容。OpenClaw 2.0 針對呢類問題重做咗網頁體驗,亦加強咗 memory 同 session continuity,令長流程互動唔使成日由頭開始。

今次版本另一個直接影響體驗嘅改動,係 onboarding 變得更簡單。新手由安裝到開始使用嘅門檻降低,而舊用戶就會更在意 reliability pass 帶來嘅穩定性提升;更新說明同時提醒先備份 configuration 同 state,亦提到自動更新失敗時,可以用本地 coding harness 幫手完成更新、排錯同確認 Gateway 正常啟動。

文件列出咗一個幾實用嘅新能力:可以用完整字詞或片語搜尋可見對話內容,之後直接打開相符結果附近嘅訊息。對要追查工作脈絡、整理多輪討論,或者長時間同 agent 協作嘅人,呢個改動比單純加模型選項更有感。

  • 重做 web 體驗,介面與流程更貼近持續使用情境
  • 強化 memory 同 session continuity,減少對話中途斷層
  • 新增對話文字搜尋,可由結果跳回相關訊息位置
  • 做咗大規模 reliability pass,重點放在穩定運行
  • 更新時仍有 migration 要求,Plugin SDK compatibility 亦有保留與修補

OpenClaw 2.0 今次唔係靠單一新模型吸引注意,而係集中修補 AI agent 項目最常見嘅摩擦位:入門、延續性、搜尋同可靠度。對已經把 OpenClaw 放入日常工作流嘅團隊或個人,呢次更新代表系統更接近可長時間依賴嘅狀態;不過升級前後仍要留意 migration 與相容性檢查。

項目主頁

Categories: 開源, Agentic, OpenAI, API, OpenClaw, Anthropic

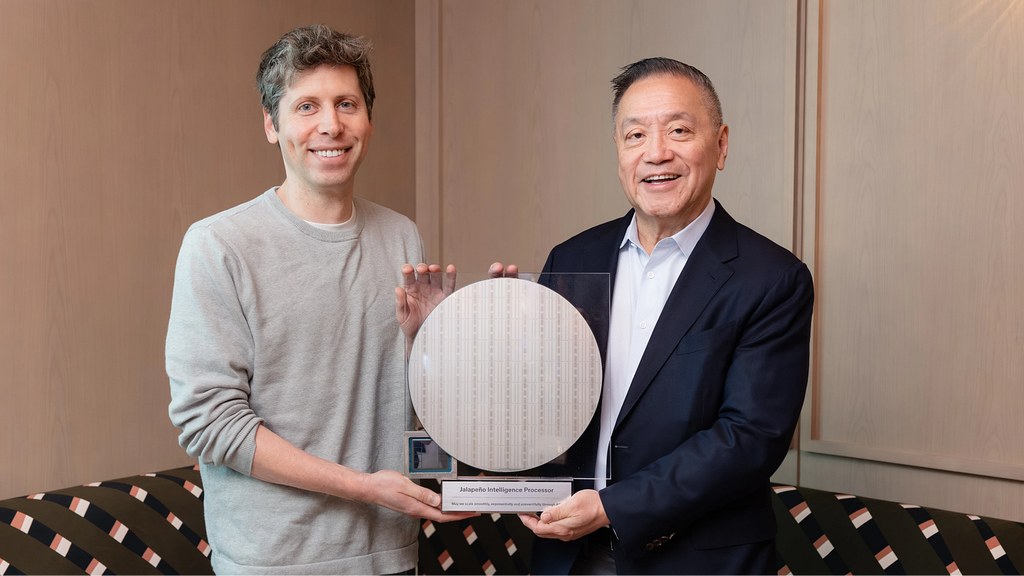
OpenAI Jalapeño:為大型語言模型推理而造的 ASIC

OpenAI 夥拍 Broadcom 打造 Jalapeño,瞄準大型語言模型推理,並以每兆瓦吞吐量挑戰 NVIDIA GPU 的效率優勢。

Og image

當模型推理成本受到功耗和硬件供應限制,單靠通用 GPU 未必能兼顧速度與效率。OpenAI 以空白設計打造 Jalapeño,屬於專為大型語言模型(Large Language Model,LLM)推理而設的應用專用集成電路(Application-Specific Integrated Circuit,ASIC),並非只針對 OpenAI 自家模型。

Jalapeño 由 OpenAI 與 Broadcom 合作開發,設計工作於 2024 年中開始,約 16 個月後完成製造流片。晶片採用 HBM4 高頻寬記憶體,配合硬件與軟件協同設計,目標是在不同模型及推理工作負載下維持高效能,而非過度優化單一推理環節。

在 OpenAI 實驗室以 InferenceX 測試套件進行的基準測試,聲稱 Jalapeño 的每兆瓦吞吐量優於已測試的 NVIDIA、AMD 及 Google 晶片,亦在效能功耗比上勝過 Blackwell。比較時 Jalapeño 沒有使用 Multi Token Prediction(MTP),其他晶片則採用各自最佳配置,因此結果仍需配合完整測試條件理解。

  • 以通用 AI 推理為設計方向,可運行多類模型
  • HBM4 令記憶體頻寬接近高階 GPU 的配置
  • 核心指標聚焦每兆瓦的 token throughput
  • 文章未提供公開下載、安裝或一般用戶使用流程

這類晶片最適合大型模型服務商及資料中心,用於推理量大、電力成本高的工作流。Jalapeño 的價值在於能否把高吞吐量延伸至不同模型和長期運行環境,而不只是單次基準測試中的優勢。

新聞主頁

Categories: 開源, NVIDIA, OpenAI, 新聞

video-shotcraft:電影感產品影片工作室

video-shotcraft 把產品頁面、動態分鏡和聲效製作串成一條工作流,協助 Claude Code 或 Codex 產出更完整的宣傳影片。

video-shotcraft logo

由產品頁面出發,video-shotcraft 會交由 Claude Code 或 Codex 組織分鏡、動畫及聲音設計,再以 Remotion 製作宣傳、發布或示範影片。這個項目屬於 AI agent skill,實際處理的是產品影片製作中截取畫面、安排鏡頭、配合節奏剪接和加入聲效等繁複工序。

畫面不只依賴抽象動畫,工作流包括真實頁面擷取、2.5D camera moves、beat-synced cuts,以及電影感 SFX。152 張 shot recipe cards、209 種 style 和 209 個 motion previews,讓創作者可按產品內容挑選鏡頭語法,再由 native Remotion components 組合成片;元件以 normalized progress t 驅動,並可替換 ACCENT 顏色。

適合需要頻繁製作產品發佈片、marketing video 或 demo video 的設計師、創業團隊及內容製作人。它把分鏡規劃和前端式動態設計交給代理處理,換來較完整的自動化流程,但影片質感仍取決於產品頁面素材、提示內容及人工修訂;提供的資料亦未交代具體安裝步驟、所需帳戶或完整輸出流程。

品質控制來自對候選動作進行八輪逐幀檢視,並與參考片段比較後整理成 recipe cards。README 亦列出完成交付後可輸出可編輯的 JianYing(CapCut CN)草稿,方便按 shot 重新剪接、調速、排序、調色及重建字幕軌道,但相關功能的可用條件仍需以項目最新文件為準。

  • 素材處理:支援真實產品頁面擷取,而非只靠預設圖形。
  • 動態語法:涵蓋 2.5D 鏡頭、節拍剪接和 SFX 配搭。
  • 內容庫:提供 152 張 shot recipe cards、209 種 style 及 209 個預覽。
  • 輸出彈性:以 Remotion 元件組成影片,並列出 JianYing 可編輯草稿匯出能力。
  • 使用限制:目前資料不足以確認安裝、模型依賴和完整執行要求。

GitHub

Categories: 開源, Agentic, AI productions, OpenAI, Video, Anthropic, Dataset 數據集, Skill 技能

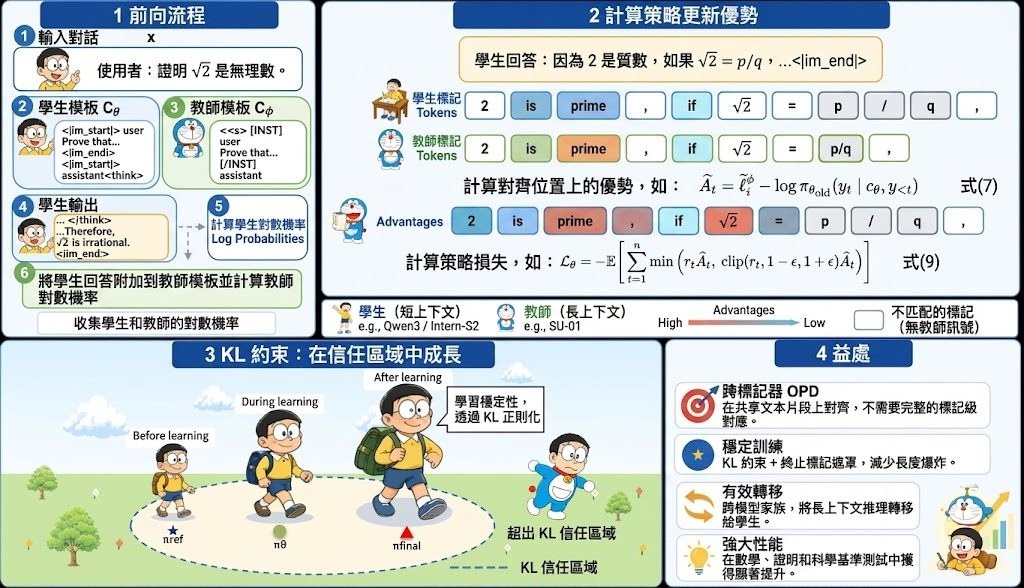
SimpleOPD 把長思維蒸餾帶到異 tokenizer 學生模型

長上下文教師模型唔難找,難的是點樣穩定轉移到短上下文學生模型。SimpleOPD聚焦呢個落差,做法比一般蒸餾更貼近訓練現場。

Repository image for hhnqqq/SimpleOPD

想把長上下文推理能力交到較細、較短上下文的學生模型,卡位往往唔係只有模型強弱,而是 tokenizer 不同、輸出愈蒸餾愈長,最後連訓練都變得唔穩。SimpleOPD屬於模型訓練方法項目,處理的是 long-context reasoning teacher 到 short-context student 之間的 On-policy distillation(OPD)轉移,重點放在跨 tokenizer 仍然可以學到推理能力。

它冇硬做 token-level 對齊,而是改在 shared text space 對齊,只監督師生 tokenizer 剛好切出相同文字跨度的位置。呢個取捨很務實:少了強行對齊帶來的噪音,代價是可監督位置會收窄,但換來 arbitrary teacher-student tokenizer combinations 也能成立,對 Qwen3、Qwen3.5、Intern-S2、GLM-4.7、Gemma4 這類不同家族學生模型都更有通用性。

另一個關鍵,是它直接處理「答案愈生愈長」這個訓練現象。SimpleOPD加入 student-reference KL loss,再對 </think> 和 <|im_end|> 這類終止 token 做 advantage masking,目的不是單純加正則化,而是壓住學生模型偏離初始 policy 太遠,減少 teacher-student distribution mismatch、截斷率上升與訓練失穩。

  • 支援 long-context teacher 產生 100K+ token reasoning chains
  • 以 shared text space 對齊,避開 tokenizer 不一致帶來的蒸餾障礙
  • 透過 student-reference KL loss 與終止 token masking 控制長度膨脹
  • 在 ProofBench 對 Intern-S2-Preview 帶來 +21.2 分,升至 55.2
  • 結果已超過 Gemini-2.5-Pro,並提到對 HLE、HiPhO 也有外溢收益

它不是即裝即用的線上服務,而是偏研究與訓練流程的開源項目;環境依賴 SLIME 0.2.3、Python 3.10+、PyTorch 2.0+,並為 GPU、HTTP-based teacher inference、timeout、concurrency、batch processing 留好接口。受益最大的會是做蒸餾訓練、想把強教師推理能力壓到較易部署學生模型的團隊,尤其是要跨 tokenizer、又不想被超長 reasoning chain 拖垮訓練穩定性的情境。

項目主頁 · GitHub

Categories: 開源, Qwen, OpenAI, Gemini, Python

RA-Bench 直指危機假影片檢測盲點

危機事件影片最麻煩之處,不是合成得花巧,而是看起來太像真。RA-Bench把檢測器拉回真實傳播場景,專門測試這個落差。

RA-Bench: Can we defend against generated crisis videos?

當一段災難、戰事或公共事故影片本身已有真實事件做錨點,檢測器往往無法只靠內容違和感分辨真偽。RA-Bench屬於影片檢測基準資料集,針對的正是 AI 生成危機影片貼近真實新聞片段後,現有偵測方法還能否守得住。

它的做法有一個關鍵判斷:不再拿脫離情境的合成片去測,而是把真實危機影片與對應生成版本配對,並且涵蓋四個開源與五個閉源生成器。資料規模有 17,886 段影片,當中包括 1,830 段 real anchors、16,056 段生成片,另設 RA-Bench-HumanProof 與 RA-Bench-LastMile,前者收錄連人工審查者都一致誤判為真的 633 段影片,後者再測試影片經過連續傳播處理後,檢測器會否失準。

這個項目把「像真」、「會誤導人」、「經社交傳播後失真」三件事放在同一套測試裡。相對於只看配對樣本的資料集,它多了一層來源泛化與傳播鏈穩健性的要求;代價是資料權限較複雜,完整版本有部分 real anchors 只提供原始 URL,未必人人都能直接重跑 full 軌道。

  • public-media 只評估可重新分發的真實錨點配對,較適合公開重現與初步比較
  • full 依照完整論文清單評估,也要求處理只提供 URL 的真實來源
  • Hugging Face 釋出公開媒體約 93.8 GB,生成影片完整提供,真實素材則經權利審核後部分保留來源連結
  • 評估採用 source-matched evaluation,會把每個生成來源放回其對應真實錨點脈絡判斷

對做影片鑑識、內容審核、新聞驗證與多模態安全研究的團隊,RA-Bench的價值很直接:它不是教模型辨認「很像假片的假片」,而是逼它面對會在人類審查與傳播流程中混過去的片段。限制也同樣清楚,這仍是 benchmark,不是現成檢測器;要得出可比較結果,仍要先準備預測輸出、下載資料,並處理部分真實來源無法重分發的存取條件。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 多模態模型, OpenAI, Video, Dataset 數據集

Vision-DeepResearch:由靜態圖片走向連續影片的 DeepResearch Agent

Video-DeepResearch 將視覺搜尋延伸至連續影片,要求模型先理解跨畫面的證據,再進行網絡探索。

icon

面對需要翻查影片內容、再結合網絡資料回答的問題,單靠文字搜尋往往會漏掉關鍵畫面。Video-DeepResearch 是一個多模態研究型 Agent 項目,透過 Video-DeepResearch(Video-DR)處理連續影片中的時空資訊,並把視覺理解與網絡探索分開安排。

它修正了兩個常見卡位:模型偏向使用文字工具,較少主動檢視影片;模型亦可能直接依賴內部記憶,未有真正完成工具輔助搜尋。Pipeline 先逐階段解鎖視覺工具,要求模型完成跨畫面 grounding,再進入網絡檢索,取捨是流程較嚴謹,但推理成本和執行時間亦可能增加。

訓練流程先以 Supervised Fine-Tuning(SFT)建立基本能力,再使用 Group Relative Policy Optimization(GRPO)強化自主探索。項目同時提供 30 K 個 video-grounded QA pairs、7 K 條整理後的 trajectories,以及程式碼、資料集和模型權重,研究團隊可按需要測試基準、重現訓練或直接載入模型。

  • Video-DR-35B-A3B 在 Video-DR 達到 68.0% accuracy
  • 比 Claude-4.5-Sonnet 的 63.0% 高 5.0 個百分點
  • GPT-5 和 Gemini 2.5 Pro 分別為 57.0% 和 62.0%
  • Vision-DeepResearch-30B-A3B 延續同一研究方向,另有 SFT-only 的 8B 版本

現有結果反映它在影片證據與網絡資料需要互相驗證的工作較有價值,例如研究、媒體核查和長片段問答;但 68.0% 仍代表部分問題會出錯,較適合作為研究平台和可檢驗的 Agent 架構,而不是無需監督的影片分析服務。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港理工大學, Agentic, 多模態模型, 模型訓練, Qwen, OpenAI, Gemini, Video, 香港, Anthropic, Dataset 數據集

LongHorizon-Harness 解決代理在長任務時的錯誤

代理能否跑足幾十小時,關鍵唔只在模型能力,仲在狀態有冇走樣。LongHorizon-Harness把驗證、執行同任務延續拆開處理。

Install and run LongHorizon-Harness from the command line

當代理要橫跨桌面程式同 command line 連續做事,最易出問題唔係單步操作,而係中途記錯狀態、判斷錯進度,結果愈做愈偏。LongHorizon-Harness 針對屬於長時程代理執行與驗證工具,目標係令複雜任務可以被保存、核實,再一路推進到完成。

它唔係新模型,它主要協助 Claude Code、Codex、OpenClaw 之類 agent backend 上面處理 execution、state management 同 result verification。核心做法是 Manage-Execute-Audit (MEA) loop,把規劃、執行、審核拆成不同路徑,並把可信狀態獨立保存,減少單一長對話愈滾愈亂的問題。

  • 支援 Claude Code、Codex、OpenClaw,亦可配 Gemini CLI 與 mini-SWE-agent
  • 以獨立 audited state 推動下一步,而唔係只靠 session 內記憶
  • 可用單一指令啟動,每次執行會獨立保留 audit trail
  • 針對 WeaveBench、OSWorld 2.0、Terminal-Bench 2.1 這類長任務基準有公開成績

它在 WeaveBench 取得 80.7% PassRate、OSWorld 2.0 有 35.2% partial score,Terminal-Bench 2.1 success rate 為 77.2%。官方亦強調在相同 backbone 下,只換 harness,三個 benchmark 都向上走,反映改進點主要來自流程控制同驗證機制,而唔係模型突然變強。

呢種設計較適合需要長時間自動化處理、多步驟交接、又要追蹤結果可信度的團隊,例如研究、軟件測試、系統操作同複雜 office workflow。代價是流程比單純聊天式代理更重,審核與狀態管理會增加結構與成本,但換來的是更穩定的延續能力,同較容易追查每一步點樣做出來。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, OpenAI, DeepSeek, Gemini, 框架, OpenClaw, Anthropic, Dataset 數據集, MiniMax, Skill 技能

Page 3 of 7
1 2 3 4 5 … 7