 擁有尖端 AI 語音複制技術嘅開源生態系統,超過兩萬個語音模型。

Categories: 新聞
擁有尖端 AI 語音複制技術嘅開源生態系統,超過兩萬個語音模型。
擁有尖端 AI 語音複制技術嘅開源生態系統,超過兩萬個語音模型。
Turn Your Imagination into AI Videos With Just A Keyword!
Turn Your Imagination into AI Videos With Just A Keyword!
如何本地運行 Llama 3 模型 以下是一些運行 Llama 3 的好處: 隱私: 您可以私下處理您的數據,而無需將其上傳到雲端。 成本: 您可以避免雲計算費用。 斷網訪問: 您可以離線使用 Llama 3。 但是,運行 Llama 3 也有以下一些缺點: 硬件要求: Llama 3 需要強大的硬件才能運行。 設置複雜: 設置和運行 Llama 3 可能很複雜。 模型大小: Llama 3 模型很大,需要大量存儲空間。 如果您有興趣本地運行 Llama 3,以下是一些步驟: 安裝所需的軟件。 您需要安裝 Python、pip 和其他一些依賴項。 下載 Llama 3 模型。 Llama 3 模型可在 Google AI 網站上免費獲得。 設置 Llama 3。 您需要配置一些設置,例如模型路徑和輸出路徑。 […]
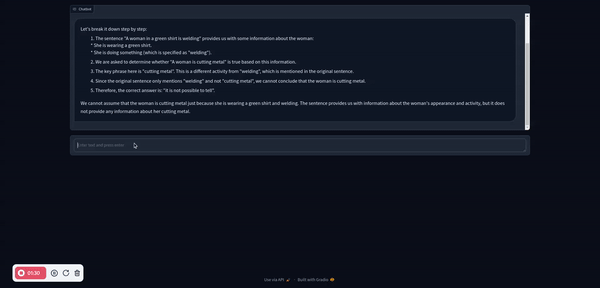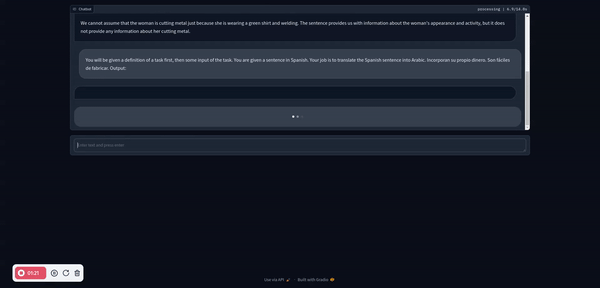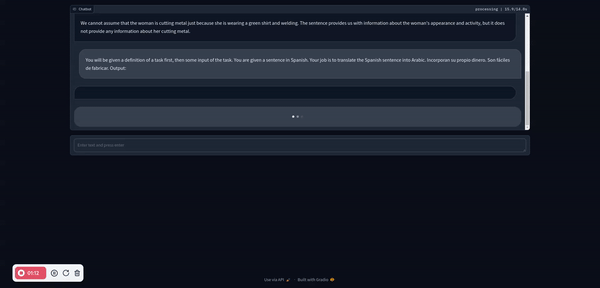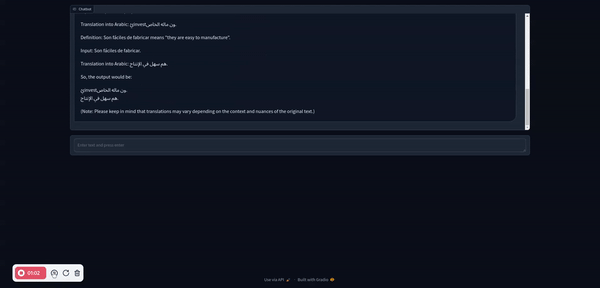
以下是一些運行 Llama 3 的好處:
但是,運行 Llama 3 也有以下一些缺點:
如果您有興趣本地運行 Llama 3,以下是一些步驟:
以下是一些有關如何運行 Llama 3 的更多詳細信息:
隨著 Generative AI 技術的快速發展,AI 視頻生成技術成為了一個熱門的研究領域。在這個領域中,StreamingT2V 模型的推出無疑是一個重要的里程碑。由 Picsart AI Research 團隊聯合其他團隊開發的 StreamingT2V 模型,成功實現了長達 1200 帧、時長達 2 分鐘的 AI 生成視頻。這一進展不僅在視頻持續時間上超越了先前的 Sora 模型,更標誌著 AI 視頻生成技術的一大進步。此外,StreamingT2V 模型作為一個開源項目,對於促進開源生態系的發展具有重要的價值,這對 AI 生成內容的未來發展可能會產生深遠的影響。
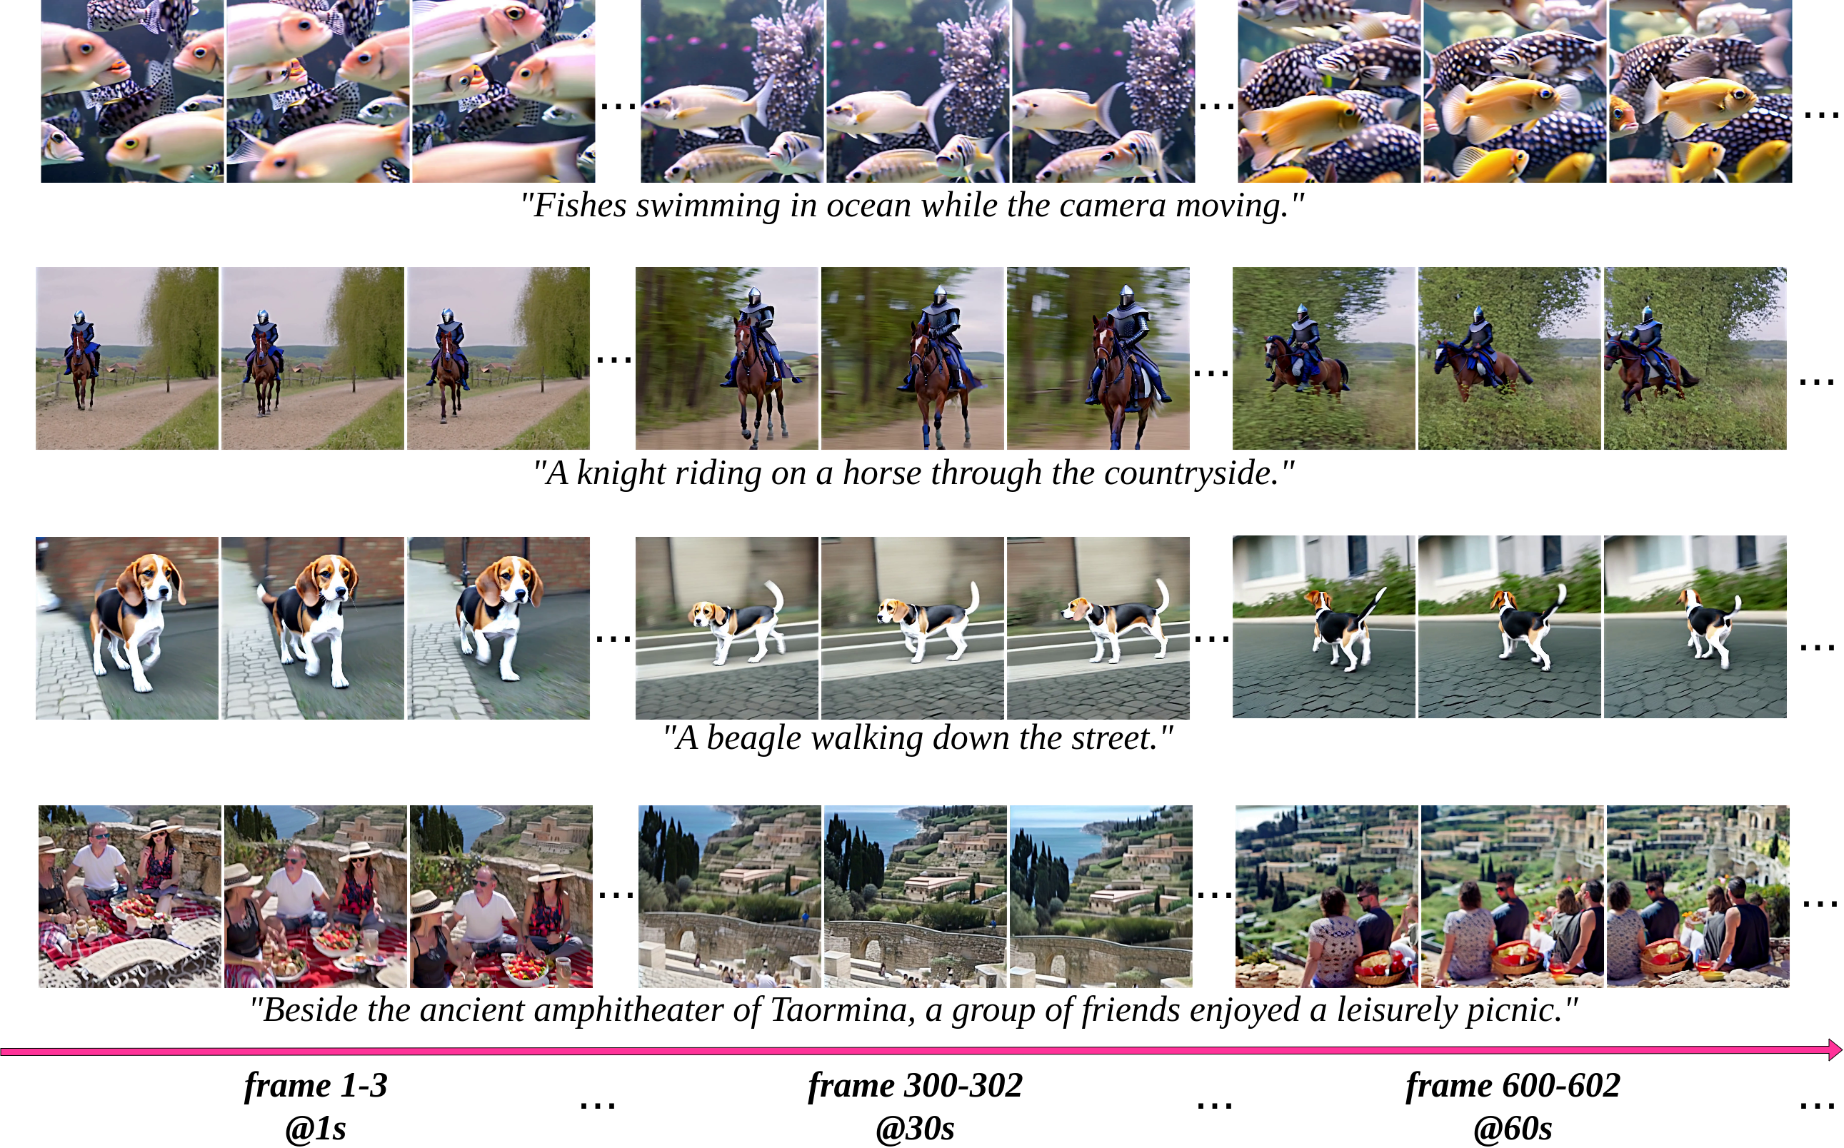
隨著 Generative AI 技術的快速發展,AI 視頻生成技術成為了一個熱門的研究領域。在這個領域中,StreamingT2V 模型的推出無疑是一個重要的里程碑。由 Picsart AI Research 團隊聯合其他團隊開發的 StreamingT2V 模型,成功實現了長達 1200 帧、時長達 2 分鐘的 AI 生成視頻。這一進展不僅在視頻持續時間上超越了先前的 Sora 模型,更標誌著 AI 視頻生成技術的一大進步。此外,StreamingT2V 模型作為一個開源項目,對於促進開源生態系的發展具有重要的價值,這對 AI 生成內容的未來發展可能會產生深遠的影響。
中國聯通AI創新中心發佈業界第一個llama3中文指令微調模型(全參數微調),2024年4月19日22點上傳 本模型以Meta Llama 3為基礎,增加中文數據進行訓練,實現llama3模型高質量中文問答 模型上下文保持原生長度8K,支持長度64K版本將於後續發佈 基礎模型 Meta-Llama-3-8B

中國聯通AI創新中心發佈業界第一個llama3中文指令微調模型(全參數微調),2024年4月19日22點上傳
本模型以Meta Llama 3為基礎,增加中文數據進行訓練,實現llama3模型高質量中文問答
模型上下文保持原生長度8K,支持長度64K版本將於後續發佈
基礎模型 Meta-Llama-3-8B
在訓練大型語言模型有多燒錢?一文學到:標榜最有台灣味的 Taiwan-LLM 語言模型,是以 Meta LLaMA 2 為基礎的全參數微調模型,大幅提升繁體中文能力並融入台灣文化。
在訓練大型語言模型有多燒錢?一文學到:標榜最有台灣味的 Taiwan-LLM 語言模型,是以 Meta LLaMA 2 為基礎的全參數微調模型,大幅提升繁體中文能力並融入台灣文化。
隨著 LLaMA3 的發布,人們對能夠在本地可靠運行(例如,在筆記型電腦上)的代理產生了濃厚的興趣。在這裡,我們展示如何使用 LangGraph 和 LLaMA3-8b 從頭開始建立可靠的本地代理。我們將 3 篇高級 RAG 論文(Adaptive RAG、Corritive RAG 和 Self-RAG)的想法結合到一個控制流程中。我們在本地使用本地向量儲存 c/o @nomic_ai 和 @trychroma、用於網路搜尋的 @tavilyai 以及透過 @ollama 運行 LLaMA3-8b。
隨著 LLaMA3 的發布,人們對能夠在本地可靠運行(例如,在筆記型電腦上)的代理產生了濃厚的興趣。在這裡,我們展示如何使用 LangGraph 和 LLaMA3-8b 從頭開始建立可靠的本地代理。我們將 3 篇高級 RAG 論文(Adaptive RAG、Corritive RAG 和 Self-RAG)的想法結合到一個控制流程中。我們在本地使用本地向量儲存 c/o @nomic_ai 和 @trychroma、用於網路搜尋的 @tavilyai 以及透過 @ollama 運行 LLaMA3-8b。

Embedding models 是一種專門用於生成向量嵌入的模型:長數組數字,代表給定文本序列的語義含義。生成的向量嵌入數組然後可以存儲在數據庫中,該數據庫將它們作為一種方式進行比較,以搜索具有相似含義的數據。 Embedding models 的工作原理是將文本分解為單詞或短語序列,然後為每個單詞或短語分配一個向量。這些向量通常是高維的,可以捕獲單詞或短語的語義含義。例如,單詞“國王”和“女王”可能具有相似的向量,因為它們都與皇室有關。 Embedding models 有許多應用,包括: Embedding models 是一種強大的工具,可用於提高各種任務的性能。它們是 NLP、IR 和 CV 等領域的重要研究領域。
Embedding models 是一種專門用於生成向量嵌入的模型:長數組數字,代表給定文本序列的語義含義。生成的向量嵌入數組然後可以存儲在數據庫中,該數據庫將它們作為一種方式進行比較,以搜索具有相似含義的數據。
Embedding models 的工作原理是將文本分解為單詞或短語序列,然後為每個單詞或短語分配一個向量。這些向量通常是高維的,可以捕獲單詞或短語的語義含義。例如,單詞“國王”和“女王”可能具有相似的向量,因為它們都與皇室有關。
Embedding models 有許多應用,包括:
Embedding models 是一種強大的工具,可用於提高各種任務的性能。它們是 NLP、IR 和 CV 等領域的重要研究領域。

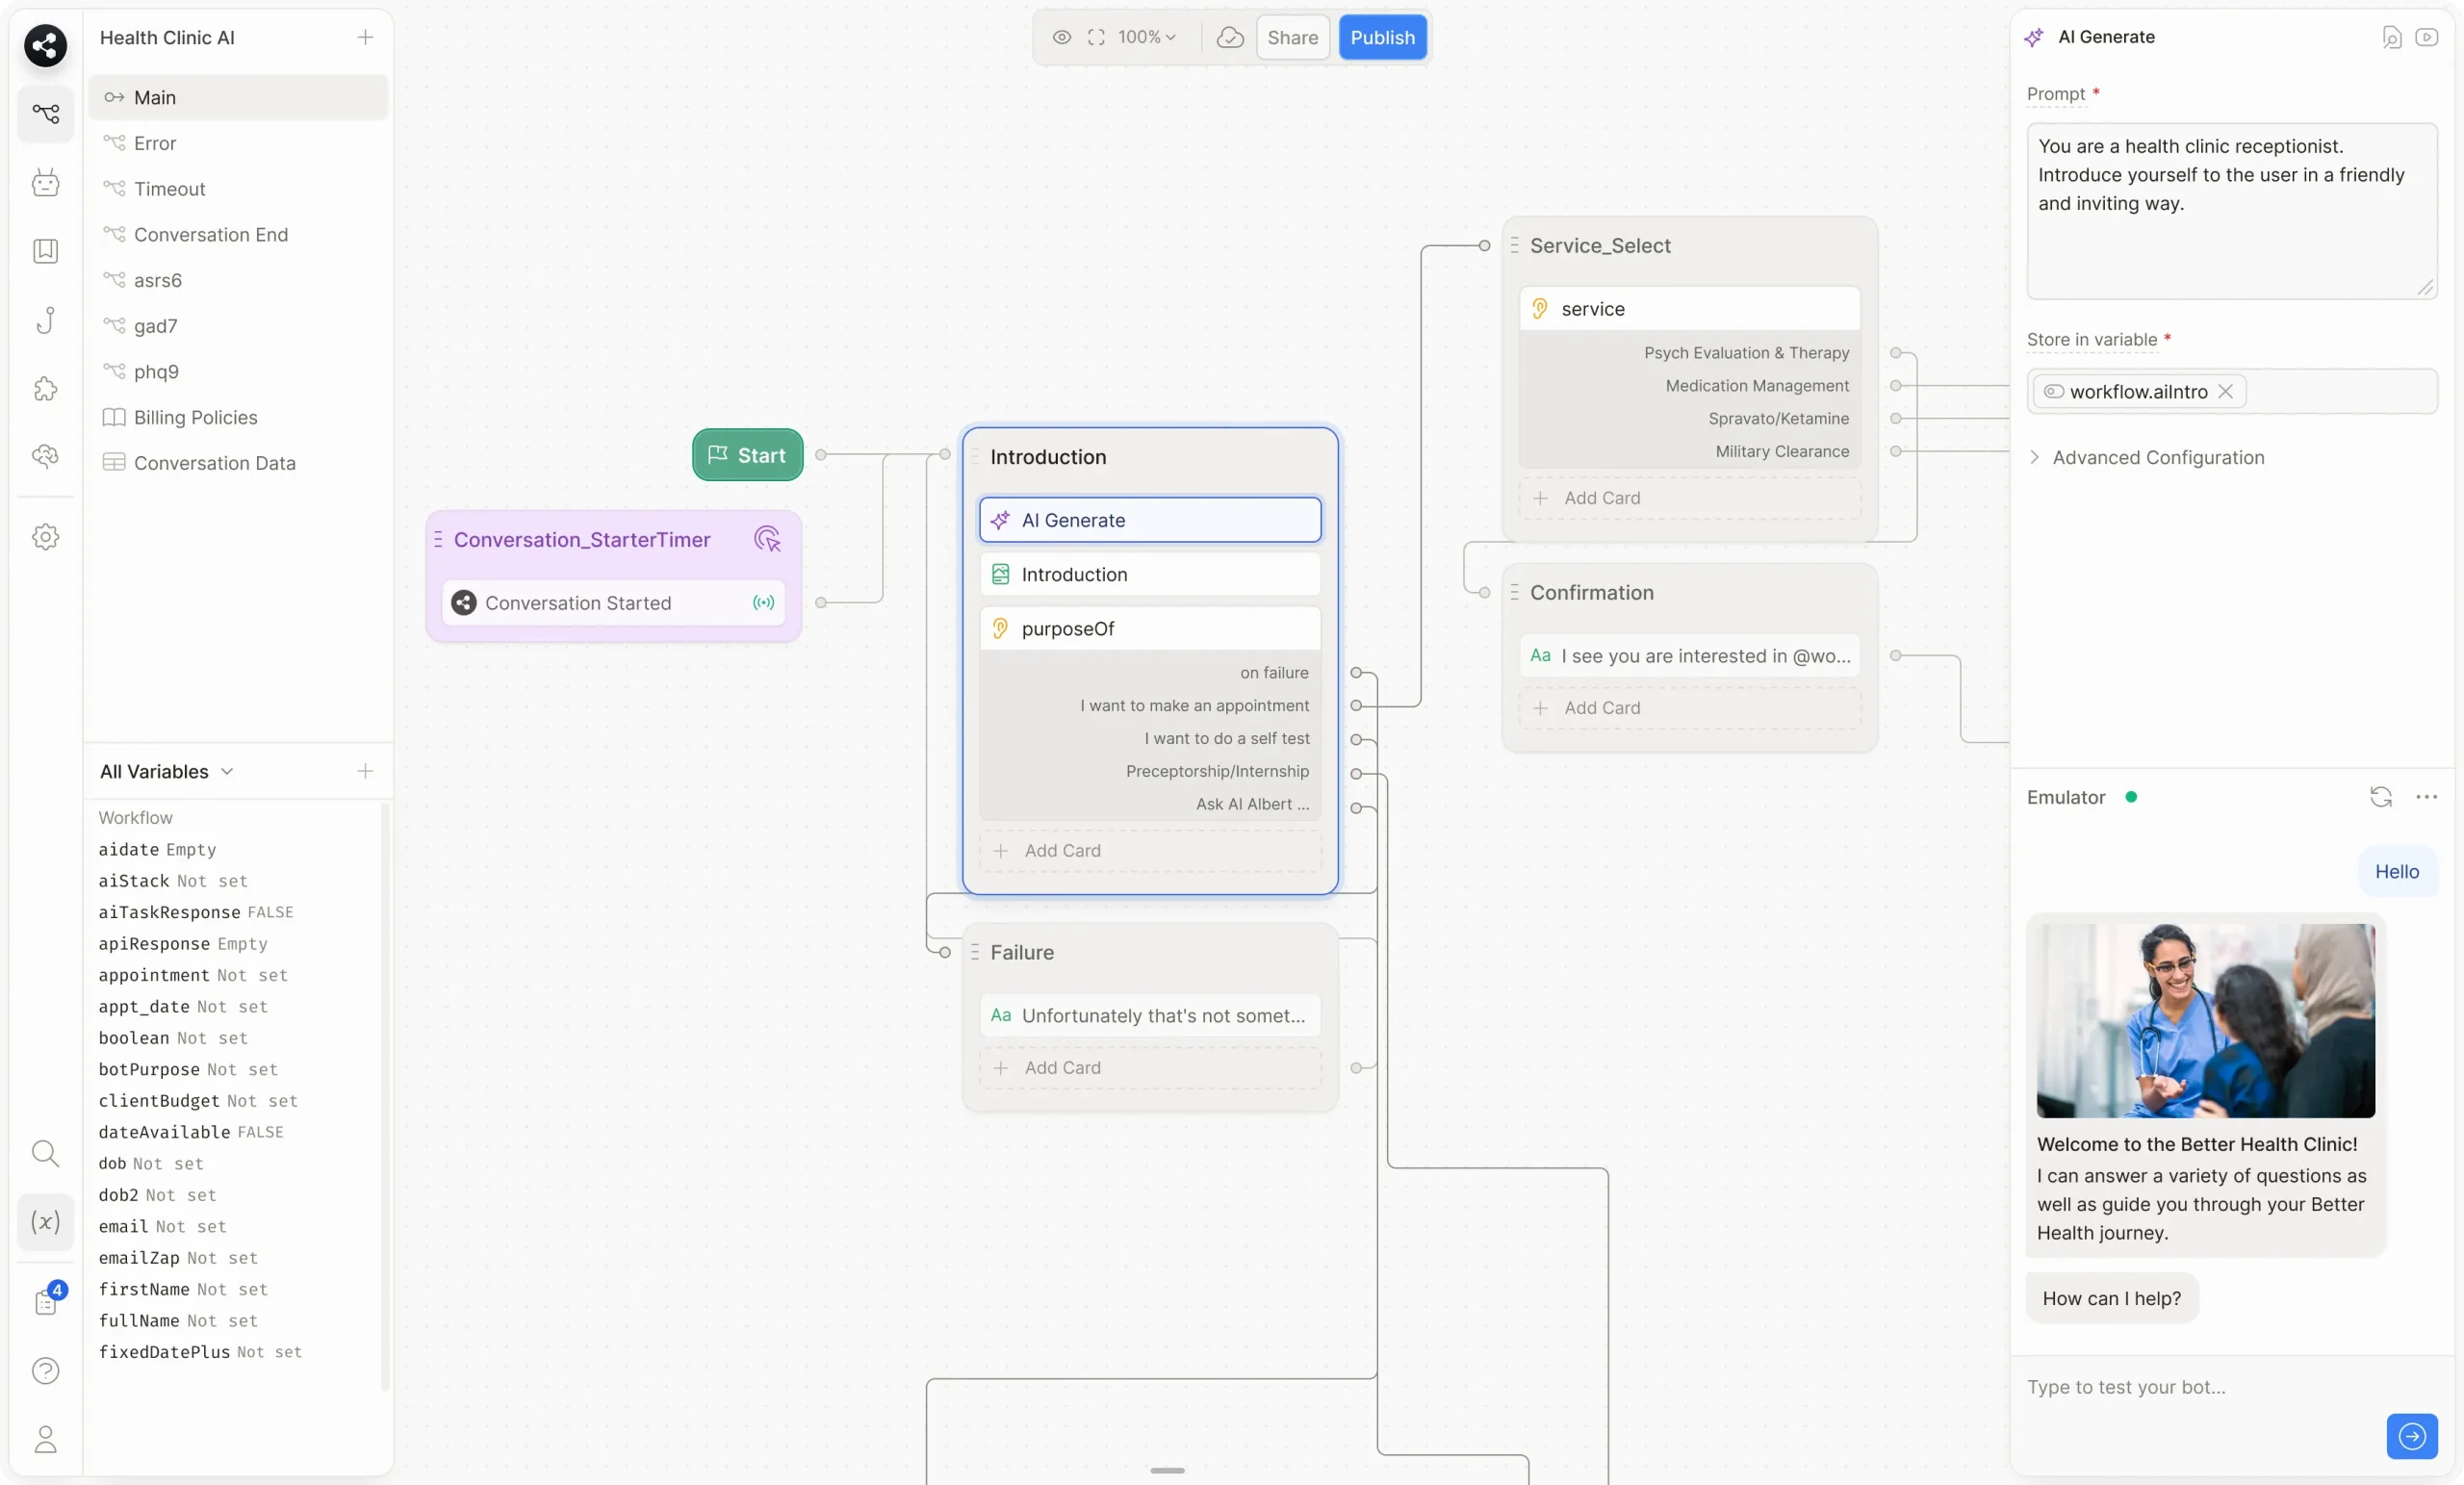
Rivet 是一個功能強大的整合開發環境 (IDE) 和函式庫,旨在使用基於圖形的視覺化介面建立 AI 代理程式。本指南將為您概述 Rivet 的功能,並引導您了解其各種特性和功能。
Rivet 是一個功能強大的整合開發環境 (IDE) 和函式庫,旨在使用基於圖形的視覺化介面建立 AI 代理程式。本指南將為您概述 Rivet 的功能,並引導您了解其各種特性和功能。