MatrAIx-Persona-8B: 模擬現實中的人性

MatrAIx 把人性化模擬用戶搬入評估流程,讓產品在推出前先看見不同人會點互動。它特別適合做問卷、聊天、網頁同 App 測試。

Watch the MatrAIx demo on YouTube

MatrAIx 是一套以多樣化模擬用戶做核心的評估基建,目標是補足只看單一指標、卻看不到不同人實際反應的盲點。它把 persona 變成 LLM agents,分別在 Survey、AI Chatbot、Web 同 App 四種環境跑可重現的任務,適合用來看產品、介面同互動流程會點影響不同用戶。

它的做法唔係只生成幾個虛構角色,而係用 1,290 個人格維度去組合背景、心理、能力同行為,再加上依賴關係處理同 evidence-aware human grounding。這種設計令評估結果唔止係一條總分,而係可以分辨邊類用戶受影響、邊種流程出問題。

MatrAIx: Simulating the World with 8.3B Persona Agents
  • 可用於市場研究、概念測試、客服對話、網頁原型同 App 流程評估
  • 介面前有 Playground 同 visual runner,方便先睇互動再做批量測試
  • persona-agent 範例需要 Model API keys,Playground / viewer 前端只要求 Node.js 20+
  • 內文提到嘅公共 persona 資料集同評估報告,顯示它偏向研究同產品驗證兩用。

同一般只做通用 benchmark 的方法相比,MatrAIx 強調人口規模同可重現的模擬軌跡,重點唔係單次對錯,而係不同 persona 之間的差異。這對做 AI 產品、用戶研究、RL 訓練前資料收集的團隊較有價值,因為佢提供的是互動過程同行為痕跡,而唔只是結果分數。

項目主頁 · GitHub

Categories: 開源, Agentic, API, Medical醫學, Dataset 數據集

LISA:讓 MEG 語音解碼由準確走向可解釋

LISA 把腦磁訊號配對到語音嵌入,並保留空間、時間與聲音特徵線索。

LISA architecture and analysis pipeline

將一段 3 秒、208 通道的腦磁圖(magnetoencephalography,MEG)訊號配對到聽到的語音,同時追查證據來自哪個腦部位置與時間段,正是 LISA 要處理的問題。它屬於可解釋神經解碼模型,透過對比式檢索目標,把 MEG 片段映射至對應音訊的 Wav2Vec2 表徵。

LISA 的價值不只在於找出正確語音片段,而是把空間濾波器、時間濾波器和分支結構直接保留下來,方便轉換成感測器空間或皮質來源的分析結果。它採用幾何感知的空間注意力,配合 25 個可解釋分支,每個分支使用 150 ms 時間核心,再接兩個時間卷積區塊。

在 MEG-MASC 實驗中,模型於 1,005 個候選語音片段取得 39.75 ± 0.34% Top-1 準確率及 70.4% Top-10 準確率;完整解碼器有 486,619 個可訓練參數,約為 Défossez et al. 方法的二十分之一。配對 MEG 遮蔽分析亦發現,19 項測試聲音特徵中有 15 項對檢索有貢獻,惟這些結果仍屬特定資料集與實驗設定,不能直接推廣至所有腦訊號任務。

  • 可抽取空間及時間濾波器,支援後續神經科學分析
  • 內置 preprocessing、training、evaluation 與 analysis 程式
  • Python 3.11 的 LISA 環境可用於 synthetic demo 或新資料集
  • CPU 可以執行,訓練階段使用 CUDA-capable GPU 會較合適
  • 重現 MEG-MASC 清理流程,儲存空間峰值約需 300 GB

研究人員可先用 synthetic demo 熟習張量流程,再按文件改接其他 EEG(electroencephalography,EEG)或 MEG 資料。相較只追求檢索準確率的深度解碼器,LISA 以較小模型換取可追溯性;需要完整重現結果的人,仍要準備資料集、環境及較大的儲存空間。

項目主頁 · GitHub

Categories: 開源, 模型訓練, 框架, Medical醫學, 語音

Microsoft Mage:4B 多模態輕量路線

想做影像生成、編輯,甚至進一步研究多模態模型,但運算資源有限,Mage 會係一個值得留意的方向。它把 4B 規模壓到夠細,同時仍然追住更大模型的表現。

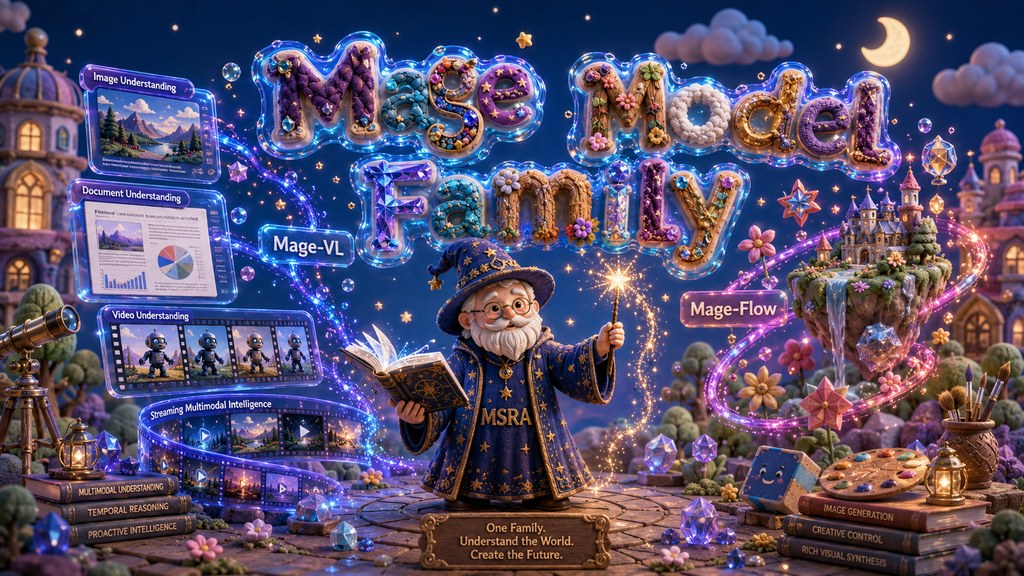
gallery

當你想喺有限 GPU 預算下做影像生成、編輯,甚至延伸到影像與影片理解,Mage 這個開源模型家族的定位就相當直接:用固定 4B 參數規模,處理多模態理解與生成兩條路線,目標唔係堆大模型,而係保留研究可控性同部署可行性。

Mage 目前最完整的是 Mage-Flow,屬於模型家族中的生成與編輯分支。它把 Mage-VAE 同 Native-Resolution Multimodal Diffusion Transformer 組合起來,前者負責更高效率的 latent tokenizer,後者負責文字生圖與指令式修圖;同時提供 Base、RL-aligned 同 4-step Turbo 版本,方便按畫質、對齊程度與速度取捨。另一條線 Mage-VL 對準 image/video understanding,但程式與權重細節仍待釋出。

同類開源影像模型很多都靠更大參數量換效果,Mage 的判斷明顯不同:它把重點放喺 codec-aligned efficiency,同一個 checkpoint 已可覆蓋 512 到 2048、不同長闊比,連 4:1 這類極端尺寸都原生支援,減少多套模型或額外縮放流程。它在生成、編輯表現上可與 Qwen-Image 20B、FLUX.2 32B、FireRed-Image-Edit 20B 等較大型開源系統競爭,但取捨是 Mage-VL 仍未完整開放,整個家族現階段更適合關注研究與工作流整合的人先行評估。

Super fast Image Edit model Mage-Flow on 8GB VRAM
  • 固定 4B 規模,主打可訓練、可微調、可部署
  • Mage-Flow 已覆蓋 text-to-image 與 instruction-based image editing
  • Mage-VAE 以更低 encode/decode MACs 減輕高解析度瓶頸
  • 單一 checkpoint 支援 512–2048 與多種 aspect ratio
  • Turbo 版本強調速度,1024² 在單張 A100 有明確推理數字

部署與測試方面,現有資料顯示 Hugging Face 已提供多個 Mage-Flow 與 Mage-Flow-Edit 權重,適合先用現成 checkpoint 驗證生成、修圖與速度,再決定是否進一步做微調。對做垂直領域影像項目、想研究後訓練方法,或者需要把高解析度生成放入較實際算力條件的人,Mage 的吸引力不在花巧包裝,而在它用一條輕量路線,把研究、性能與部署成本拉回較平衡的位置。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 多模態模型, Qwen, 微軟, Stable Diffusion, Video, Image, 影像模型, 影像處理, txt2img, Medical醫學

ClinFusion 把醫療影像讀懂再回答

ClinFusion瞄準的不是一般聊天,而是把2D與3D醫療影像連同文字指令一併理解。它想解決的重點,是醫療多模態模型常見的看得多、答得快,卻未必貼近臨床判讀。

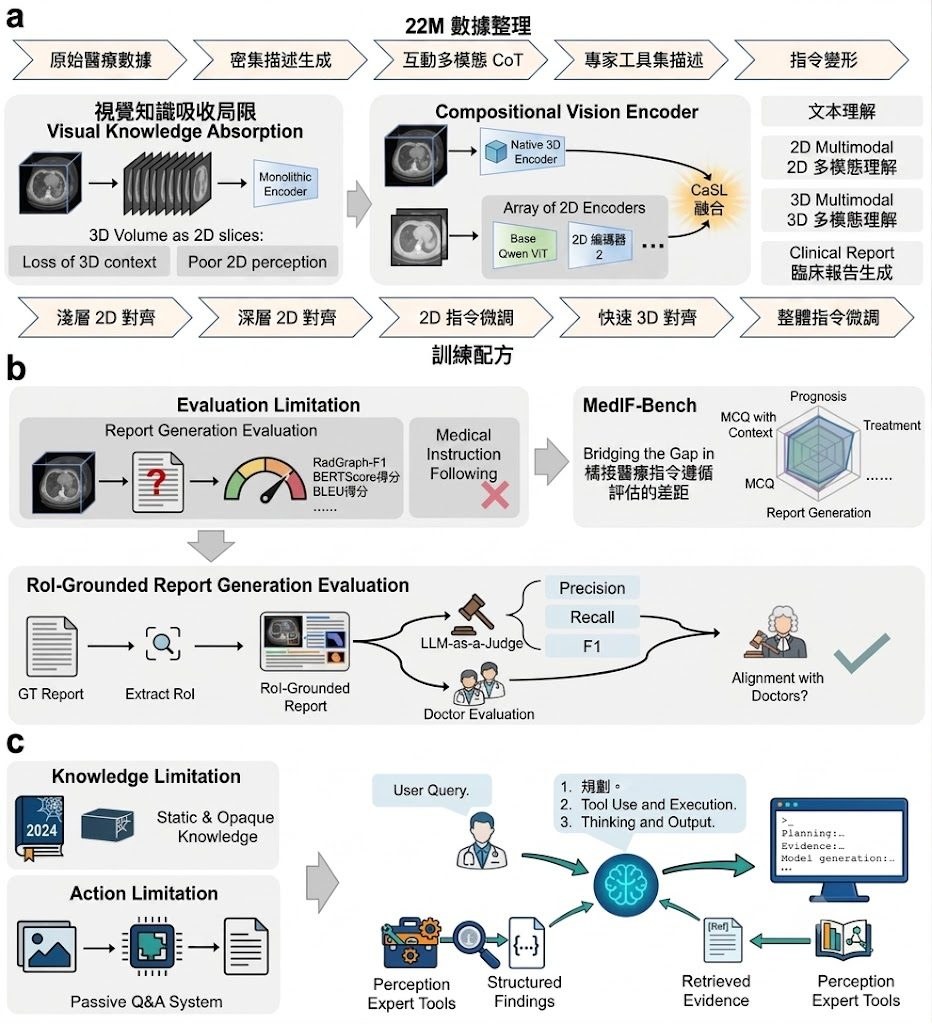
radar chart

醫療多模態模型最易失準的位置,往往不是會不會答,而是有沒有真正對準影像內容。ClinFusion屬於模型,更準確地說是面向臨床理解的 vision-centric Multimodal large language models (MLLMs) 系統,重點放在同時處理 2D 圖像、原生 3D NIfTI 影像與文字任務,減少只靠文字對齊時常見的臨床細節流失。

現有做法常把醫療問題當成一般多模態問答處理,但作者認為這種範式忽略了 3D 影像與放射科判讀流程,因此用 compositional and cascaded vision encoder 配合 Cascade Spatial-Aware Locality Fusion,把 2D 與 native 3D 醫療影像放進同一個 fused encoder。另一個關鍵不是只換模型,而是連評測也改寫:加入 MedIF-Bench 檢查 instruction following,並用 region-of-interest-grounded 方法評估報告生成的 factualness。

論文給出的成績相當進取:ClinFusion 在 24 個基準中有 20 個超過 Hulu-Med、Lingshu 等開源醫療 MLLMs,也在 16 個比較裡有 13 個勝過 GPT-5.2 與 Gemini-3-Flash。盲測部分由 board-certified radiologists 進行,報告排名亦拿到最佳,RoI-grounded metric 與專家判斷的相關性也最高,這點比單看自動分數更有說服力。

  • 可接受文字 prompt、2D 圖像路徑,以及 3D NIfTI volumes(.nii.gz)
  • 定位不是通用聊天,而是臨床導向的整體醫療理解
  • 核心取向是把 2D/3D 視覺編碼與臨床一致的評測一併重做
  • 已公開模型推理方向,但儲存庫資訊未完整交代部署流程與完整安裝細節

較適合留意這個項目的,會是做醫療 AI、放射影像、多模態研究或醫療報告生成評測的團隊。它的亮點在於把「模型看見了什麼」與「臨床上是否講得準」放到同一條線上;限制亦很清楚,現有 GitHub 資訊主要集中在作者主張與推理輸入格式,真正要落地到醫院工作流,仍要再看公開模型、硬件需求與後續工具鏈是否齊備。

GitHub · 模型

Categories: 開源, 清華大學, 阿里巴巴, 模型, 多模態模型, Qwen, Image, Medical醫學, 3D, 中國, Dataset 數據集

eeg-difflogic:邊緣 EEG 分類改用邏輯電路

這個項目把 EEG 分類從浮點神經網絡,轉向可直接編譯成布林電路的 Diff-Logic。你可以把它理解成一種更貼近邊緣裝置限制的做法,重點放在低延遲與記憶體壓力。

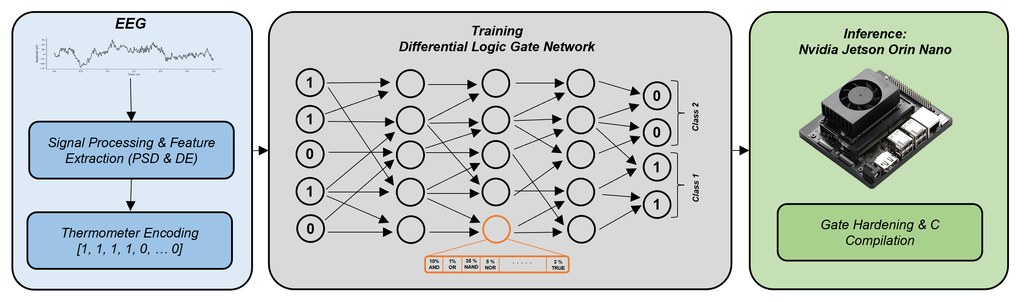
Workflow for EEG classification using differentiable logic gate networks

這份項目對準的是要在邊緣裝置即時分析 EEG 的場景,核心矛盾很直接:傳統神經網絡雖然準,但浮點運算和記憶體開銷會拖慢部署。它屬於研究型工具/框架,處理的是把 Differentiable Logic Gate Networks (Diff-Logic) 用在 EEG 分類,並在推理階段編譯成 Boolean circuits,以 bitwise CPU operations 跑得更輕。

作者同時看了兩類任務:臨床失智分類與情緒辨識。前者用 Power Spectral Density (PSD),後者用 Differential Entropy (DE),再配合 fold-wise Min-Max normalization、thermometer encoding 和多層 differentiable logic gates,最後把學到的 soft gates 硬化成可執行的布林電路。

和 Multi-Layer Perceptrons (MLPs) 及 Binarized Neural Networks (BNNs) 比起來,這個項目不追求單純堆大模型,而是用 iso-parameter evaluation 去看同等參數量下的表現與效率。論文報告在 dementia screening 上 Diff-Logic 拿到 80.2% Macro F1,較 MLP 高 6.8%;在 emotion recognition 上 MLP 準度略有優勢,但部署到 NVIDIA Jetson Orin Nano 單核心 CPU 時,延遲高 2.3 倍、模型體積大 14 倍。

  • 推理路徑清楚:先訓練,再轉成 Boolean circuits 做 inference
  • 適合關心低延遲、低記憶體、能在 edge device 跑的 EEG 系統
  • 評測覆蓋 CN vs. AD、CN vs. FTD,以及三類情緒辨識資料集
  • 在較大規模下,Diff-Logic 的推理時間幾乎保持不變
  • 這個項目最有價值的地方,不在於取代所有 EEG 模型,而是在資源受限環境下提供另一條更貼近硬件的路線

GitHub · Paper

Categories: 開源, 模型, NVIDIA, 框架, Medical醫學, Dataset 數據集

CrisperWhisper 把語音逐字稿變成可控制輸出

同一段錄音,可以要逐字保留停頓與口吃,也可以要乾淨可讀版本。CrisperWhisper 把語音辨識最常混在一起的兩種需求分開處理。

Repository image for nyrahealth/CrisperWhisper

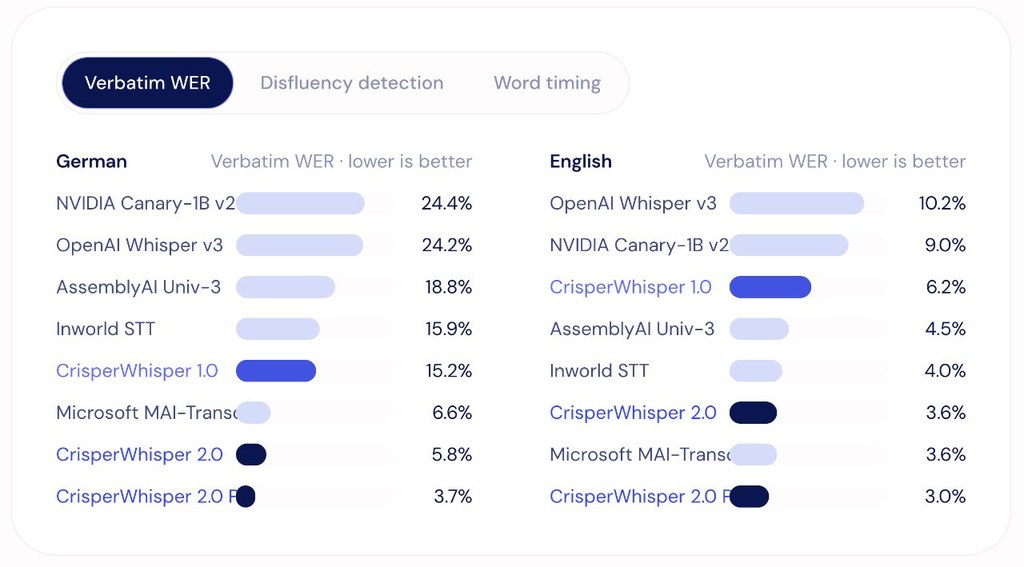
做會議紀錄、訪談整理或臨床語音分析時,最大落差往往唔係辨識到幾多字,而係系統究竟寫出「講咗乜」定「本來想表達乜」。CrisperWhisper 屬於開源語音辨識模型項目,核心價值係將 verbatim 同 intended 兩種轉錄模式變成可明確控制的輸出,令逐字稿唔再受訓練資料風格左右。

呢個取向同一般 speech-to-text 系統好唔同。常見做法會不一致地刪走 filler、重複、停頓同 cut-off,CrisperWhisper 2.0 就刻意保留呢啲語音細節,或者按需要輸出整理後版本;同一段錄音可以得出兩份用途完全不同嘅文本。對做 TTS 資料整理、醫療或研究訪談分析、需要精準字幕時間碼嘅團隊,呢種分流比單純追求可讀性更有用。

項目另一個關鍵位係時間對齊同長音訊處理。它提供 word-level timings,讀稿語音平均邊界誤差約 30 ms,對話語音約 41 ms;長音訊則用 conditional continuation 避免一般分段轉錄常見嘅重複漏字。README 亦提到推理端基於 CTranslate2,配合 speculative decoding,同時減輕 Whisper 常見 looping-hallucination 問題,方向明顯係朝住 production inference。

  • verbatim 與 intended 兩種模式分開控制,適合同一錄音對應不同工作流
  • 支援 multilingual,覆蓋多數 Whisper 支援語言
  • 可用 Verbatimize 依據音訊加乾淨文本補回真實語氣詞與口誤
  • 長音訊轉錄著重連續性,減少 chunk 邊界造成嘅錯漏
  • Nyra Verbatim Speech Benchmark 以 disfluency F1 等指標衡量保真能力

安裝與部署方向相對清晰:模型可經 PyPI、Hugging Face 同文件使用,推理路線圍繞 CTranslate2 runtime,而唔係只停留喺研究展示。要留意嘅取捨亦好直接,當你要的是可讀、可發布文本,intended 模式更合適;當你要保留猶豫、重複、笑聲同語音事件,verbatim 模式先真正發揮價值。呢個項目唔係單靠更高 WER 成績去吸引人,而係重新界定逐字稿應否忠於說話表面形式,並且用 benchmark 將呢件事量化。

項目主頁 · GitHub · 模型

Categories: 開源, 文字轉語音, 模型, NVIDIA, Medical醫學, 語音, Dataset 數據集

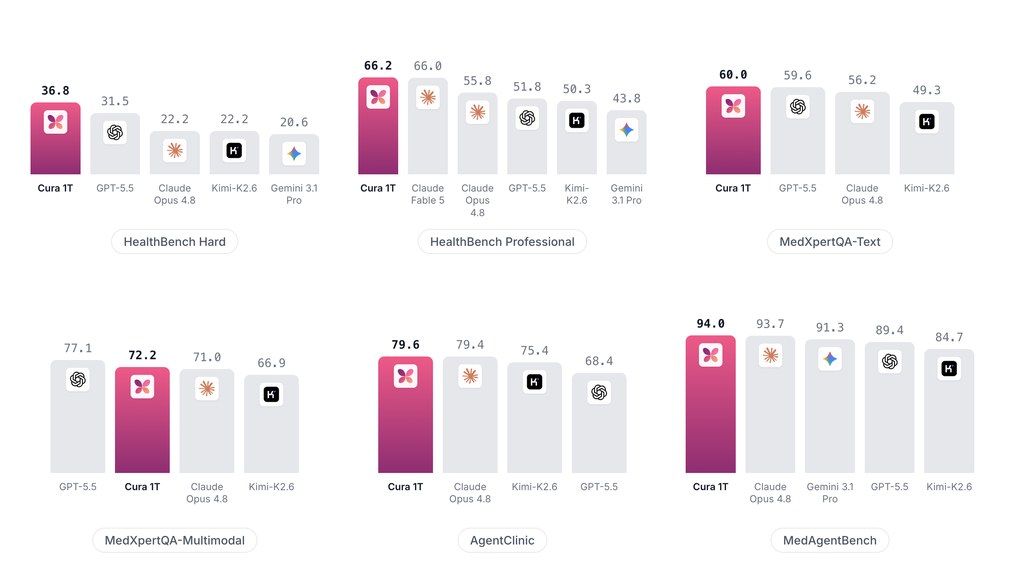
Cura 1T 瞄準醫療代理工作流

Cura 1T唔只想答醫療問題,而係朝住診療對話、臨床推理同 EHR 操作一條龍處理。對想評估醫療 Agentic 能力嘅團隊,呢個項目值得細看。

main comparison

醫療場景最難處理嘅,往往唔係單次問答,而係要連續對話、讀文字同影像、再連到 EHR 做操作。Cura 1T 就係朝住呢種 Agentic healthcare 用途打造嘅大型模型,重點不在通用聊天,而在病人諮詢、臨床推理同 FHIR-based record operations 呢三類高風險任務。

同類模型多數以通用能力再加醫療微調去應付需求,Cura 1T 則明顯押注 recursive self-improvement:由 training agent 規劃目標能力、訓練、沿 benchmark trajectories 找失誤,再調整 data mixture,而且每輪都有人類決定 keep-or-revert。呢個取向反映佢想解決嘅不只是知識覆蓋,而係醫療流程中跨回合、跨工具、跨模態嘅穩定度。

現階段最實際係經 OpenAI-compatible API 接入,model id 為 actava/cura-soar;公開資訊未見完整開放權重,較似面向企業試用與系統整合,而唔係本地自行訓練或離線推理。對醫療機構、健康科技團隊,或者要做 EHR、care management、行政自動化項目嘅開發者,呢種交付方式會較直接。

  • 以醫療模型定位,但核心賣點其實係 agentic workflows
  • 支援 text + vision,同時提供 256K context,適合長病歷與多模態判讀
  • 基於 Kimi-K2.6 後訓練而成,並非由零開始訓練
  • 基準測試在 6 個 healthcare benchmark panels 之中領先 5 項,但 MedXpertQA-Multimodal 仍落後 GPT-5.5

表現:HealthBench Hard 36.8、HealthBench Professional 66.2,亦在 AgentClinic 與 MedAgentBench 略勝 Claude Opus 4.8;相對 base model Kimi-K2.6 亦有明顯進步。要留意嘅限制係,分數來自 technical report 指定 protocol,而且 API 仍需排隊申請,現階段更適合做能力評估、流程驗證同企業整合規劃,未算係隨手可用嘅開源醫療模型。

項目主頁 · GitHub · Paper

Categories: 清華大學, Agentic, 多模態模型, API, Medical醫學, Dataset 數據集, Kimi

MonkeyOCRv2 文件通用 OCR 底座

掃描文件、表格、公式到場景文字,往往要分開處理。MonkeyOCRv2想做的是用同一套視覺編碼器,接住多語言文件理解與 OCR 工作流。

overview

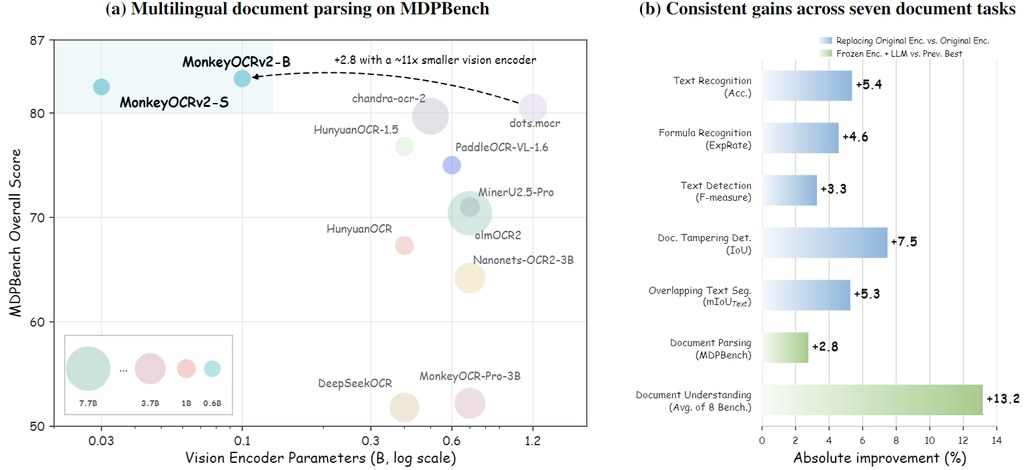
文件 AI 最麻煩的地方,在於文字辨識、版面解析、文件理解、公式辨識,甚至竄改檢測,很多時都要拆成幾個模型串起來。MonkeyOCRv2 把自己放在視覺文字基礎模型的位置,核心不是只追單一 OCR 指標,而是想用同一個 encoder 同時覆蓋多語言文件 parsing、understanding、text recognition、formula recognition 以至 scene text detection。

它採取的路線很明確:不像部分做法會按任務各自訓練小模型,MonkeyOCRv2 強調 fine-grained text modeling、cross-task representation learning 同 cross-lingual generalization,等於先把「文字作為視覺內容」這件事學得更深,再把能力分流到不同文件任務。這種取向的好處,是同一套底座較適合研究團隊或產品團隊整合工作流;代價則是現有資訊仍以模型發布為主,完整效能對比與部署細節還要結合論文與 checkpoint 再判斷。

現階段最值得留意的,是項目已不只放出單一模型名稱,而是分成幾條較清晰的能力線。 MonkeyOCRv2 vision encoder,以及面向 multilingual document parsing 的 MonkeyOCRv2-Parsing、面向 efficient document understanding 的 MonkeyOCRv2-Und,並提供 Hugging Face 與 ModelScope checkpoint,代表測試方式大致會圍繞下載權重後,按任務接入 parsing、recognition 或 understanding 流程,而不是單純打開一個聊天介面就完成。

  • 涵蓋 OCR、文件理解、公式辨識、竄改檢測、重疊文字分割等多類任務
  • 提供 MonkeyOCRv2-S、MonkeyOCRv2-B、MonkeyOCRv2-AS,不同 backbone 對應不同場景
  • S、B 版本偏向 Recognition / Parsing / Understanding,AS 版本偏向 Detection / Segmentation
  • 已公開 Demo、Hugging Face 集合與 MonkeyDocv2 數據集線索,方便交叉驗證

從現有公開資訊看,這個項目較適合做 Document AI、智能審核、票據與表單處理,也適合想比較 dots.mocr、PaddleOCR-VL、Qwen3-VL 這類路線差異的人。它未必是最輕量的選擇,但「一個編碼器橫跨多任務與多語言」這個方向,對需要長期維護文件工作流的項目有相當吸引力。

GitHub · Paper

Categories: 開源, 模型, 多模態模型, Qwen, OpenAI, 影像處理, 框架, Medical醫學, Dataset 數據集

AMID 把醫學影像建模流程交畀代理協作

AMID唔係只幫你諗模型,而係想連驗證、提交物料同審計痕跡一併產出。你可以把它理解成面向醫學影像比賽與研究任務的自動化建模工作流。

AMID logo

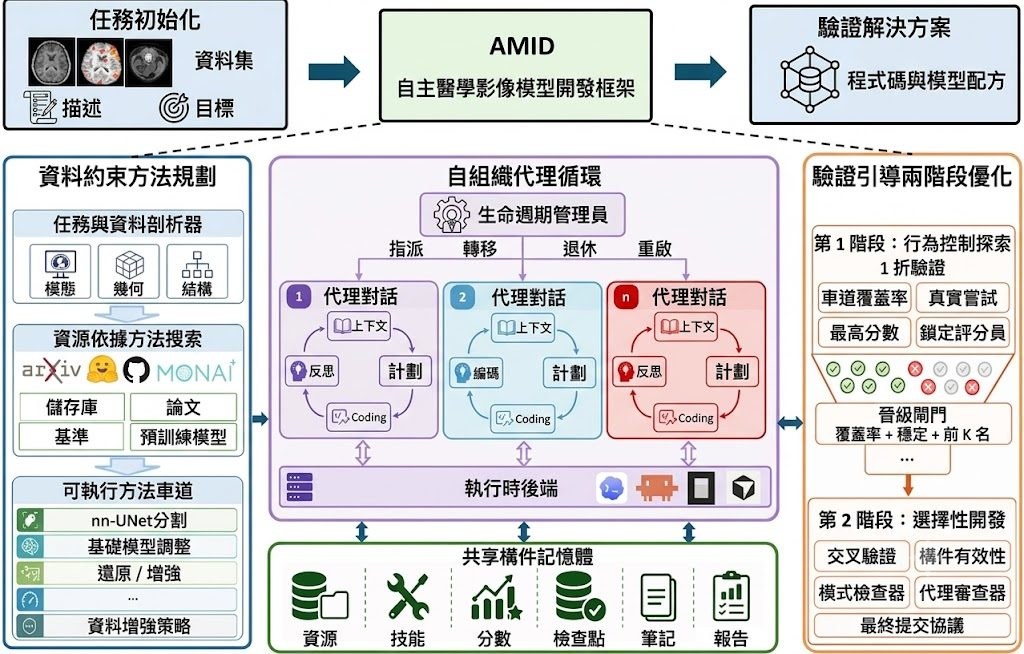
醫學影像建模最麻煩的位,往往唔係只係揀網絡,而係每個任務都有唔同資料形態、指標、切分規則同提交要求。AMID把呢個痛點拉到枱面:它屬於一個 autonomous multi-agent framework,目標唔係產生一段建議文字,而係交出可訓練、可推理、可驗證、可提交的完整模型產物。

現有通用 MLE agent 往往沿用比較粗略的搜尋與試錯範式,先提方案、再寫碼、再靠結果反覆修補;作者認為放到醫學影像場景,呢種做法容易忽略資料條件、驗證協議同提交格式。AMID改用 Data-Conditioned Method Planning,先按任務資料與可運行資源整理出可執行的 method lanes,再用 Verification-Guided Two-Stage Optimization 由早期廣泛探索,轉去後期集中追蹤有潛力路線,同時持續檢查 metric computation、validation protocol 同 prediction artifacts。

呢種取向的差異,在於它把「做得出分數」同「流程可核對」放埋一齊處理。對醫療 AI 團隊、挑戰賽參賽者,或者要同時管理 2D 影像、3D volumes、segmentation masks、class labels 等異質資料的人,AMID的吸引力在於減少人手串接流程的時間;代價是它目前仍以技術報告與任務解法報告為主,README亦寫明 source code 尚未釋出,暫時未到可以直接部署測試的階段。

效能方面,AMID用 ReX-MLE 的 20 個 medical imaging challenge tasks 做基準,比較對象包括一般用途 MLE systems,同時拿 human-designed challenge solutions 作參照。作者指出它整體表現優於被評測的通用系統,部分任務接近或追平人手設計方案;現階段較適合把它理解成一套清晰的方法論與工作流藍圖,而唔係即裝即跑的開源工具。

  • 核心定位係 autonomous multi-agent framework,處理醫學影像模型開發與驗證交付
  • 主要方法包括 Data-Conditioned Method Planning 同 Verification-Guided Two-Stage Optimization
  • 輸出唔止模型建議,仲包括 training code、inference code、weights、prediction files 同 audit trail
  • 基準測試來自 ReX-MLE 的 20 個任務,整體表現優於通用 MLE systems
  • 目前已公開 technical report 同 20 份 solution reports,source code 尚未發布

相關模型與系統脈絡方面,AMID直接對比的是 general-purpose MLE systems,同時以 human-designed challenge solutions 作為高水位參考。它未有把重點放在單一 backbone 或某個固定醫學影像模型,而是把多代理規劃、優化與驗證流程包成可重複的方法,呢點比單次調參工具更值得留意。

GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 多模態模型, 模型訓練, 微軟, Image, 影像處理, 框架, 香港, Medical醫學, 3D, Dataset 數據集

MedPMC 把醫學圖文資料做成可訓練基座

想做醫學影像與文字理解,卡位通常唔係模型,而係乾淨又夠大的圖文配對。MedPMC 把這件事連同訓練流程一併開放,方向相當務實。

Repository image for Yale-BIDS-Chen-Lab/MedPMC

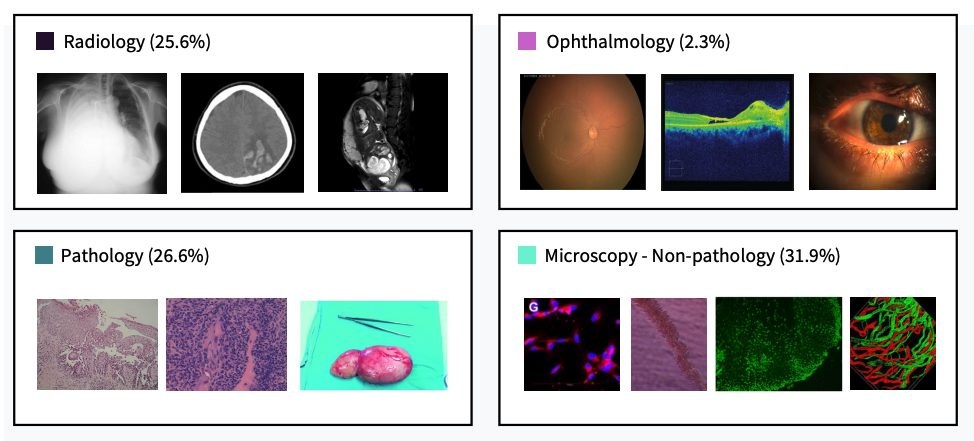
做醫學多模態模型,最難往往不是再堆一個新架構,而是先整理到可用的圖文資料。MedPMC 屬於Dataset 數據集加模型訓練程式碼項目,核心價值是把 PubMed Central (PMC) 文獻中的醫學圖片與文字抽取、清理,再接上訓練與評估流程,處理的是醫學 vision-language 資源長期分散、難重現的問題。

目前最值得留意的是 MedPMC Dataset 首個版本,提供約 1,100 萬組 medical image-text pairs;同時亦有基於 MedPMC-11M 訓練的 MedPMC-CLIP。這種做法與不少只放模型權重、或只交出資料連結的項目不同,它把 dataset curation、preprocessing、model training、evaluation 放在同一個代碼庫,較適合研究團隊沿住同一條流程再做微調或重跑實驗。

部署與測試的理解方式很直接:資料集與模型都已放到 Hugging Face,現階段較像給研究者先下載資料、檢查抽樣品質、再接入自家訓練管線。README 未提供很完整的操作文件,dataset viewer 亦未必可直接預覽,所以短期內它比較偏向有 Python 與資料處理能力的團隊,而不是即開即用的線上服務。

  • 約 1,100 萬組來自 PMC 的醫學圖文配對,是項目現時最重要資產
  • 連同 MedPMC-CLIP 一併釋出,方便由資料走到模型驗證
  • 重點不在花巧介面,而在可重現的資料整理與訓練流程
  • 文件仍在補完中,benchmarks 與更多 training recipes 尚待發布

以現有資訊看,MedPMC 的強項是規模與研究流程整合,限制則是文件與基準結果仍未齊備,暫時較難單靠公開頁面判斷模型表現上限。對醫學 AI、視覺模型、RAG 前處理,或需要建立醫學圖文檢索基座的團隊來說,這個開源項目已有不錯參考價值;相關模型現時可確認的是 MedPMC-CLIP。

項目主頁 · GitHub · 模型

Categories: 開源, RAG, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Image, Medical醫學, Python, Dataset 數據集

Page 2 of 6
1 2 3 4 … 6