Galahad:12B 凍結模型零解碼作答的工業經驗

你可以把它理解成:模型不重新推理,而是直接重用已驗證過的求解結果,每次都一模一樣,而且不耗 GPU。

Repository image for corbenicai/galahad-bench

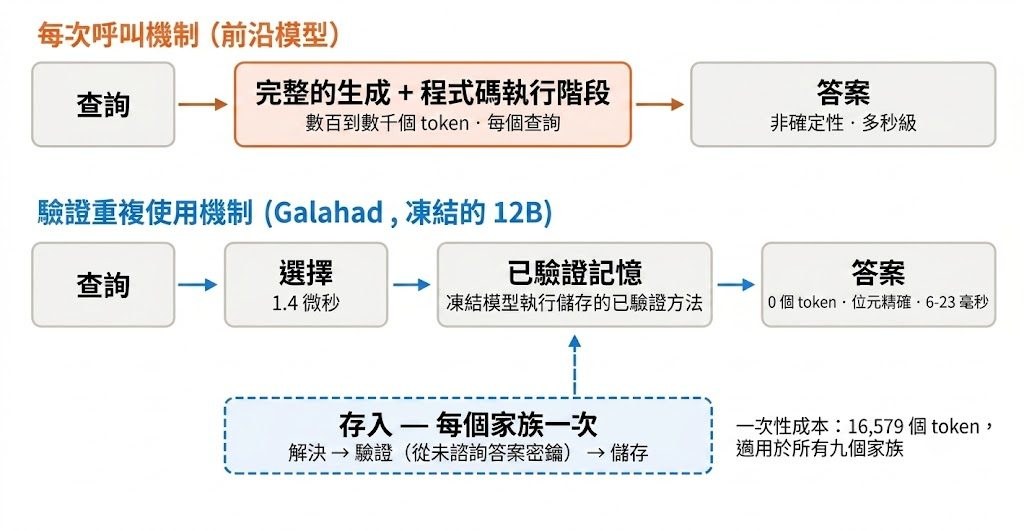
這套 Galahad 系統背後的關注點很直接:今天要提升語言模型,就要重訓練,每次都得重新生成答案,既貴又隨機。他們選擇反向操作——模型參數完全凍結,只在旁邊持續累積已驗證的解題記憶。同一個 12B 模型,對於已處理過的題目家族,直接命中記憶中的求解器,整數級精確一致,每次結果都完全相同,而且生成 token 數為零;對於新題目,則照常從零推理解答。系統聲稱在 180 個全新題目、橫跨九個題目家族上,讓四個來自不同供應商、架構各異的開源模型全部拿到 180/180,並且每次回答都不耗任何生成 token。

這個做法最值得留意的,是它對「記憶」一詞的重新定義。系統內部存的是可被獨立外部 oracle 自動驗證的執行式解題結果,不是用相似度檢索找出來的近似片段。作者在特別批評了業界慣用的近似向量相似度檢索:在一個 4,500 條已驗證答案的庫上,這種方法有 94.3% 機率選錯項目,而精確定址則零錯誤。換句話說,對於可驗證、可執行的知識,相似度近似檢索不是表現稍差,而是幾乎不可用,精確定位是必須的設計前提,不是可選偏好。

對於要部署閉環計算、形式化證明、程式碼執行這類可驗證任務的團隊,這套思路很有吸引力:記憶檢索耗時約 1.4 微秒,完整重用流程 6 至 23 毫秒,每次重用只耗 36 毫瓦時電力,相對於一次性求解兼驗證所需的 81.1 瓦時,節能差距明顯。模型本身不重新訓練,能力靠記憶累積,這對想控制運算開支、又需要可重現輸出的場景,例如 CI 中的程式生成或單元測試,是務實的取捨。

但限制也要看清楚:作者指出在公開基準的從零推理上,前沿模型依然遠勝任何 12B;Galahad 的強處是對「已被系統解決並驗證過」的題目家族做到零成本重用,不等於通用智能提升。負面控制也排除了另一種解釋——把記憶清空,系統一道也解不出來,這進一步確認能力確實來自記憶層,不是模型本身突然變聰明。對於想關注的是開源權重能否落地到工業管道的讀者,這份來自 Corbenic AI 的工業經驗報告值得留意,因為它把「訓練之外如何持續累積能力」這條路寫成了可量化的章節。

  • 模型凍結,能力改由外部已驗證記憶承擔,180 題零 token 滿分
  • 精確定址取代向量相似度檢索,在 4,500 條庫上錯誤率 94.3% 對 0%
  • 重用耗時 6–23 毫秒、每次 36 毫瓦時,對比一次性求解 81.1 瓦時
  • 開源模型架構無關:四個不同 dense 與 MoE 模型皆達 180/180
  • GitHub 目前僅放測試頁占位,引擎源碼尚未公開釋出

GitHub · Paper

Categories: 開源, Qwen, DeepSeek, Gemini, 框架, Dataset 數據集

ClinFusion 把醫療影像讀懂再回答

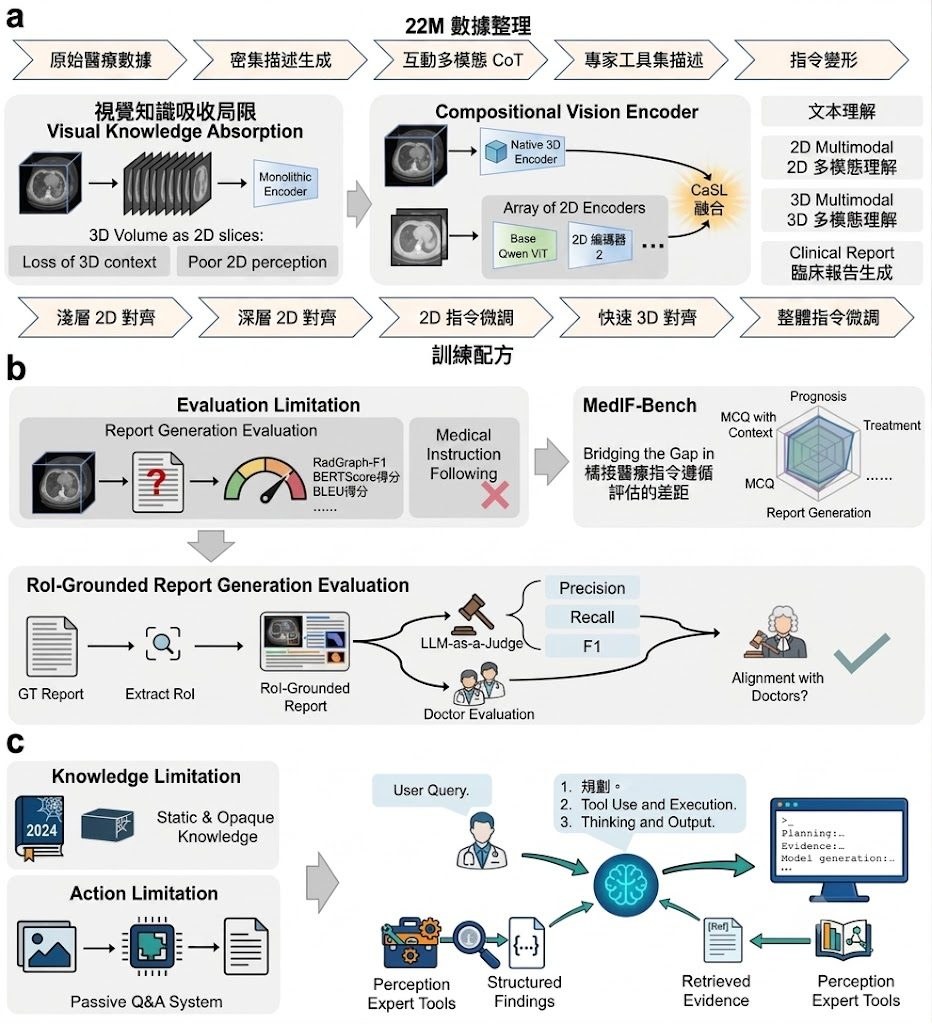
ClinFusion瞄準的不是一般聊天,而是把2D與3D醫療影像連同文字指令一併理解。它想解決的重點,是醫療多模態模型常見的看得多、答得快,卻未必貼近臨床判讀。

radar chart

醫療多模態模型最易失準的位置,往往不是會不會答,而是有沒有真正對準影像內容。ClinFusion屬於模型,更準確地說是面向臨床理解的 vision-centric Multimodal large language models (MLLMs) 系統,重點放在同時處理 2D 圖像、原生 3D NIfTI 影像與文字任務,減少只靠文字對齊時常見的臨床細節流失。

現有做法常把醫療問題當成一般多模態問答處理,但作者認為這種範式忽略了 3D 影像與放射科判讀流程,因此用 compositional and cascaded vision encoder 配合 Cascade Spatial-Aware Locality Fusion,把 2D 與 native 3D 醫療影像放進同一個 fused encoder。另一個關鍵不是只換模型,而是連評測也改寫:加入 MedIF-Bench 檢查 instruction following,並用 region-of-interest-grounded 方法評估報告生成的 factualness。

論文給出的成績相當進取:ClinFusion 在 24 個基準中有 20 個超過 Hulu-Med、Lingshu 等開源醫療 MLLMs,也在 16 個比較裡有 13 個勝過 GPT-5.2 與 Gemini-3-Flash。盲測部分由 board-certified radiologists 進行,報告排名亦拿到最佳,RoI-grounded metric 與專家判斷的相關性也最高,這點比單看自動分數更有說服力。

  • 可接受文字 prompt、2D 圖像路徑,以及 3D NIfTI volumes(.nii.gz)
  • 定位不是通用聊天,而是臨床導向的整體醫療理解
  • 核心取向是把 2D/3D 視覺編碼與臨床一致的評測一併重做
  • 已公開模型推理方向,但儲存庫資訊未完整交代部署流程與完整安裝細節

較適合留意這個項目的,會是做醫療 AI、放射影像、多模態研究或醫療報告生成評測的團隊。它的亮點在於把「模型看見了什麼」與「臨床上是否講得準」放到同一條線上;限制亦很清楚,現有 GitHub 資訊主要集中在作者主張與推理輸入格式,真正要落地到醫院工作流,仍要再看公開模型、硬件需求與後續工具鏈是否齊備。

GitHub · 模型

Categories: 開源, 清華大學, 阿里巴巴, 模型, 多模態模型, Qwen, Image, Medical醫學, 3D, 中國, Dataset 數據集

Google 開源 GNM Head:更完整的人頭 3D 模型

做人頭 3D 建模時,最麻煩往往唔係外形,而係眼球、牙齒同舌頭呢類細節。GNM Head 把呢些結構一併納入,定位明顯唔止係傳統面部 3DMM。

GNM Teaser Image

只做臉部外殼,很多時已經唔夠用;去到動畫、重建同生成式影像控制,眼球、口腔同頭部姿態一旦分離得唔好,效果就會即刻穿崩。google/GNM 目前先開放的 GNM Head,屬於3D parametric statistical human model 項目,焦點是用更完整的人頭幾何表示,處理傳統 3D Morphable Models (3DMMs) 對內部 anatomy 覆蓋不足的問題。

這個項目的取向很鮮明:不只是追求一個可調參的人臉網格,而是把 head、face、neck、eyeballs、teeth、tongue 放進同一個生成式人體測量框架。作者在技術報告指出,現有公開模型多數只覆蓋外部幾何,亦容易受限於低保真掃描資料;GNM 則結合高解析 3D scans 與 anatomy-specific artist-made samples,並加入 ocular 同 intra-oral specialized sub-models,目的就是改善幾何品質同可控性之間的取捨。

現有儲存庫較像一個生態系入口,而唔係即開即用的單一應用程式。README 清楚列出 GNM Head 已提供 NumPy、JAX、PyTorch、TensorFlow 多後端支援,亦有 Linux、macOS、Windows 的 CI;但目前公開資訊以模型與技術報告為主,未見到很完整的產品化操作流程說明,所以較適合研究、角色生成、數碼人、3D 視覺或生成式影像控制團隊按其子目錄文件逐步接入。

  • 補足傳統 3DMM 常見缺口:不只外形,連眼球、牙齒、舌頭都可控
  • GNM Head 強調 identity、expressions、head pose 的 disentangled control
  • 同時支援 NumPy、JAX、PyTorch、TensorFlow,方便接去不同研究流程
  • 技術報告聲稱在 fitting target 3D face scans 達到 SotA 表現,但具體指標仍要回看原報告

它最吸引人的地方,在於把「可生成、可擬合、可作條件控制」三條路線拉到同一個模型家族內。現階段公開內容仍以 GNM Ecosystem 的起步版本為主,想拿來做完整 production pipeline,仍要自己判斷與現有重建、動畫或生成系統的整合成本;但作為高保真人頭 3DMM 的新基礎,這個項目的研究價值同延展空間都相當高。

GitHub · Paper

Categories: 開源, 模型, 多模態模型, Google, TensorFlow, Mac, 3D, Linux, Python, 語音, Dataset 數據集

FilmOps 將電影語言拆成可分析標籤

想認真分析影片鏡頭,而唔只看「好唔好睇」,FilmOps 提供一套更接近電影製作語言的開源方法。它將畫面拆成可讀標籤,方便做評測、整理同研究。

FilmOps logo

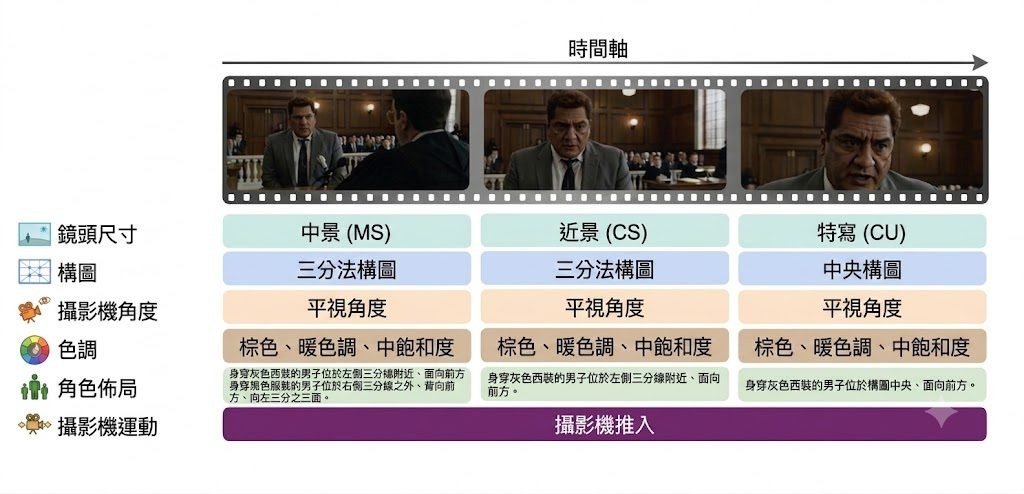
一段影片好不好,不一定只靠整體觀感判斷;鏡頭遠近、構圖、機位、色調同運鏡,往往先係影響觀感的核心。FilmOps 正正瞄準呢個缺口:它不是一般影片生成模型,而是一套開源 operator suite,用來把影片畫面映射成結構化的 cinematographic labels,處理的是電影語言難以被細緻分析與量化的問題。

現有影片 benchmark 多數集中在 general perceptual quality、text alignment 或 temporal smoothness,對專業 cinematographic language 仍然偏粗略;general-purpose MLLMs 又難以穩定辨認 film-specific attributes,而 aesthetic predictors 這類領域模型面對 cinematic content 亦有明顯 domain gap。FilmOps 的取向很清楚:不用單一大模型包辦所有判斷,而是把六個維度拆開,按任務特性分配不同 backbone,令 shot scale、composition、camera angle、color & tone、character layout 同 camera movement 可以分別處理。

它的價值在於更像一套分析管線,而不是只給你一個總分。項目覆蓋 55 個以上子類別,分類定義對齊 Film Art、ASC Manual、Cinematography: Theory and Practice,亦經過 practitioner 驗證;加上 modular architecture,可以獨立用單一 operator,或者走 unified pipeline。對要做影片生成評測、鏡頭標註、資料整理,甚至研究 FilmBench 呢類 cinematic benchmark 的團隊,這種拆解方式會比泛用多模態評分更有解釋力。

  • 屬於開源工具/模型組合,重點是把影片拆成電影語言標籤,而不是直接生成影片
  • 六個 operator 採用 task-specific backbone,包含 DINO ViT-B/14、BEiT Base、ResNet-18、InternVL3-14B
  • 支援 live-action、3D animation、2D animation 同 stylized content,強調 cross-genre consistency
  • 已交代基本部署條件,包括 Python、PyTorch、CUDA 與 ffmpeg,也提供 unified pipeline 與 checkpoints 準備方向

現有資料只明確指出它在所有維度都勝過 general-purpose MLLMs,但細節主要放在論文。配套的 FilmBench 亦用同一套 Cinematic Language 思路建立 benchmark,並聲稱 evaluator 在模型排名上與人工評分高度一致,說明 FilmOps 並非只為展示而做,而是服務整個影片評測流程。不過它始終偏向分析與標註基建,想直接拿來做完整產品,仍要自行處理 checkpoints 下載、推理資源,並接受部分 operator 對 CUDA 與較重模型的依賴。

GitHub · Paper

Categories: 開源, 阿里巴巴, AI productions, 多模態模型, NVIDIA, Gemini, 3D, Python, 語音, 動畫, Dataset 數據集

DriveDNA 將駕駛風格拆清楚

同一個人開唔同車、行唔同路,模型未必真係學到駕駛風格。DriveDNA正正用公開基準把呢個混淆拆開來驗證。

DriveDNA teaser

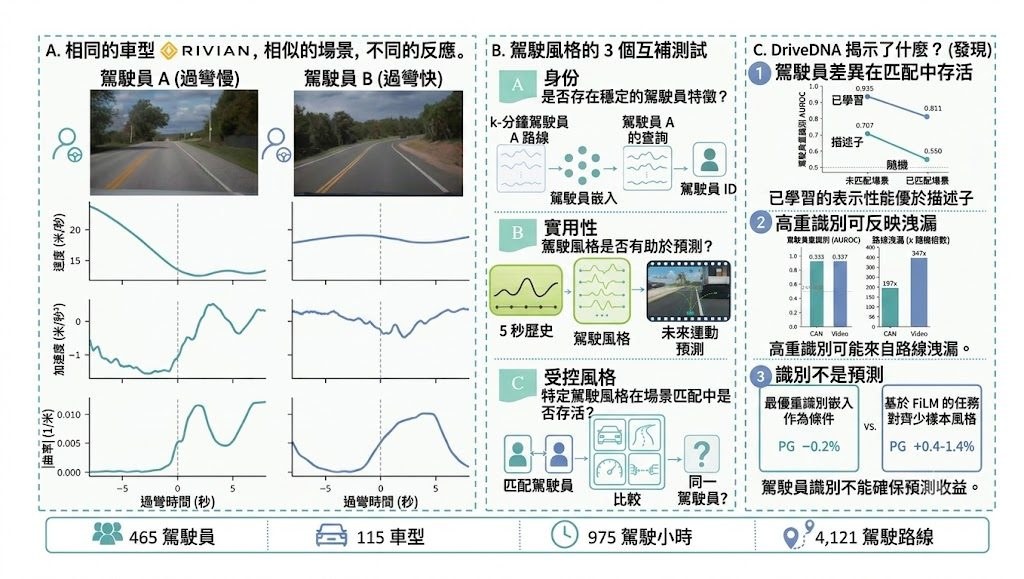
不少駕駛模型聲稱識別「駕駛風格」,但一換車款、路線或交通情境,學到的可能只是車主習慣路段與車輛特性。DriveDNA屬於多模態自然駕駛數據集與 benchmark,核心不是再加一批行車資料,而是把「邊個人在開車」與「開緊咩車、行緊邊條路」分開檢驗,直接處理個人化駕駛建模最常見的捷徑問題。

現有公開資源不是樣本太細、就是把車輛與路線幾乎固定,於是高分未必代表模型捉到穩定的個人風格。作者的做法更像重新定義評測:資料來自 465 位司機、115 款車、4,121 段駕駛,保留 CAN telemetry 與前向道路影片,並移除 automation-engaged frames,只留下 human-controlled driving,再配合 frozen evaluation protocol 與 leakage probes,要求研究者同時報告效用與洩漏風險。

它的價值在於評測不只看 re-identification 準唔準,還加入 personalized behavior prediction,以及在條件匹配下比較風格是否仍然存在。論文亦講得很直白:高 re-ID 可能只是 route leakage,能認出司機,不等於對未來行為預測更有幫助;相比只追單一識別分數,DriveDNA更重視模型有沒有學到可遷移、可解釋的駕駛表徵。

  • 規模夠大:465 位司機、975 小時 human-controlled driving、4,121 段駕駛
  • 模態完整:10 Hz CAN telemetry 配合同步前向道路影片
  • 評測設計針對混淆來源,明確檢查 vehicle、route、condition leakage
  • 倉庫已附 code 與 harness,但提供的是 benchmark 與研究流程,不是即插即用產品

私隱與資料治理亦寫得仔細:司機身份用 salted hashes,移除 VIN、裝置識別碼與 GPS,沒有車廂影片與音訊,受控影片版本會模糊人臉與車牌,並禁止 re-identification 與保險、就業、執法評分用途。較適合自動駕駛、駕駛行為建模、VLA 與多模態學習團隊拿來做表徵比較與洩漏檢查;現有資訊可確認倉庫附有 code & harness,但未見完整產品化安裝流程,重點仍是研究 benchmark 與可重現評測。

GitHub · Paper

Categories: 開源, 多模態模型, VLA, Dataset 數據集

ARI 用 RAG 修復韓國朝鮮古籍殘字

遇到人名、地名殘缺的古籍,單靠上下文往往會估錯。ARI把檢索到的史料一併交畀模型判斷,明顯更適合做歷史文獻修復。

Method Figure

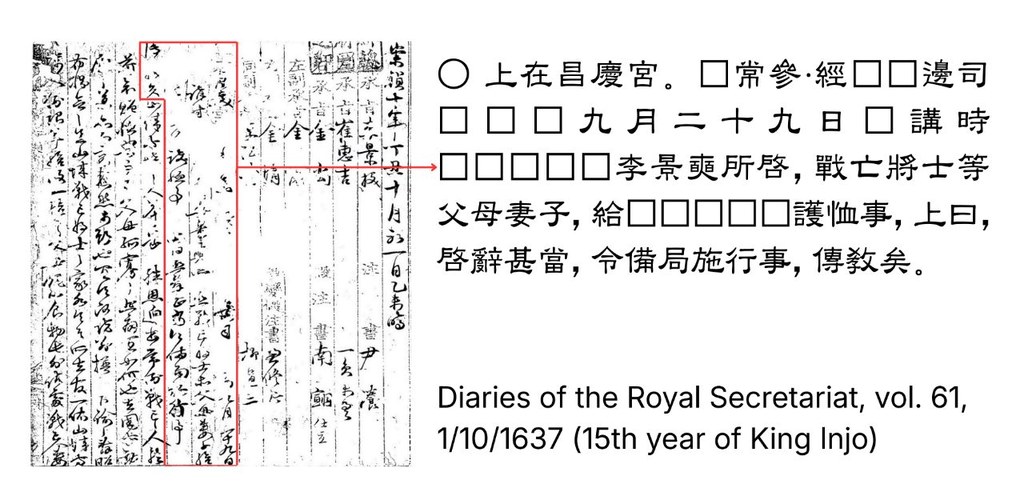
最值得留意的,不是模型把缺字補回來本身,而是它專門處理古籍修復最棘手的一類內容:人名、地名等 Named Entities。ARI 屬於一個結合 Retrieval-Augmented Generation(RAG)的文獻修復框架,針對朝鮮王朝實錄與承政院日記這類韓文漢字史料,補足只靠局部語境時經常失準的缺口。

現有做法多數依賴 masked language modeling,擅長根據前後文猜測一般字詞,但一遇到需要外部史實支持的專名就容易失手。ARI 的取向很清楚:先用 BM25 從歷史語料找出前 20 份相關文本,再以字串相似度 0.8 過濾重複內容,將這些外部證據交給模型一併生成,修正通用 LLM 容易出現的幻覺。

模型部分不是從零開始,而是建基於 Qwen3 32B 與 Qwen3 8B 微調成 ARI-32B 和 ARI-8B,並加入 25% named entity-prioritized masking 訓練策略,把學習重點放在知識密集片段。論文亦指出,對漢字材料而言,詞彙層面的 BM25 檢索比 embedding-based retrieval 更有效,這一點頗有說服力,因為表意文字的字形與字詞對應關係本身就影響檢索效果。

  • 適合歷史文獻整理、數位人文研究與古籍校勘團隊參考
  • 主要強項在於修復需要外部知識支撐的 Named Entities
  • ARI-32B 與 ARI-8B 同步提供,前者追求表現,後者較重視運算成本
  • 論文結果顯示,它在 named entity 與隨機遮罩字元修復都勝過多個基線與通用模型

把它視為一個已有公開模型與方法說明的研究項目。對需要先驗證效果的人來說,現階段較合理的路線會是先查看論文設定與模型頁面,再判斷是否足以接入自己的古籍修復工作流。

項目主頁 · GitHub · Paper

Categories: 開源, RAG, Embedding, 模型, Qwen, 語音, Dataset 數據集

JoyAI-Image 想做懂空間的影像模型

JoyAI-Image唔只想生圖,仲想令模型真正理解畫面入面物件點擺位、點互相關聯。對要做指令修圖、排版生圖同多視角內容的人,呢個方向幾有參考價值。

Repository image for jd-opensource/JoyAI-Image

改圖最怕模型聽得明文字,卻改壞原本場景結構;生圖亦常見字排得唔準、物件關係走位。JoyAI-Image就係朝住呢個痛點落手,定位屬於多模態基礎模型,把影像理解、text-to-image 生成同指令式編輯放入同一個模型家族,重點處理空間理解不足帶來的失真與失控。

唔係把理解模型同生成模型鬆散拼埋,而係用 8B Multimodal Large Language Model (MLLM) 配 16B Multimodal Diffusion Transformer (MMDiT),強調理解、生成、編輯之間的閉環協作。換句話說,模型唔只讀圖後再畫圖,仲會利用視角變換等生成結果反過來補強空間推理,呢點令它在 grounded generation、關係定位同可控編輯上有更鮮明方向。

現有公開內容顯示,部署路線算完整,已提供 Hugging Face 權重、Diffusers 版本、ComfyUI 原生支援,同埋可直接參考的 workflow;另外亦有 Spatial Edit 同 General Edit 示範空間。對內容製作、電商視覺、設計流程或者研究多模態編輯的人,較值得留意的是它不只處理單次修圖,仲想處理長文字排版、版面忠實度、多視角生成,以及「指定物件移去指定位置」呢類容易出錯的操作。

JoyAI Image Edit Plus in ComfyUI - How Does it Compare?
  • 把理解、生成、編輯整合到同一條多模態流程
  • 核心賣點係較強的 spatial intelligence,而不只是畫面更靚
  • 已有 Diffusers 與 ComfyUI 兩條使用路線,測試門檻較研究原型低
  • 延伸到 OpenSpatial data engine 同 OpenSpatial-3M dataset,反映它連資料與訓練配方都一併公開

效能方面,儲存庫描述集中在能力展示與訓練設計,現階段較適合把它理解成一個方向清晰、工具鏈逐步成熟的開源影像模型項目。最吸引之處唔係單一指標,而係它把空間理解當成生成與編輯的核心能力,對需要更穩定版面、關係同位置控制的工作流,確實比單講畫質更實用。

GitHub · 模型

Categories: 開源, ComfyUI, 模型, 視覺模型, 多模態模型, Qwen, Image, txt2img, Dataset 數據集

FinanceComplexQA 點評:金融長文件問答基準

想測試模型是否真係讀得懂財務文件,FinanceComplexQA比一般抽句式問答更貼近難題。它把中英雙語、推理、多步計算與文件依據綁在同一個基準內。

Finance-ComplexQA at a Glance

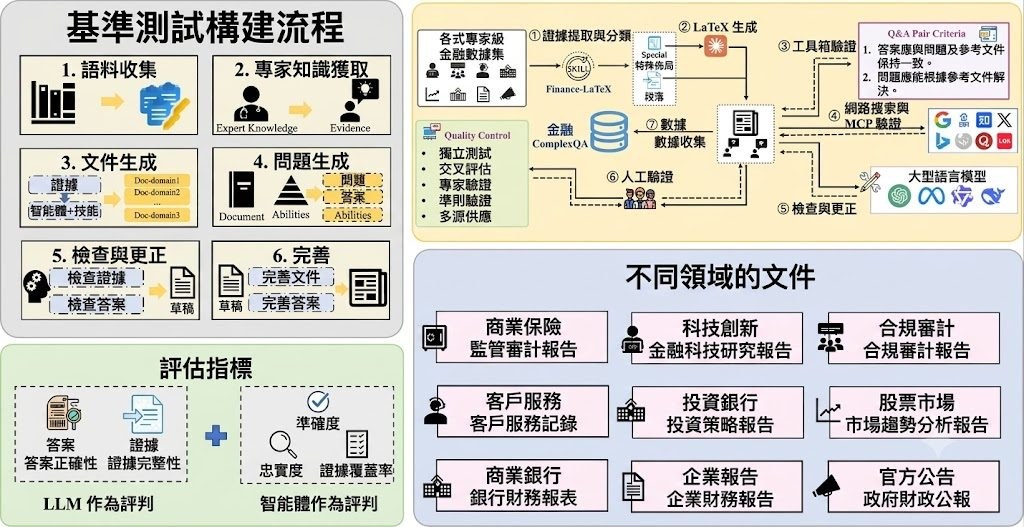
金融問答最容易失真的位置,不是模型識唔識術語,而是它會否真正在整份參考文件入面推理、比對同計數。FinanceComplexQA屬於數據集/Benchmark,焦點不是背答案,而是檢驗 LLMs 和 agents 能否根據完整 reference documents 回答複雜金融問題。

它修正了只靠 parametric knowledge 或抽取單一段落的評測範式。作者把重點放在 document-grounded complex financial QA,要求答案同問題及原始文件一致,並涵蓋 multi-hop reasoning、numerical calculation、comparison、implicit inference、planning、summarization 同 evidence-grounded verification,對 RAG、Agentic workflow 同長文本閱讀能力都有參考價值。

資料結構本身亦有取捨。FinComplexQA-Pro 收錄 2,026 組獨立 QA,按語言、金融場景與任務分類組織;同一題會以 scene_categories 與 task_categories 兩種視角出現,所以總記錄視圖有 4,052 筆。另有 overall 提供 agent_answer、agent_thinking 及 LLM-as-a-judge 分數,但這些分數只適合做診斷訊號,不能當 ground truth。

  • 支援中文與英文,但兩個子集覆蓋的文件領域不同,schema 亦不完全一致
  • 較適合逐個子目錄讀取 JSONL,而不是一開始合併全部資料
  • 可用 exact match、數值容差、F1、semantic similarity 等方法比對輸出
  • 附有 Reference_documents,方便追查 PDF 與 LaTeX 原文證據

部署和測試的理解方式相當直接:資料主要在 Hugging Face 發佈,研究團隊可先挑單一語言、單一 task category 載入,再把模型輸出對照 gold answer 或文件證據做評估。它較受惠於做金融 RAG、長文件 QA、Agent 評測或雙語研究的團隊;要留意的是金融事實具時效性,而且項目已明確標示僅供研究與評估,不應延伸成投資、會計、法律或財務建議。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, RAG, 多模態模型, 微軟, DeepSeek, 中國, Dataset 數據集

Color Pass-Through 重新做色彩校準

想令手機畫面更接近眼前真景,難處往往唔係相機或螢幕單獨夠唔夠準,而係兩者夾埋之後會一路累積偏差。Color Pass-Through就係針對呢個落差,將整條 camera-display 路徑一齊學起來。

Color Pass-Through teaser

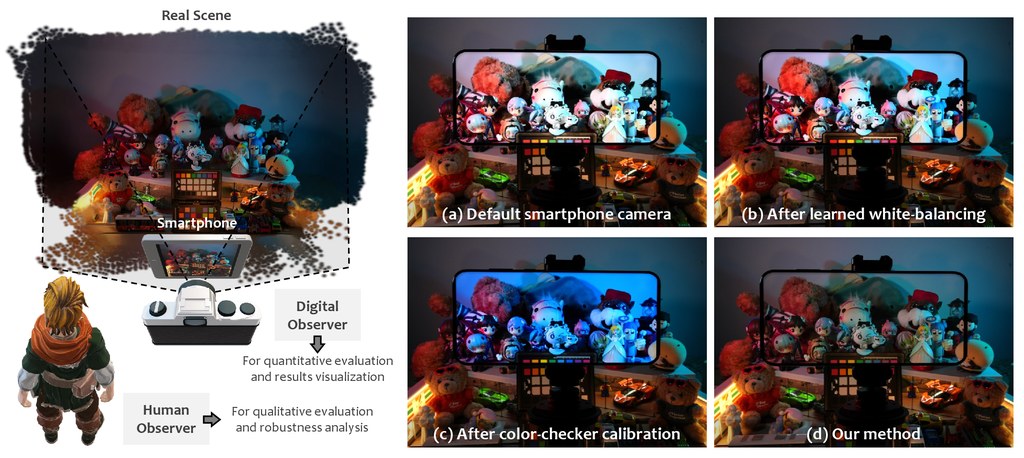
想像你透過手機或頭戴裝置睇現場畫面,明明場景喺眼前,畫面顏色同亮度卻總有一層隔膜。Color Pass-Through 針對的正正係呢種 camera-display 不一致:它屬於影像處理研究項目,以端到端方式學習固定裝置上的 camera-display 路徑,目標唔係單獨校正相機或螢幕,而係令人經過裝置觀看時,感知上更接近真實場景。

作者明確反對傳統 ICC workflow 呢種兩段式校準範式。舊做法會先分開處理相機同顯示器,再靠預先定義的中介色彩空間接駁,誤差容易逐步累積;Color Pass-Through 改為直接學完整投影路徑,並為每位觀察者做 one-step calibration。呢個取向的好處係更貼近人眼最終見到的結果,代價就係它依賴特定 device pair,同時帶有 observer-specific 設定,泛化方式同傳統標準化流程唔一樣。

目前公開資訊顯示,項目已放出完整 training and inference pipeline,並提供兩款支援裝置的 pretrained checkpoints,所以較合理的理解方式係:它首先係研究原型,其次先係可重現的程式碼。資料集仲準備公開,Android toy example 亦仍在開發中,部署重點暫時仍然放喺已支援裝置上重現論文結果,而唔係即插即用地套入任何手機。

  • 核心改動係把 camera 與 display coupling,唔再經固定中介色域分開校正
  • 以每位使用者一次校準換取更貼近主觀觀感的色彩與亮度表現
  • 人類評分提升 +2.0 分(5 分制),亮度 4.32/5,色彩 4.03/5
  • 定量結果亦有明顯優勢,PSNR、ΔE、STRESS 在兩款商用手機上都優於列出的基線

同類方法很多時會加強 white balance、ColorChecker mapping,或者在既有 ISP 後面再補一層修正;這個項目則直接把問題重寫成特定裝置、特定觀察者的整體感知重建。對做 AR/VR pass-through、顯示校準、計算攝影研究的人最有參考價值,尤其當重點唔係標準色彩流程有幾完整,而係人眼最後見到的畫面到底似唔似真景。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, 華為, 模型訓練, 蘋果, Dataset 數據集

ProVisE 用像素答案重做空間評測

空間理解唔一定適合用文字作答,ProVisE改咗評測入口,令圖像生成模型可以用畫、點、標記去答題。你會更易睇清楚,模型到底係唔識空間,定只係答題格式唔對。

ProVisE logo

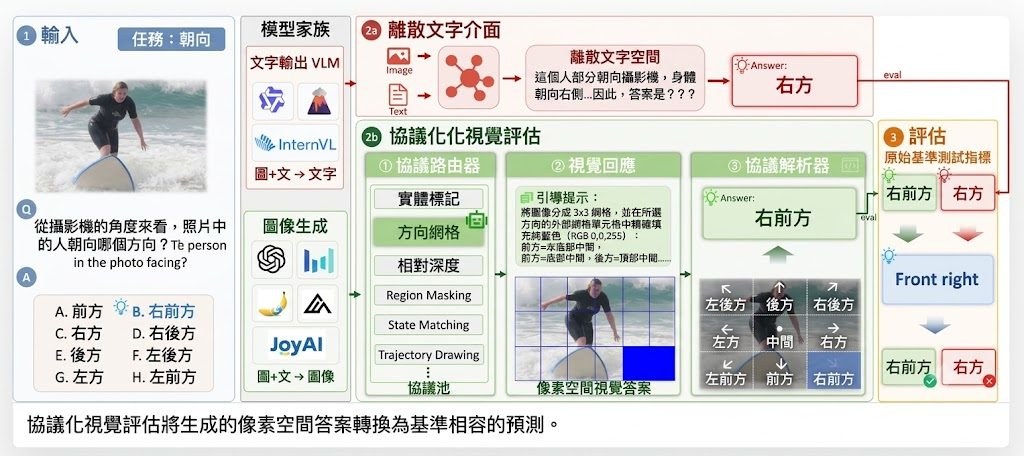
當一條空間題目本來應該用圈選、標記路徑或者遮罩去表達,硬要模型交出座標、選項字母或文字描述,結果往往唔係能力差,而係答題介面同模型表達方式錯位。ProVisE屬於評測框架,處理的正是呢個落差:它唔改原本 benchmark 任務本身,只改回應介面,讓圖像生成模型用像素空間交答案,再轉回 benchmark 可計分的結構化輸出。

現有 spatial benchmarks 多數沿用 text-only interface,假設所有模型都應該以 coordinates、option labels 或 textual descriptions 回答。作者認為這種固定範式會壓縮 regions、paths、affordances 呢類本身偏視覺的判斷,因此提出 Protocolized Visual Evaluation:先由 task-aware router 指派 visual protocol,再用固定 guidance prompt 同 parser 約束輸出,最後仍然交回 original benchmark metric 評分。Text-output VLMs 就維持原本答題空間,兩類模型可以在同一套任務語義下比較。

ZJU-OmniAI/ProVisE 在於把「模型唔識答」同「評測方法逼錯答案格式」分開處理。配套的 SpatialGen-Bench 收錄 470 個 curated samples,涵蓋 14 個 subtasks,同時分成 perception、understanding、reasoning、interaction 四個 capability levels;研究結論亦相當直接,image-generation models 在可把判斷外化成像素標記的任務上有競爭力,但 text-output VLMs 在另外一些題型仍然較穩定,兩者並非誰全面取代誰。

  • 保留原有 benchmark metric,只替換答案介面,方便同既有結果對照
  • 用 visual protocol 限制生成內容,減少任意畫圖帶來的解析歧義
  • SpatialGen-Bench 把空間能力拆成 14 個 subtasks,唔再只看單一總分
  • 適合研究 VLM、image-generation models、agent 空間理解能力的團隊採用

安裝門檻看來不高,程式環境以 Python 3.10+ 為主,並已公開 code、project page 與 Hugging Face 上的 SpatialGen-Bench。現階段它更像研究與評測項目,不是即插即用產品;重點也不在部署成服務,而是在你想驗證模型空間認知時,能否用更貼近模型輸出形式的方式做比較。對做多模態模型、視覺評測或 Agentic 系統的人來說,ProVisE提供了一個相當清晰的檢查角度。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 視覺模型, 多模態模型, Image, Python, Dataset 數據集

Page 15 of 29
1 … 13 14 15 16 17 … 29