Vidu S1 把即時互動影片拉近一步

對住數碼角色直接開聲指揮,畫面仲可以一路生成一路改,Vidu S1瞄準的正是這種近乎通話式的影片互動。它未必是最通用的影片模型,但在即時控制這件事上明顯有自己路線。

Vidu S1 Experience Preview

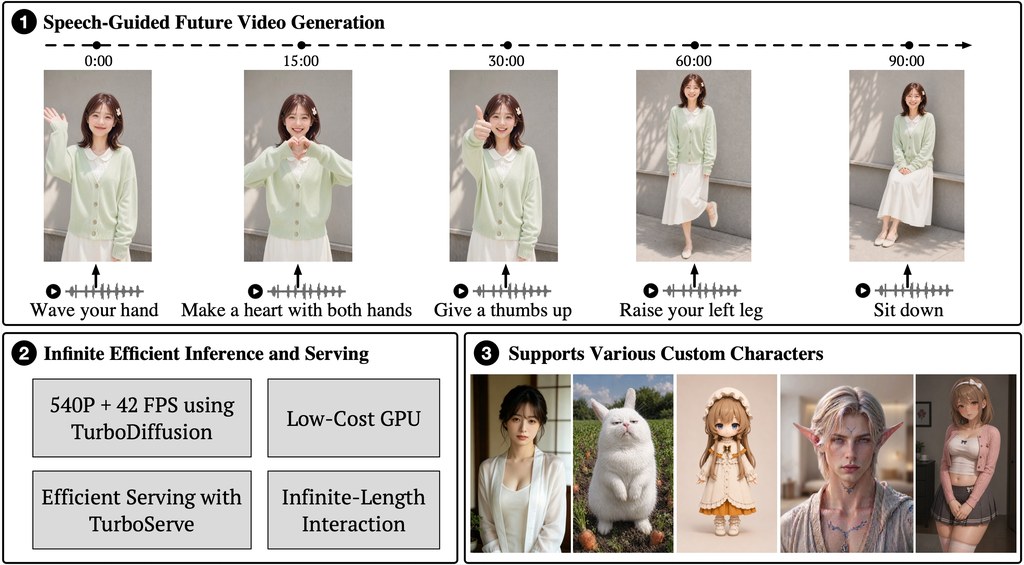
比起先寫好提示詞再等片段輸出,Vidu S1更接近一種可對話的視頻模型:你一邊講,數碼角色一邊跟住反應,處理的是「影片生成能否即時被人打斷、改向、持續延長」這個卡位。項目把重心放在 voice-controlled digital characters,而不是一次過產出完整短片,定位很清楚是互動內容而非傳統文生影片。

現有做法多數仍是 prompt-driven、片段式生成,用戶先提交指令,再等待固定長度輸出;作者主張這種範式難以支援 live interaction。Vidu S1改用 real-time speech control 與 infinite-length real-time interactive generation,讓角色在生成途中持續接受 spoken instructions,方向上更接近直播角色、虛擬主播和即時陪伴互動,而不是 cinematic clip 製作。

  • 支援以語音即時控制角色動作,重點在連續互動而非單次出片
  • 可自訂角色形象與 voice tones,涵蓋真人、二次元、寵物等 avatar
  • 官方資料提到 540p、最高 42 FPS,並可在 consumer GPUs 運行
  • 除了網頁體驗,也提供 API 文件,較適合接入互動產品流程

現有公開資訊較偏向服務化體驗:可先在 Vidu Stream 網頁建立角色、選擇或 clone 聲線,再開啟麥克風與鏡頭進行 live call;團隊要接入自家產品,則更可能經 API 而非直接本地完整重建。GitHub 儲存庫目前公開了論文、說明文件與入口,但未見完整本地訓練或推理流程,較像展示能力與提供接入方式的研究/產品型開源項目。

取捨也很明顯:它強調流暢、低延遲、可長時間互動,代表優先次序未必是最高解析度或最複雜鏡頭語言。受益最大的會是做虛擬主播、互動陪伴、角色扮演、品牌數字人和即時內容演示的團隊;要做電影感分鏡、長敘事剪輯或高度後期控制,現階段未必是它最強的一面。相關模型則包括 Vidu S1 本身,以及同一服務脈絡下的 Vidu Stream 互動入口。
項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 數字人, 視覺模型, 多模態模型, 視頻模型, API, Clone, 語音, Dataset 數據集

TAP:先學動作,再學指令的 VLA 路線

這是一個針對 Vision-Language-Action 模型訓練瓶頸提出的新框架。它用較少專家示範,換取接近大型資料訓練的操作能力。

TAP Framework Overview

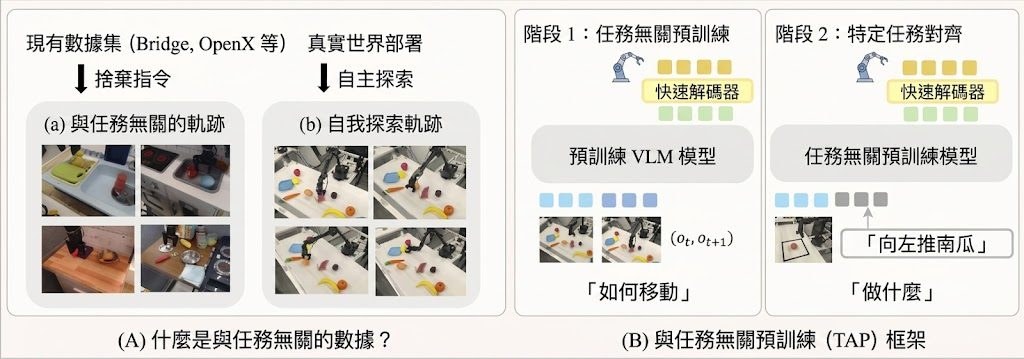
TAP(Task-Agnostic-Pretrain) 是一個 Vision-Language-Action(VLA)模型訓練框架,屬於研究原型兼訓練方法。它要處理的核心問題,是 VLA 長期依賴大量 expert demonstrations,導致機械操作能力難以用較低成本擴展。

現有做法多數直接把「how to move」與「what to do」一齊學,通常需要 observation、instruction、action 這類完整示範資料;作者認為這種固定範式混淆了 physical competence 與 semantic alignment 兩個目標,結果是語言標註被過度用喺本來可以自我監督學習的動作能力上。Task-Agnostic Pretraining(TAP)因此改成兩階段:先用無標註互動資料透過 self-supervised Inverse Dynamics 學 transferable motor priors,再用少量 expert demonstrations 做 task-specific alignment。

這種取向同標準 behavior cloning、以大量網路或專家軌跡堆出來的 VLA 路線唔同。TAP 的取捨很明確:它未必追求一次過把語義和動作全學齊,而是先把可遷移的「點樣郁」拆出來,換來更低標註成本,同時提高對背景、視角變化的穩定度;代價是整個方法仍然要靠第二階段示範去把語言指令對齊到具體任務。

項目已經交代了測試方式:這不是即裝即用應用程式,而是要跟住論文設定,載入 HuggingFace 提供的模型,重現兩階段訓練,再用 SIMPLER benchmark 與真實 WidowX-250s 場景驗證。數字上,TAP-20k 在 SIMPLER 的 Avg-All 為 33.32%,高過 Standard BC 的 23.15%;真實環境中只用 200 個 expert demos,面對 background texture shift 仍有 45% success,viewpoint variation 亦有 20%,而部分 baseline 會跌到 0%。

  • 用 self-supervised Inverse Dynamics 先學動作先驗,減少對語言標註依賴
  • 以約 30 小時 autonomous play 加少量 expert demonstrations,對比 1M+ expert trajectories 路線更慳資料
  • 在 SIMPLER benchmark 勝過 Standard BC,接近或超過部分現有 VLA 模型
  • 對 visual distractors、background texture shift、viewpoint variation 的抗干擾能力較強
  • 相關模型包括 RT-1-X、OpenVLA、Nora、Octo,以及 README 提到的 TAP-20k

項目較適合做 Embodied AI、robot learning、VLA 訓練流程研究的團隊參考,尤其係想用學術規模算力驗證新訓練路線的人。它現階段更像一套值得跟進的方法論,而唔係面向一般用戶的完成品工具。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, VLA, Robotic, 教學, Clone, Dataset 數據集

Higgs TTS 3:4B 多語語音生成模型

這是一個主打對話語音生成的 4B TTS 模型,支援 100+ 語言與 zero-shot voice cloning。並提供清楚架構與限制,但未見 GGUF 量化檔。

Og image

這是一個文字轉語音模型 Higgs TTS 3 4B;暫沒有標明它是基於哪個 base model 微調而成。它主要用來把模型回應轉成更接近對話風格的語音,而不只是朗讀文字,並支援 zero-shot voice cloning、情緒、語氣、停頓同 sound effects 控制。

模型核心是約 4B 參數的 autoregressive decoder,規格包括 36 layers、hidden size 2560,以及 GQA 32/8。音訊端先由 Higgs Tokenizer 編碼成 8 個 codebooks、25 fps 的 audio tokens,再透過 delay pattern、multi-codebook fused embedding 同 multi-codebook fused head 處理,最後還原成 24 kHz waveform;這種設計重點在於同時建模文字與音訊 token,讓語音表達更連續。

訓練序列長度為 8,192 tokens,對長句、多輪語音回應會有幫助。語言覆蓋超過 100 種,並提到 102 種語言做到單位數 WER/CER,其中 85 種達到低於 5 的水準,代表它不只追求可讀性,亦重視跨語言穩定度。

  • 定位清楚:偏向 voice chat 與 expressive conversational speech,而非單純 TTS 朗讀器。
  • 控制能力完整:可直接控制 emotion、style、prosody、pauses 與 sound effects。
  • 多語能力強:支援 100+ 語言,102 種語言有公開 WER/CER 描述。
  • 授權限制明確:只開放 research and non-commercial use,商業用途需另取授權。

模型未提供 GGUF 格式、量化級別、檔案大小、mmproj、llama.cpp、Ollama 或 LM Studio 支援資訊,也未見 v2 檔名變更、chat template 注意事項與 MTP draft speculation 相關內容;這些多數屬於 LLM 或多模態推理頁面常見資訊,並非此 TTS 頁面的重點。使用上更值得留意的是授權條款與風險限制,包括未經同意的 voice cloning、冒充、詐騙、選舉誤導與生物識別監控都被禁止。

項目主頁 · 模型

Categories: 開源, 文字轉語音, 模型, Audio, Clone, 語音

dots.tts:支持廣東話的連續式語音合成

dots.tts 係一個 2B 參數 TTS 項目,主打直接由文字生成自然語音。它同時強調聲線模仿、情感表達同多語言表現。

dots.tts

dots.tts 是一個文字轉語音(Text-to-Speech, TTS)模型,主要用來將輸入文字轉成自然語音,並兼顧聲線模仿同情緒表達。它採用全連續、端到端的自回歸(Autoregressive, AR)設計,整條流程都唔用離散 token,這點同不少傳統 TTS 做法有明顯分別。

項目提供本地模型目錄或 Hugging Face repo id 載入方式,亦有 CLI、Python API 同 Gradio 網頁示範可試。用 --prompt-audio 配合 --prompt-text 可以做延續式 cloning;只給 --prompt-audio 時則走 x-vector-only cloning;而 --language 可幫多語言或 code-switching 文字鎖定語言標籤。

这开源TTS 太狠了:3 秒复刻音色+情绪迁移,还能实时朗读!

它的取向偏向高保真同穩定生成,而唔係只追求速度。官方數據顯示,dots.tts 在 Seed-TTS-Eval 取得較佳平均表現,zh / en / zh-hard 的 WER 分別係 0.94% / 1.30% / 6.60%,MiniMax multilingual benchmark 亦有 83.9 的平均 speaker similarity,反映它在聲音相似度同多語言能力上都有競爭力。

較適合做語音產品原型、配音流程、虛擬人聲、以及需要少量參考音去複製語氣嘅團隊。要留意參考音大約 10 秒較合適,而且 --prompt-text 必須同參考錄音內容一致,否則穩定性會下降。

  • 2B 參數、全連續 AR TTS,核心目標係文字轉自然語音
  • 支援 voice cloning、多語言同情感表達
  • 提供 CLI、Python API、Web Demo,方便測試同部署
  • 評測上在 Seed-TTS-Eval 同 MiniMax multilingual 都有強勢成績
  • 相關模型包括 dots.tts-base、dots.tts-soar、dots.tts-mf

GitHub: https://github.com/rednote-hilab/dots.tts

模型: https://huggingface.co/collections/rednote-hilab/dotstts

Categories: 開源, 文字轉語音, 模型, API, Audio, Clone, Python NLP, Python, 語音

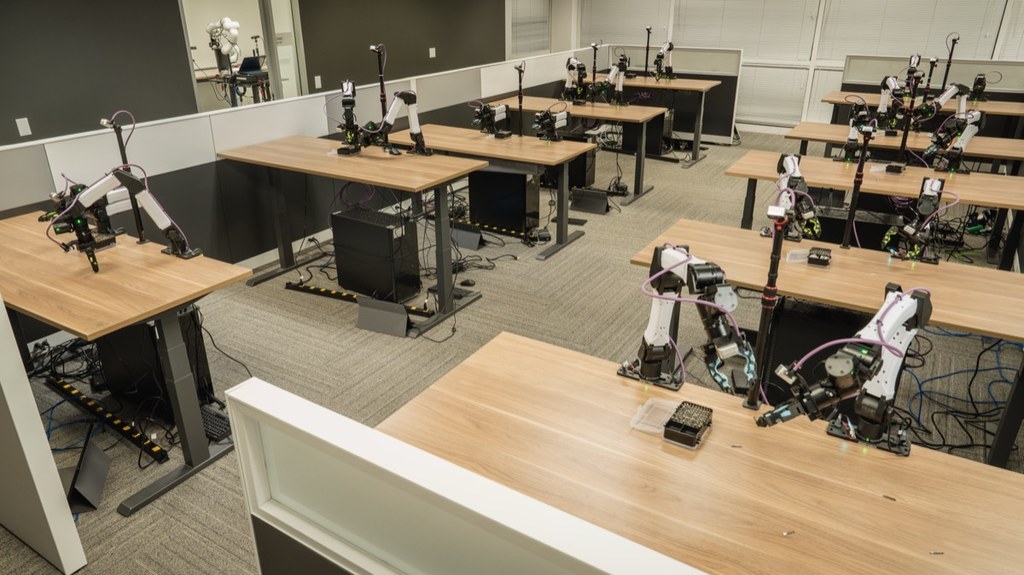
ENPIRE : NVIDIA 閉環系統訓練機械人自我改良

ENPIRE 把真實機械人訓練變成可反覆優化流程,讓 coding agents 直接參與改良策略。

NVIDIA

ENPIRE 是一個用於真實世界機械人策略自我改良的框架,重點不是單一模型,而是把「重設場景、執行策略、檢查結果、再改進」串成可重複閉環。它針對的問題很明確:靈巧操作任務一直很依賴人手監督與大量調參,令機械人研究難以擴展。

系統由四個模組組成:Environment(EN)負責自動重設與驗證、Policy Improvement(PI)負責發動策略改良、Rollout(R)負責在單機或多機械人上測試、Evolution(E)則讓 coding agents 分析紀錄、查閱文獻、調整訓練基建與演算法程式。與常見只在模擬器或純數碼環境做 agent 優化的方法相比,ENPIRE 把回饋迴路直接放到真實機械人上。

列出的案例包括 PushT、Pin Insertion、Tie Zip-tie 與 GPU Insertion,可見它瞄準的是需要精準操作的任務。按頁面描述,frontier coding agents 在這套流程下,可把部分真實操作任務推高至 99% 成功率,但不同任務、機械人配置與訓練設定之間仍可能有差異,閱讀時宜把它視為特定條件下的結果。

若想理解這個項目,可先從它的閉環結構入手,再看 Policy Improvement 支援哪些路線,例如 heuristic learning、tool calling、behavior cloning、offline RL 與 online RL。頁面亦提到 robot fleet scaling、simulation evaluation、auto evaluation 與 auto reset,反映這個項目不只關心模型表現,也在處理如何把測試與迭代流程自動化。

  • 核心價值:把真實機械人訓練流程標準化,減少人手介入
  • 主要差異:不是只生成策略,而是連同驗證、重設、改良一起自動執行
  • 適合讀者:機械人研究者、Agentic AI 開發者、關心自動化實驗流程的人
  • 已提方法:heuristic learning、tool calling、behavior cloning、offline RL、online RL

這項目較適合放在機械人學習、自主代理與真實世界實驗自動化的脈絡下理解。若你關心 Computer-use agents 或 coding agents 能否走出螢幕、直接管理物理系統的迭代流程,ENPIRE 提供了一個相當具體的方向。

項目: https://research.nvidia.com/labs/gear/enpire/

Categories: 開源, Agentic, 模型, 模型訓練, NVIDIA, Robotic, 框架, Vibe Coding, Clone, 編程


Page 2 of 2
1 2