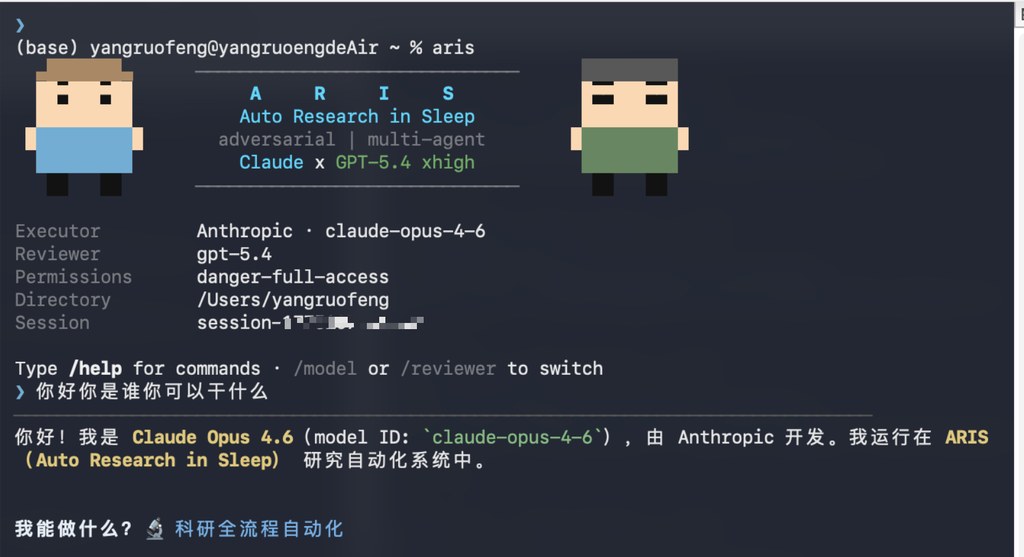
ARIS 讓 AI 研究流程可實戰觀察

ARIS 不只是自動寫作工具,更像是替研究代理加上審稿與稽核流程。它的價值在於降低「看似合理卻缺乏證據」的風險。

ARIS-Code CLI

ARIS 是一套面向研究工作的代理流程框架,核心不是單純自動生成內容,而是把想法探索、實驗執行、論文撰寫與回覆審稿意見串成可反覆檢查的工作鏈。它可作為 Claude Code、Cursor、Trae 的技能式工作流使用,也提供獨立 CLI,較適合需要長時間、跨階段協作的研究專案。

實際使用上,較合理的方式是把它視為研究助理編排層:先做 idea discovery,再接 experiment bridge、auto review loop、paper writing 與 rebuttal。專案特別強調跨模型家族的執行者與審查者分工;若需要特定模型,文件中明確提到可搭配 GPT-5.4 作為 reviewer,部分引用稽核流程也會透過 Codex MCP 路由使用 gpt-5.4。

這個專案最有辨識度的創新,在於它把「證據到主張」的驗證做成系統層能力,而不是最後才人工補救。除了實驗結果到論文敘述的對照,近期又補上 /citation-audit,檢查引用是否存在、書目資料是否正確,以及最重要的:被引用文獻是否真的支持當前論點,這比只查 BibTeX 完整度更實際。

另一個值得肯定的部分是工程細節相對務實。像技能安裝機制曾修正為扁平化佈局,避免 Claude Code 無法發現巢狀技能;Overleaf 同步則透過官方 Git bridge 串接,並把權杖隔離在 macOS Keychain,降低代理直接接觸憑證的風險。這些設計顯示作者關注的不只是功能數量,也包含可維護性與失敗復原。

  • 適合對象:需要長鏈研究流程、反覆修改論文、重視可追溯性的使用者
  • 主要價值:把審查、證據核對、引用稽核嵌入研究流程,而非事後補做
  • 實用亮點:研究 wiki、技能式工作流、審稿回合、自動論文改善與 rebuttal 支援
  • 理想場景:機器學習論文撰寫、實驗驅動研究、多人協作且需同步 Overleaf 的團隊

整體來看,ARIS 比較像研究流程的「治理框架」,不是一鍵產出論文的捷徑。若你的需求是提高研究代理的可靠性、保留脈絡並減少論點失真,它提供了相當完整而且偏嚴謹的路線;但若只想快速生成初稿,這套系統可能會顯得偏重。

Source: https://github.com/wanshuiyin/Auto-claude-code-research-in-sleep
Categories: 開源, Agentic

X2SAM把影像與影片分割整合成單一模型

X2SAM將影像與影片分割整合到同一套多模態架構中,支援文字指令與視覺提示。它也強調影片遮罩的一致性與跨任務通用性。

HuggingFace

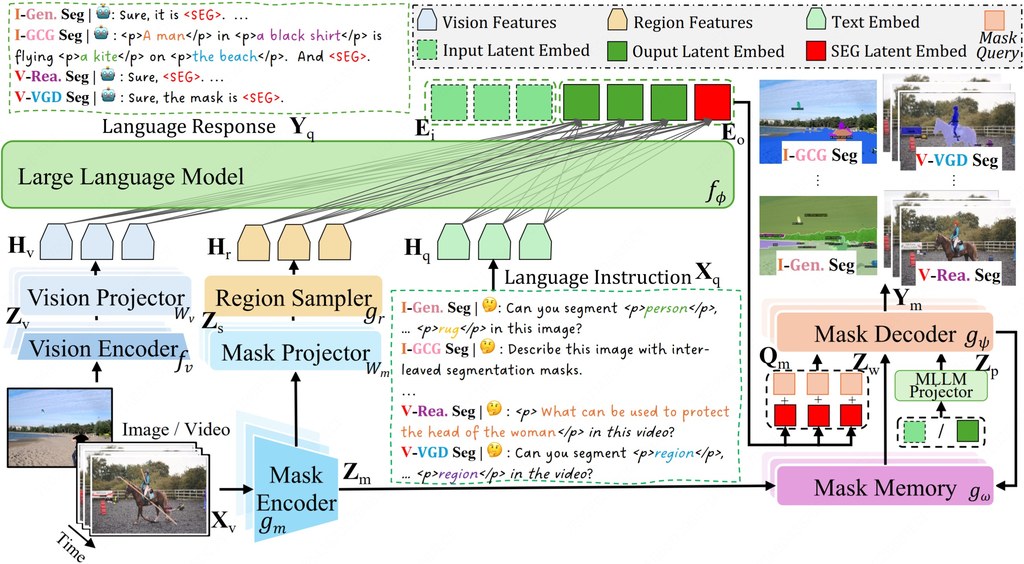
X2SAM 是一個統一式分割多模態大型語言模型,目標是把影像中的「任意分割」能力延伸到影片。它結合 LLM、Vision Encoder、Mask Encoder、Mask Decoder 與 Mask Memory,讓模型不只理解畫面內容,還能依照對話指令或視覺提示產生像素級遮罩。

實際使用上,X2SAM 可同時接受對話式文字指令視覺提示,適合需要指定目標、追蹤物件或互動修正結果的情境。官方描述指出,它支援 generic、open-vocabulary、referring、reasoning、grounded conversation generation、interactive 與 visual grounded segmentation,代表使用者可用較自然的方式提出分割需求,而不必侷限於單一輸入形式。

這個專案的主要創新,在於用單一介面整合影像與影片分割,並以 Mask Memory 儲存受引導的視覺特徵,改善影片中跨時間的遮罩一致性。此外,作者也提出 V-VGD(Video Visual Grounded) 分割基準,用來評估模型是否能根據互動式視覺提示,在影片中分割並追蹤物件。

  • 統一支援影像與影片分割,而非只專注單一媒體
  • 同時支援文字指令與視覺提示輸入
  • 透過 Mask Memory 強化影片遮罩的時序一致性
  • 提出 V-VGD 基準補足影片視覺定位分割評估
  • 採用異質影像與影片資料的聯合訓練策略

從工作應用來看,這類系統可望受惠於影片內容理解、互動式標註、智慧剪輯、視覺助理與多模態人機互動等任務。性能方面,原文表示 X2SAM 在影片分割上達到強勁表現,對影像分割基準仍具競爭力,並保留一般影像與影片聊天能力;不過此頁面未完整列出具體數值,因此解讀上仍應以論文與實驗表格為準。

模型列表:LLM、SAM 系列

Categories: 開源, 影像模型, 影像處理

SplAttN:用可微分投影補強點雲補全的關鍵一環

SplAttN嘗試把2D影像線索真正帶進3D點雲補全,而不是流於形式的多模態輸入。

SplAttN logo

SplAttN 是一個面向影像引導點雲補全(Point Cloud Completion)的 PyTorch 研究專案,核心目標是讓稀疏的 3D 幾何與 2D 視覺先驗之間,維持可學習且可微分的連結。它對準的問題很明確:傳統把點雲硬式投影到影像平面後,往往只留下過度稀疏的對應訊號,導致影像資訊難以有效影響補全結果。

這個方法的亮點,在於以 Differentiable Gaussian Splatting 取代硬投影,將稀疏投影點轉成較連續、較稠密的影像平面表示,再透過注意力機制融合幾何特徵與視覺特徵。從論文描述來看,這不只是提升表現的工程技巧,更是在處理多模態學習中「影像到底有沒有真的被用上」的核心問題。

值得注意的是,SplAttN 還加入了反事實評估觀點,檢查模型是否真的依賴視覺線索,而不是把影像當成可有可無的附加輸入。README 提到它在 PCN、ShapeNet-55/34 與 KITTI 上做了驗證,並宣稱在部分基準上達到先進水準;其中 KITTI 被當作壓力測試,這點對評估真實場景泛化特別有參考價值。

重點摘要:
– 以可微分 Gaussian splatting 改善 2D 與 3D 的訊號連接
– 用注意力融合影像與幾何特徵,強化跨模態依賴學習
– 強調反事實評估,而非只看最終分數高低
– 提供官方 PyTorch 實作,適合研究重現與延伸

實際使用上,這個專案最適合拿來做多模態點雲補全研究、模型重現、方法比較,尤其適合想分析影像訊號在 3D 任務中是否真正發揮作用的研究者。若你的工作聚焦在 3D 視覺、自动駕駛感知或學術實驗設計,SplAttN 的價值不只在結果,還在它對跨模態連結機制提出了更可檢驗的做法。

Source: https://github.com/zay002/SplAttN

Categories: 開源, 模型, 3D

ComboStoc 擴散模型訓練更快的關鍵

用非同步時間步,補足擴散模型盲點。

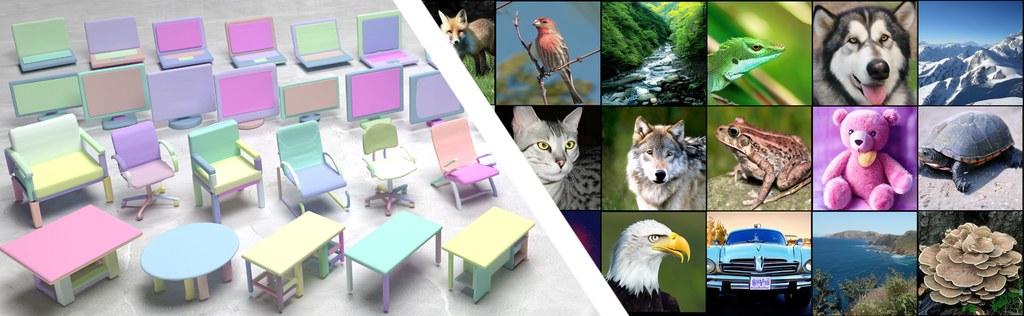
ComboStoc samples

ComboStoc 是一個針對擴散生成模型訓練流程的研究型實作,核心目標不是換掉整個模型架構,而是修正既有訓練對「組合式結構」取樣不足的問題。這個版本以 PyTorch 為主,提供影像擴散模型、訓練腳本,以及預訓練權重,定位相當明確:拿來驗證論文方法,也適合已有 SiT 或相近擴散管線的人直接比較。

這個專案真正有辨識度的地方,在於它不再把整筆資料視為同步走在同一個 diffusion timestep。相反地,它讓不同維度、patch,甚至可能的屬性使用非同步時間步,藉此更完整覆蓋高維資料中的組合空間;這也是它和一般只調 loss、scheduler 或採樣器的做法最不一樣之處。

實務上,它延續 SiT 風格的實作思路,並提供基於 PyTorch DDP 的訓練流程,代表它不是紙上談兵,而是可在分散式訓練中直接測試。推論端也不只是在既有 checkpoint 上出圖,還能利用非同步時間步做更細緻的控制;若參考論文描述,這種機制對局部條件控制或結構化生成尤其有意義。

最能受益的族群,會是正在研究影像生成、擴散模型訓練效率,或需要面對高度結構化資料的人。若你關心的是更快收斂、較低 FID,或想把相同模型延伸到更有屬性組合複雜度的任務,這個專案值得細看;至於 3D structured shape 的完整程式,儲存庫目前看來仍是後續補上。

  • 特色在於非同步 diffusion timestep,不是單純更換 backbone
  • PyTorch 實作,並提供 DDP 訓練腳本
  • 已附預訓練的 ComboStoc-XL-2 權重,可直接做採樣比較
  • 適合拿來研究高維資料中組合複雜度對生成品質的影響

Source: https://github.com/Xrvitd/ComboStoc

Categories: 開源, 香港大學, 模型, 影像模型

AcademiClaw 包含80個大學生的學術任務雙語基準測試

OpenClaw在真實學生任務上測試AI。

OpenClaw學術評估流程
GAIR-NLP/AcademiClaw

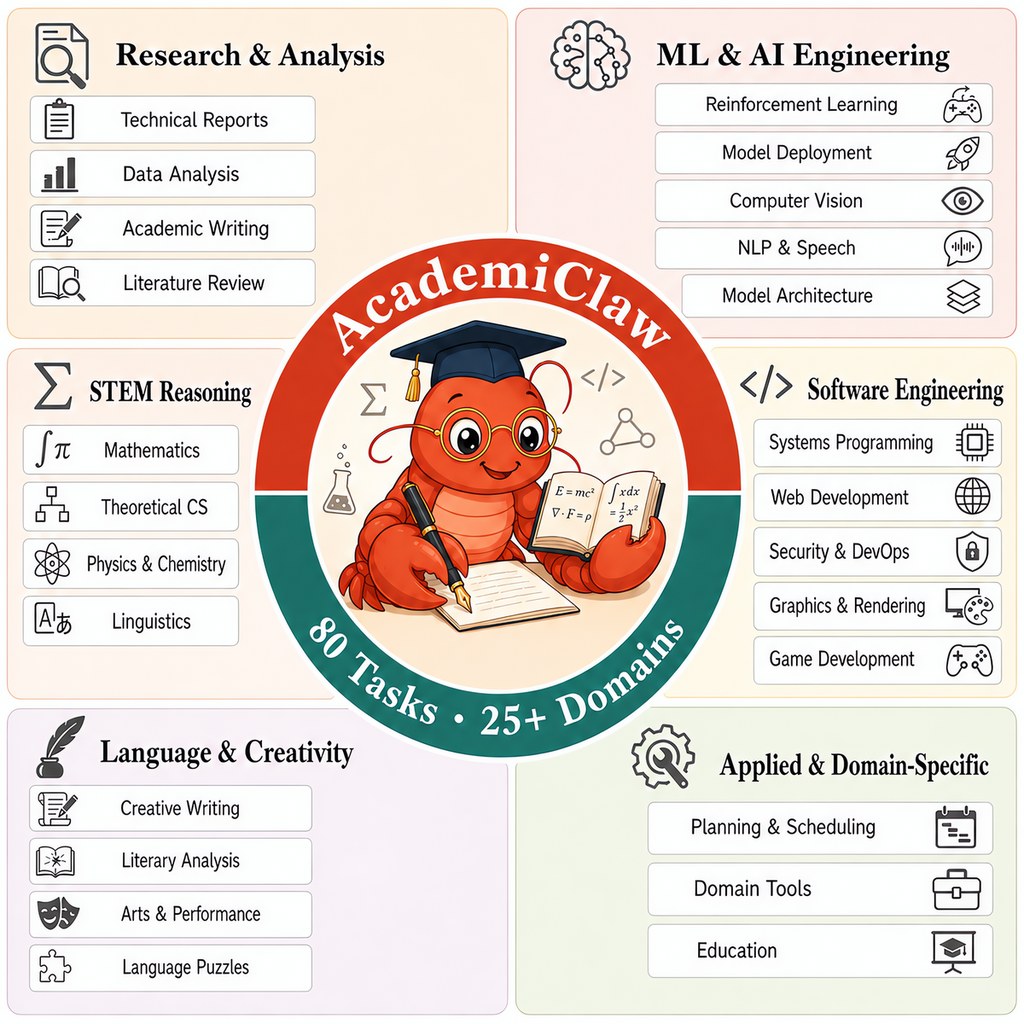
AcademiClaw 包含80個大學生的學術任務雙語基準測試 為AI代理呈現了一項獨特的學術 挑戰,透過使用真實世界的學術任務。這80個任務直接來自學生,突顯了當前AI不足之處。

該基準測試涵蓋了各種類別,如研究、軟體工程和語言創意,確保了全面的測試。研究人員和開發者可以專注於這些類別,以識別AI的優勢和弱點。每個任務都經過精心設計,並進行多維度評估,增強其可靠性。

在實際應用中,AcademiClaw 使用CPU和GPU任務的混合,根據需求自動路由。這種設置確保了在測試不同AI模型時的可重現性和公平性。用戶從詳細的評分維度和安全審核中受益,提供了對模型性能的洞察。

教育工作者和AI研究人員將發現 AcademiClaw 對於提升AI能力極具價值。它需要能夠處理複雜、長時間範圍任務的強大LLMs。

主要收穫:
–  AcademiClaw 使用真實的學生挑戰來測試AI。
– 它涵蓋了多樣化的學術領域,並進行詳細評估。
– 需要堅固的LLMs才能有效完成任務。
– 為AI開發和教育提供寶貴的見解。
– 支援CPU和GPU任務,以實現靈活的測試。

Source: https://github.com/GAIR-NLP/AcademiClaw

Categories: 開源, Agentic, OpenClaw

SenseNova-U系列:一種突破性的多模態AI

SenseNova U1重新定義了多模態AI。深入探索吧!

SenseNova-U1
OpenSenseNova/SenseNova-U1 on GitHub

[2026-08-21] SenseNova-U1.5 更新版模型下載

SenseNova U1引入了一種突破性的多模態AI方法,通過單一架構統一語言和視覺。這種創新允許文本和圖像之間無縫互動,而不需要單獨的適配器,增強了效率和一致性。

在探索SenseNova U1時,最初應關注其核心架構NEO-Unify,這使得模型能夠將視覺和文本數據作為統一的複合體進行處理。實際上,這意味著模型可以更有效地跨不同類型的輸入進行推理,保留語義豐富性和視覺忠實度。

研究人員和開發者最能受益於SenseNova U1的能力,特別是那些從事需要高密度資訊渲染或交錯圖文生成應用的人。該模型處理複雜任務(如創建知識插圖或旅行日誌)的能力使其成為一個寶貴的工具。

為了充分利用SenseNova U1,用戶應擁有能夠支援多模態任務的強大大型語言模型(LLM)。該模型的開源性質也鼓勵社區貢獻和進一步發展。

• SenseNova U1原生統一多模態處理。
• 它擅長交錯圖文生成。
• 用戶需要一個穩健的LLM以實現最佳性能。
• 適合研究人員和開發者。
• 在開源多模態AI中設定了新的標準。

Source: https://github.com/OpenSenseNova/SenseNova-U1

Categories: 開源, 模型, 影像模型, 影像處理

ClawMetry:看見您的代理思考

ClawMetry 可視化 AI 代理流程。零配置設置。

流程可視化

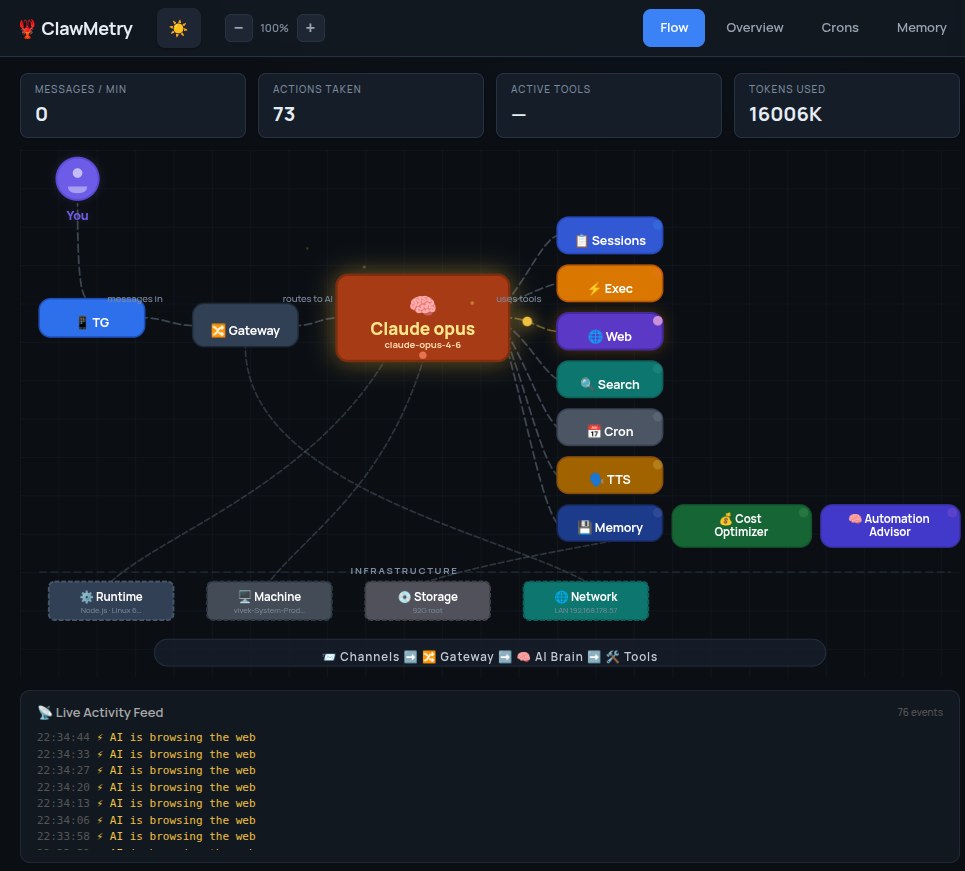
實時動畫流程儀表板是一個突出的功能,展示了通道、大腦、工具等之間的消息交換。這種可視化幫助開發者一目瞭然地理解複雜的交互。

Clawmetry 是一個專為 OpenClaw 設計的開源即時監控儀表板,它會自動讀取 OpenClaw 的現有 openclaw.json 配置文件和 Session 日誌,顯示 Agent 活動、工具呼叫、Token 消耗等資訊 。
它是獨立運行的 Python 服務,使用 pip install clawmetry 安裝後啟動,就能透過 Web 介面(預設 http://localhost:8900)查看資料,無需任何額外配置 。
Clawmetry 只讀取資料,不會寫入或改變 OpenClaw 的任何設定檔案,對 OpenClaw 性能影響極小(獨立進程,額外記憶體約 30MB)。

安裝與使用

安裝後,它會掃描你已配置的 OpenClaw 頻道,只顯示實際在 openclaw.json 中設定的項目 。
若要自訂,可用 clawmetry --port 9000 --workspace /path/to/openclaw/workspace 指定路徑,但仍僅讀取不修改 。
適合你作為 AI/ML 工程師,用來監控 RAG 系統或 Cantonese NLP Agent 的運行狀態 。

主要功能:
* 自動偵測 AI 代理配置
* 提供實時流程圖以提高清晰度
* 高效追蹤令牌使用和成本
* 支援多種大型語言模型

Source: https://github.com/vivekchand/clawmetry

Categories: 開源, OpenClaw

AnyRecon:使用視頻擴散模型進行任意視角3D重建

AnyRecon將視頻轉換為3D視圖。適合創作者使用。

logo
OpenImagingLab/AnyRecon 在 GitHub 上

AnyRecon利用視頻擴散模型從輸入視頻中重建任意的3D視圖。這個創新的工具對於希望探索視覺敘事新維度的內容創作者和研究人員特別有用。

在開始使用AnyRecon時,最初應專注於理解其核心功能——將連續幀轉換為空間上一致的3D重建。該過程涉及將視頻數據通過預訓練模型,該模型輸出詳細的3D模型。此工作流程需要仔細準備輸入視頻並精確配置模型參數。

研究人員和藝術家最能受益於AnyRecon的功能。它使他們能夠從現有的視頻內容生成沉浸式的3D環境,為虛擬現實應用和互動媒體打開了可能性。然而,用戶應該意識到該工具需要強大的大型語言模型(LLM)才能達到最佳性能。

主要收穫包括:
* AnyRecon使用視頻擴散模型進行3D重建。
* 適合內容創作和研究目的。
* 需要堅固的LLM以獲得最佳效果。

了解AnyRecon的底層機制有助於用戶有效地量身定製他們的項目。通過嘗試不同的視頻輸入和調整設置,創作者可以解鎖獨特的視覺體驗。

Source: https://github.com/OpenImagingLab/AnyRecon

Categories: 開源, 香港中文大學, 香港大學, 模型, 影像處理

Vista4D 使用 4D 點雲進行視頻重拍

Vista4D 動態地重新拍攝視頻。對於創作者來說非常理想。

Vista4D 預告圖
Eyeline-Labs/Vista4D 在 GitHub 上

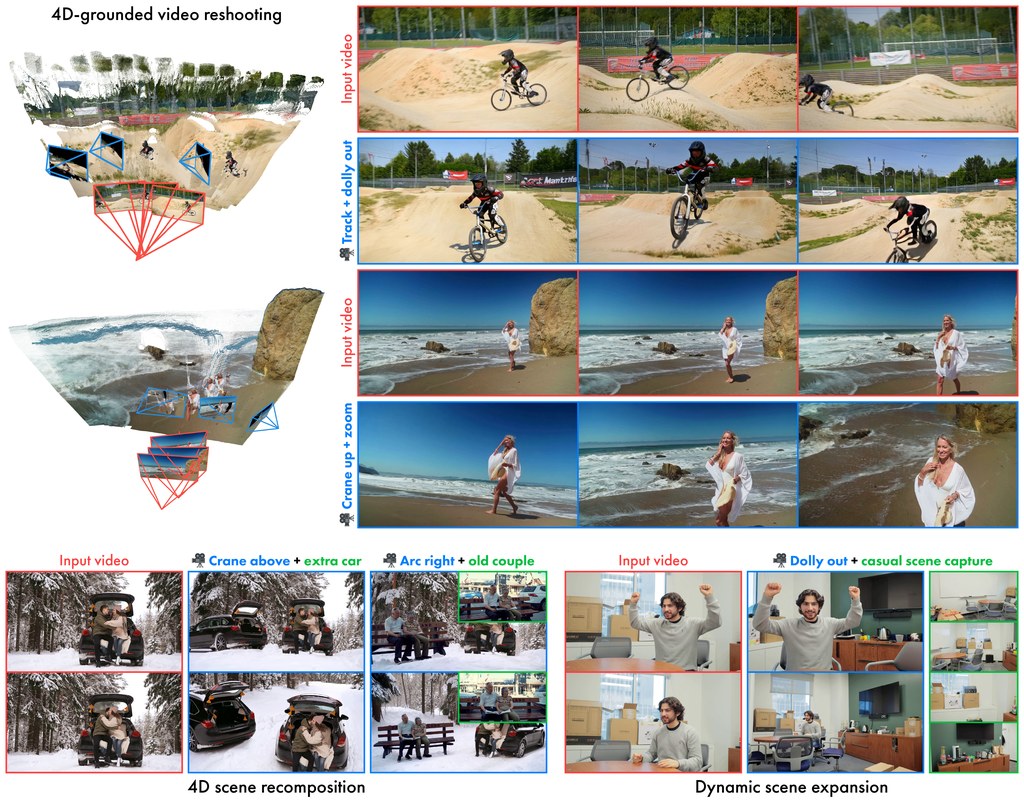
Vista4D 提供了一種獨特的視頻重拍方法,通過從新的角度合成場景。它利用 4D 點雲有效地處理現實世界中的視頻缺陷。這使得它特別適合希望擴展其視覺敘事能力的創作者。

在開始使用 Vista4D 時,重點是理解其核心功能——從新穎的角度重拍視頻。該框架對點雲工件的強健性確保了即使在不完美的重建下也能可靠運行。此特性對於維護場景完整性至關重要。

在實際應用中,Vista4D 受益於動態場景擴展和 4D 場景重組的專業人士。它在保留場景內容的同時允許精確的相機控制,為創意編輯打開了大門。用戶可以預期在視頻製作流程中獲得增強的靈活性。

該框架需要一個強大的大型語言模型(LLM)以獲得最佳結果。創作者和編輯人員將發現 Vista4D 因其創新性的視頻操作方法而極具價值。

• 使用新穎視角增強視頻重拍
• 對點雲工件具有強健性
• 適合動態場景擴展和重組

Source: https://github.com/Eyeline-Labs/Vista4D

Categories: 開源, 模型, 視頻模型, 影像模型, 影像處理

MocapAnything 創新的動作捕捉方法

MoCapAnything V2 提供了一種創新的動作捕捉方法。對於尋求高效、多功能解決方案的動畫師和研究人員來說,這是理想的選擇。

MoCapAnything V2 預告片 — 點擊以在項目頁面觀看視頻
animotionlab26/MocapAnything 在 GitHub 上

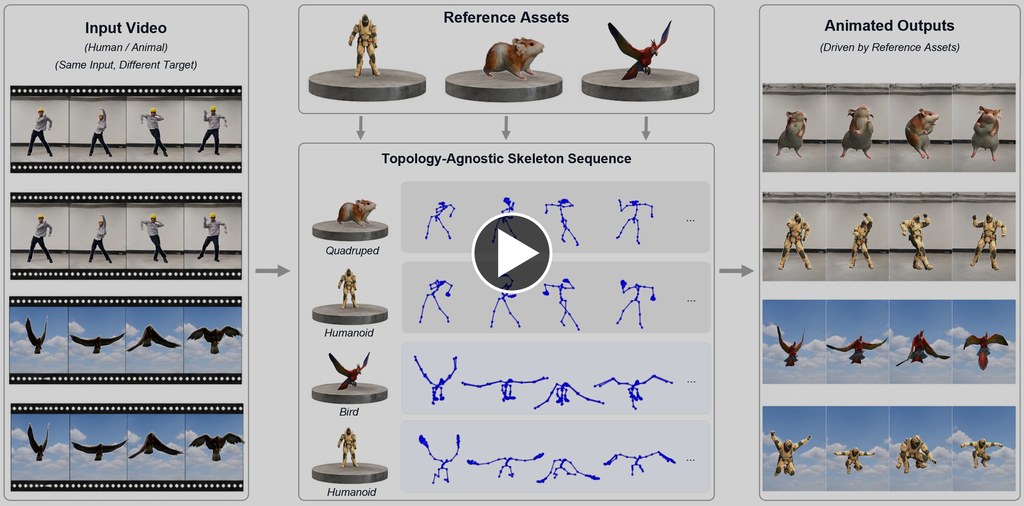
MoCapAnything V2 為那些從事動畫、遊戲開發和需要動作捕捉能力的研究人員提供了一個令人信服的解決方案。該工具通過將單目視頻轉換為詳細的骨骼動畫而脫穎而出,而不依賴於中間網格模型。對於希望在保持高精度的同時簡化工作流程的專業人士來說,MoCapAnything V2 值得探索。最初,用戶應專注於理解參考錨定旋轉的核心概念,這簡化了使用單一參考姿勢-旋轉對將姿勢轉換為旋轉的過程。這種方法確保生成的動畫既精確又在不同資產之間保持一致。

在實踐中,MoCapAnything V2 通過其主要模型 video2pose2rot 運行,該模型整合了兩個子任務:從視頻幀預測關節位置(video2pose)和將這些位置轉換為關節旋轉(pose2rot)。這些任務共同優化,消除了對分析逆運動學的需求。結果是一個無縫的管道,可以直接從輸入視頻提供 BVH 準備好的關節旋轉。這種方法不僅提高了效率,還為速度至關重要的實時應用打開了可能性。處理多樣角色模型的動畫師和開發人員將發現這特別有益,因為該系統可以使用匹配物種的參考框架來適應各種骨骼結構。

在其項目中處理複雜、任意骨骼的人。無論是動畫人類角色還是奇特生物,該工具的靈活性都允許在沒有傳統方法約束的情況下進行準確的動作捕捉。計算機視覺和機器學習領域的研究人員也會欣賞這一端到端優化的創新,為動作捕捉技術的進一步發展提供了堅固的框架。

然而,也有一些權衡需要考慮。雖然無網格的方法顯著提升了處理速度,但它可能無法捕捉到基於網格系統所能處理的細節。用戶應評估 MoCapAnything V2 提供的細節水平是否符合他們項目的要求。此外,對參考姿勢的依賴意味著為了獲得最佳結果,需要仔細選擇和校準。儘管有這些考慮,MoCapAnything V2 所提供的優勢使其成為任何從事動作捕捉的人的工具箱中有價值的添加。

MoCapAnything V2 在動作捕捉技術方面代表了一個重要的進步。其端到端設計,加上參考錨定旋轉和無網格處理,使其成為動畫師、遊戲開發者和研究人員的強大工具。通過專注於關鍵特徵並理解實際影響,用戶可以有效地利用此工具。雖然有一些限制需要注意,但對於許多應用而言,提高效率和靈活性的好處遠遠超過缺點。

Source: https://github.com/animotionlab26/MocapAnything

Categories: 開源, 影像處理

Page 67 of 90
1 65 66 67 68 69 90