TeleAntiFraud 開放反詐數據與模型,建立可重現研究基礎

TeleAntiFraud 將數據集、模型、評測和程式碼集中開放,讓電信反詐研究更容易驗證與延伸。

Hero image preview

面對電信詐騙檢測需要數據、模型和一致評測標準的問題,TeleAntiFraud 以開源研究社區形式,集中提供相關資源,涵蓋數據集、模型、論文及可重現的研究基礎設施。項目由中國人民公安大學聯合發起,適合研究人員、反詐技術團隊及需要測試檢測方法的開發者使用。

社區目前公開 TeleAntiFraud 數據集、AntiFraud-SFT 模型,以及論文與程式碼倉庫,並提供 Hugging Face 模型與數據入口。相比只發布單一模型或個別研究結果,這種整合方式讓使用者可以由數據、訓練資源一路追到論文和程式碼,較方便重現實驗及比較不同方法。

可直接關注的資源包括:
– TeleAntiFraud 數據集及相關論文入口
– AntiFraud-SFT 模型發布與研究資料
– 已錄用論文及對應的公開程式碼、模型和數據
– 面向音頻文本反詐檢測的 SAFE-QAQ 研究

社區列出的最新進展包括 TeleAntiFraud-28k 獲 ACM MM 2025 接收,以及 SAFE-QAQ 獲 ACL 2026 主會接收;後者聚焦慢思考強化學習框架。網站目前未提供統一的性能數字或詳細測試結果,讀者仍需按各論文及資源頁面的評測設定理解模型能力和限制。

項目主頁

Categories: 開源, 模型, 模型訓練, 框架, 庫, 中國, Dataset 數據集

RecreationWorld:從操作到重建軟件介面

代理不只觀察介面,還要自行寫程式、啟動成品及核對結果,測試由操作走向完整交付。

RecreationWorld logo

給代理一個正在運行的參考程式,它要邊操作、邊寫程式,再自行啟動及檢查成品。RecreationWorld 是研究混合式電腦操作代理(hybrid computer-use agents)的五平台框架,處理代理能否按可見行為重建軟件的問題。

它把參考程式當作可執行判準,讓代理反覆進行探索、實作與驗證,而非依固定階段完成任務。最終評分看功能與畫面是否吻合,不要求源碼、語言或架構相同,保留了實作自由。

  • 涵蓋 Ubuntu、macOS、Windows、Android 與 Web
  • RecreationBench 提供 250 個未公開於訓練流程的應用任務
  • 同時採用程式化檢查與視覺模型(Vision-Language Model,VLM)評分
  • 可比較完成度、接近滿分的應用比例及每項任務成本

已列出的結果中,GPT-6 Astra 平均 58.06%,領先 Claude Opus 5 的 44.16%,但估算成本達每項任務 115.80 美元;較便宜的模型則要接受明顯分數差距。這反映長時間探索、編碼與視覺核對仍然昂貴,而且只有少量應用能達到完整功能分數。

開發代理、GUI 自動化或程式生成系統的團隊,可下載 RecreationBench 資料集並依儲存庫的 Quickstart 配置環境;自行託管模型的正式評估需要聯絡團隊。它較適合作研究與模型比較,未見足夠資料證明可直接充當一般軟件重建服務。

項目主頁 · GitHub · 數據集

Categories: 開源, 阿里巴巴, Agentic, 視覺模型, 多模態模型, 模型訓練, Qwen, 框架, Mac, Linux, 庫, Dataset 數據集

小米公開 CodeMidas 強化學習訓練進度

小米以即時指標公開 mimo-v2.6-pro 與 mimo-v2.6-flash 的強化學習訓練狀態,並連結至程式編碼代理研究。

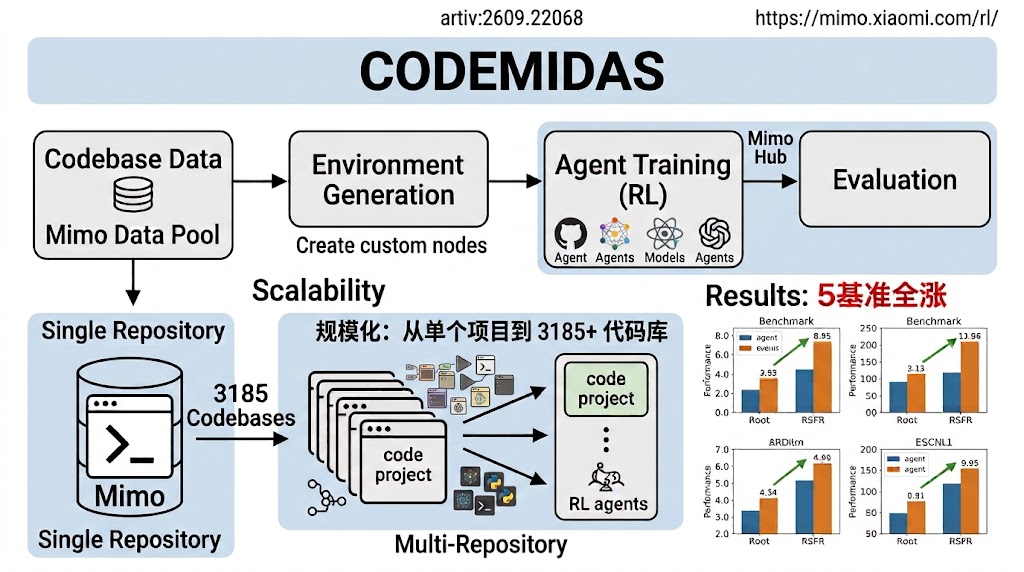
CodeMidas 把模型訓練過程帶到公開視野,展示 mimo-v2.6-pro 與 mimo-v2.6-flash 兩組 reinforcement-learning runs 的即時指標。對需要追蹤模型能力如何形成的研究者和開發者而言,這類介面可用來觀察訓練是否持續、何時中斷,以及不同模型版本的進度差異。

小米以 trainer 直接提供的 metrics 為主,未有完整列出指標定義、數值解讀或最終評測結果。因此,讀者可以把它視為訓練監察入口,而不是已完成模型的性能報告;畫面亦提示可能出現重新連線狀態,資料連續性仍需留意。

根據 CodeMidas 研究,mimo 從程式碼本身擴展 agentic coding reinforcement learning environments。這個方向處理的問題,是如何建立足夠多、又能反映真實編程任務的訓練環境,讓 coding agents 在程式修改、執行與驗證等流程中學習,而不只依賴靜態範例。

資訊:
– 同時追蹤 mimo-v2.6-pro 與 mimo-v2.6-flash 的強化學習訓練
– 指標由 trainer 即時更新,適合觀察訓練進程
– CodeMidas 聚焦由程式碼擴展 agentic coding RL environments

對模型研究、AI agent 和編程工具開發者來說,頁面提供了一個觀察訓練公開化的窗口;一般使用者則應等待正式模型說明和獨立評測,才適合判斷其編碼能力及穩定性。

項目主頁 · 模型

Categories: 開源, 香港大學, 北京大學, Agentic, 模型訓練, 工具, Discord, 編程, 小米-Xiaomi

ComfyUI-DeGrid:Qwen VAE 解碼網格修正

Qwen Image 解碼後的 2px 網格容易被放大流程強化,ComfyUI-DeGrid 讓修正可以在放大前自動完成。

Repository image for lunaaispace-eng/ComfyUI-DeGrid

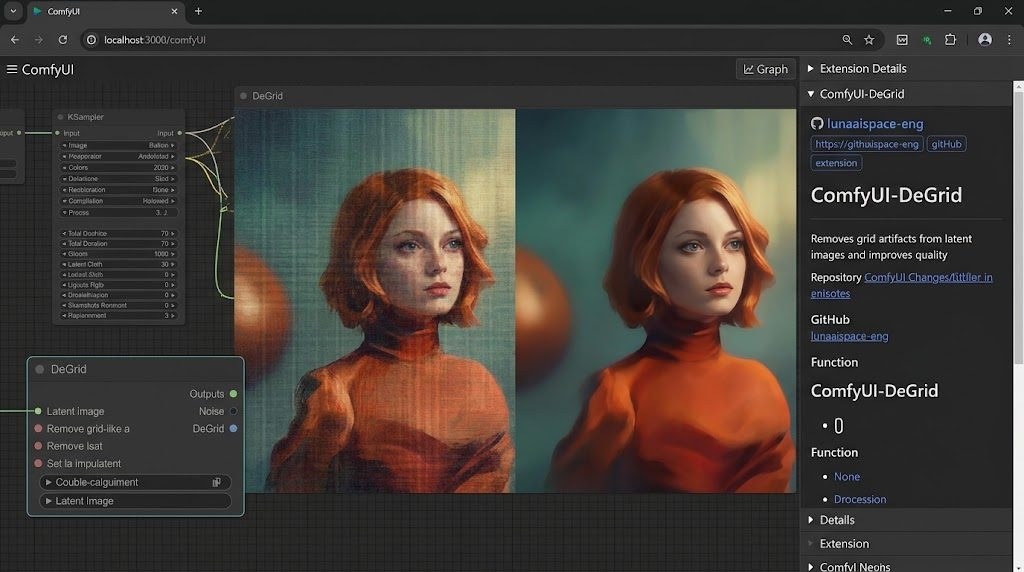
Qwen Image、Qwen Image 2.1 及部分 Wan 2.1 VAE 生成的平坦暗位,可能帶有不易察覺的 2px 像素網格;經過銳化或放大後,瑕疵會變成明顯紋理。ComfyUI-DeGrid 是一個 ComfyUI 影像修正節點,專門在 VAE Decode 後移除這種規律格線。

它採用 VAE DeGrid(Nyquist Notch)處理方式,auto 模式會逐張影像量度網格強度並自動設定修正上限,無需自行調參;未偵測到網格時則原樣傳遞。節點亦會顯示 grid 強度、修正上限及受保護邊緣比例,方便確認是否有執行過度。

安裝只需放入 ComfyUI/custom_nodes,依賴 torch,亦不需要 OpenGL 或 GLFW,因此可在 headless 環境運行。工作流應接成 VAE Decode → VAE DeGrid → 銳化、放大或 SeedVR2 等後續處理,因為縮放後才修正,可能已經太遲。

  • 支援以 Qwen Image、Qwen Image 2.1、Wan 2.1 VAE 為基礎的相關工作流
  • auto 模式按影像校準,manual 模式則可自行設定 limit
  • 可用 enabled 開關快速作 A/B 比較,關閉時完全不修改影像
  • 沒有提供速度或畫質基準測試,效益主要取決於輸入是否含有網格
  • 不應與 ComfyUI-SaveSimple 同時安裝,兩者包含相同的 VAEDeGrid 節點 ID

需要處理 Qwen Image 或 Anima 解碼瑕疵的創作者,會較容易感受到它對後續放大流程的幫助;但若工作流沒有相關 VAE,或影像本身沒有網格,節點只會增加一個檢查步驟,未必帶來可見差異。

GitHub

Categories: 開源, ComfyUI, AI productions, Qwen, Image, Content Creator

ComfyUI-NodeSnapshots:複雜流程卡頓救星:把節點變成圖片緩存

當 ComfyUI 工作流動輒幾百個節點,拖拉節點時幀率掉到個位數是常態。NodeSnapshots 把閒置的節點先渲染成透明畫布,移動時直接重用圖片,把一張圖的幀率從 20 拉回 60。

Repository image for SparknightLLC/ComfyUI-NodeSnapshots

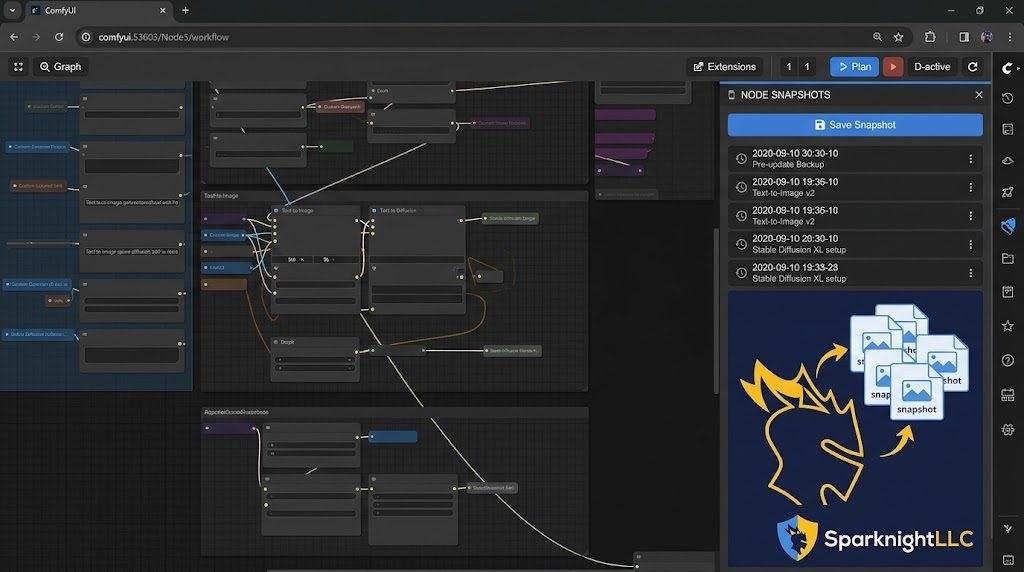
當 ComfyUI 的工作流膨脹到幾百個節點,畫面停頓幾乎是必然。Sparknight 開源的 NodeSnapshots 是一個純前端擴充套件,目標就是把這種拖拉時的卡頓感處理掉。它不動推論邏輯、不改工作流格式、不裝額外模型,把閒置節點預先渲染成一張張透明畫布,平移、縮放、拖動節點時直接重用圖片,跳過昂貴的重繪。

在約 350 節點的實測流程裡,繁忙區塊的平均幀率從 20 FPS 拉到接近 60,改善幅度並非「感覺順」而是的明顯跳升。早期版本其實試過一次截整張圖的做法,速度更快,但截全圖那一刻會卡住;NodeSnapshots 改用逐個節點、分批閒置排程來拍快照,避開那個停頓,同時保留重用帶來的流暢感。

它處理了幾個關鍵取捨:

  • 滑鼠停留、被選取、正在編輯、媒體預覽以及執行中的節點一律維持即時渲染,避免圖片覆蓋掉需要即時更新的狀態。
  • 只有真正改到內容(值、大小、連線、繪製設定)才會把該節點的圖片標記失效;單純移動位置或縮放視窗不會清掉緩存。
  • 視窗移動中會以 100 毫秒為週期檢查緩存是否可用,停下來才回到逐幀檢查,避免邊拖邊做完整校驗。

需要注意的限制:

  • 快照以圖形座標的全細節拍攝再縮放顯示,畫面大幅放大時文字會變糊,可以透過 capture pixel ratio 取捨清晰度與記憶體。
  • 切換調色盤、換字型、整個工作流被替換時緩存會清空,第一次進入子圖也可能觸發字型刷新造成短暫等待。
  • 如果你同時裝了其他會覆蓋同樣繪製方法的擴充,可能互相影響。

對需要反覆在大型 Stable Diffusion、影像生成流程裡微調節點位置的使用者來說,這類擴充幾乎是工作流跑得起來的必要條件。安裝方式只需把資料夾放到 ComfyUI/custom_nodes/ComfyUI-NodeSnapshots,重啟後到 Settings > NodeSnapshots 開關即可。

GitHub

Categories: 開源, ComfyUI, Image, 庫

Compositor : 免費開源 Photoshop 替代品

不想再付 Photoshop 月費、又想保留熟悉快捷鍵的 macOS 用戶,多了一個叫 Compositor 的開源選擇。它由獨立開發者 Robbie Tilton 以 Xcode 項目形式發佈,主打完整圖層、調整層與非破壞性變形。

Repository image for robbietilton/Compositor

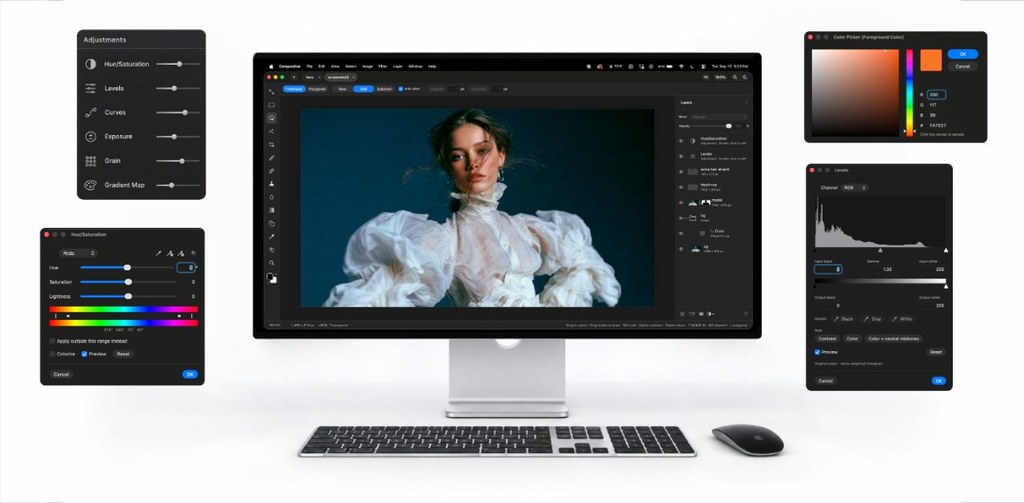
對長期依賴 Photoshop 做合成、後期與修圖的 macOS 用戶來說,Adobe 月費始終是一道門檻,而 GIMP、Krita 這類免費替代品介面邏輯差異大,轉移成本高。Compositor 正正針對這個尷尬位置,由獨立開發者 Robbie Tilton 以 Swift 撰寫、Xcode 項目形式開源發佈,所有功能都可以自行修改或擴充。

從工作流角度,它繼承了一整套 Photoshop 風格的快捷鍵與面板邏輯:圖層、資料夾、剪裁遮色片、混合模式與不透明度齊備;調整層涵蓋色相/飽和度、Levels、Curves、Exposure、Gradient Map 與 Grain;變形時保持完整解析度,並支援框外延伸的 Content-Aware Fill。Lasso、魔術棒、Spot Healing Brush、Clone Stamp 等選擇與繪圖工具也一應俱全,多項目分頁與 JPEG、PNG、HEIC、TIFF 匯入則貼近日常後期流程。

它與 PicsArt、Pixelmator Pro 等同類差異,在於完全開源、零訂閱,並允許直接下載 Xcode 項目插手改功能;代價是目前僅支援 macOS、依賴 Apple 生態,而且由個人維護,更新節奏未必追得上 Adobe。輸出預覽、批次處理、Camera RAW 等專業模組暫未見於 README,較適合個人創作、學生與中小型設計團隊作為主力或副機。

想試的話,可到 GitHub 取得原始碼,或從官方網站下載 macOS 安裝檔;Xcode 用戶亦可直接打開項目調整工具組合,再自行編譯。

項目主頁 · GitHub

Categories: 開源, Image, Clone, Mac, 蘋果

Qwen-Image-2.1 開源:透明圖層生成與多圖編輯

7B 參數的 Qwen-Image-2.1 把文生圖、圖片編輯、透明背景生成整合在同一個模型,一次可參考 10 張圖片,門檻不高但功能更齊全。

在 AI 繪圖的世界裡,能同時處理文生圖、改圖、還能直接輸出透明背景圖的開源模型並不多。Qwen 團隊這次開源的 Qwen-Image-2.1,把這幾件事整合進同一個 7B 參數的視覺生成模型,使用時不需要切換不同模型或額外加工。對做貼圖、做商品圖、做素材整理的人來說,這種「一個模型走到底」的做法很貼合日常工作流。

模型採用 32 層 Single-Stream DiT 結構,配合混合粒度注意力與 prefix KV cache 復用,把運算成本壓低。即使在顯示卡記憶體有限的環境下,仍能輸出品質不錯的圖片;Apple Silicon 用戶也能用 MPS 加速跑得動。

Qwen-Image-2.1 對透明背景(RGBA)的處理是這次的亮點之一。文字描述可以直接生成帶 Alpha 通道的圖,也能把照片裡的主體分離出來變成透明底,省去摳圖步驟。編輯功能同樣豐富:最多可同時參考 10 張圖片,用圓圈、塗鴉或遮罩標記局部修改位置,並在人物、產品場景保留識別特徵,避免改一處卻跑掉整個主體。

Og image

文字渲染和人像光影也比上一代細緻,招牌、卡片、海報一類需要清晰排字的場景更實用。整體定位偏向「夠用、好用、可商用」的工具型模型,不是衝榜級的影像模型。

重點摘要

  • 統一模型:文生圖、圖片編輯、RGBA 透明圖生成整合在同一個 7B 參數模型
  • 高效率架構:32 層 Single-Strteam DiT,搭配混合粒度注意力與 prefix KV cache 復用
  • 多圖參考編輯:最多支援 10 張參考圖,可用圓圈、塗鴉或遮罩指定修改區域
  • 主體保留:在人物、產品場景保持識別特徵,不會改一處就全跑掉
  • 透明背景原生支援:可文字直出 RGBA,也能從照片分離主體成透明底

模型已在 Hugging Face 開源,並提供 Diffusers 整合程式碼、Google Colab 與 Kaggle Notebook,Apple 用戶亦可透過 Draw Things 或 DiffusionBee 等本地 App 直接試用。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Qwen, Google, Image, 影像模型, 影像處理, txt2img, 蘋果

HyperFlow 自蒸餾影片生成省六成推論成本 – MiniMax-H3 八步出片

Video Rebirth 推出嘅 HyperFlow 係一個針對 MiniMax-H3 嘅 8 步 LoRA 適配器,透過 data-free flow self-distillation 將 50 步推論壓到 8 步,仲行得喺官方 diffusers Modular Pipeline 之上。

Repository image for Video-Rebirth/hyperflow

影片生成模型一直面對一個現實樽頸:想要更高品質,就要更多 sampling steps,亦意味住更長嘅等待同更高嘅運算成本。Video Rebirth 推出嘅 HyperFlow 就直接針對呢個取捨落手,喺 MiniMax-H3 官方權重之上加一個 8 步 LoRA(PEFT,rank/alpha 256,覆蓋 attention、feed-forward 同兩組 time embedder),將官方 50 點 sigma schedule 嘅 49 次前向推論壓到 8 次,而且唔需要額外訓練資料。

你可以把它理解成一個「加速層」:base weights、VAE、conditioner 同 t2va、fl2va、ref2va 三種 workflow(全部對應影片加音訊)都維持官方版本,呢個項目只負責載入 LoRA、兩個 time embedder 同固定嘅 8 步 sigma grid。官方修訂號、權重路徑、適用範圍等資料都收錄喺 hyperflow.json manifest 入面。LoRA 喺 Hugging Face 開源,授權沿用 MiniMax H3 Community License,呢個倉庫就提供 loader 同 example scripts,透過 hyperflow_blocks("fl2va") 等 API 直接接入 diffusers Modular Pipeline。

HyperFlow 嘅特點係 data-free:模型自己產生候選影片、篩走不合格嘅、然後用通過嘅樣本做 self-distillation,屬於佢哋 RSI(Recursive Self-Improvement)訓練範式嘅 self-distillation 部分。對比一般影片生成流程,呢種做法唔需要額外收集標註資料,亦唔需要人手標籤。實際運行時仲可以選擇加裝 NVIDIA Sol-Attn sparse attention(PyTorch ≥ 2.10、CUDA ≥ 12.8、Triton ≥ 3.6,支援 SM80–SM120),官方聲稱喺 H200 上比 dense attention 快約 13%,並可透過 Ulysses context parallel 擴展至最多 4 張 GPU。

對想用 MiniMax-H3 出片、又希望壓低推論時間嘅團隊或獨立開發者嚟講,HyperFlow 提供咗一個直接掛載嘅方案;對研究自蒸餾或自改進路線嘅從業者嚟講,佢亦係一個具體嘅開源參考。需要注意嘅係 num_inference_steps 唔應該手動指定,步數同 sigma grid 都由權重檔案內置決定。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視頻模型, NVIDIA, Video, Audio, Python, 庫, MiniMax

lanshu-create-ai-presenter-video:數字人影片 Skill:一張圖+文案自動生成完整講解影片

一個針對通用數字人影片製作 Skill。你輸入主題或文案,再加一張授權人物圖,它就會按完整配音時間軸組織生成、剪輯同驗收,輸出一條可發佈嘅講解片。

Repository image for cclank/lanshu-create-ai-presenter-video

做數字人講解片最麻煩嘅地方,往往唔係生成人物,而係口型、文字同聲音對唔齊,最後剪埋一齊就甩拍。lanshu-create-ai-presenter-video 嘅切入點正正喺呢度:佢將「完整配音」鎖定為全片時間基準,人物主素材、字幕、關鍵詞動效同鏡頭轉場都跟住呢條音頻排,從而減少口型漂移同片段接駁嘅問題。整個項目屬於 Agent Skill 工具,由 Codex 或其他兼容本地 Skill 嘅 Agent 環境直接調用,源碼本身唔綁定任何特定服務商、模型或私有接口,可以按當前環境可調用嘅能力動態選擇配音、人物生成同口型同步工具。

最低門檻只需要一份主題或文案,再加一張已授權、包含清晰成年人物嘅參考圖。聲音樣本、屏幕錄影、B-roll、品牌素材、目標平台、時長、橫豎屏同風格等都係可選輸入,畀進階用戶調整。Skill 目錄會隨階段讀取對應參考文檔:generation.md 處理文案、聲音、能力選型同人物提示詞;editing.md 負責時間軸、字幕預設、封面同導出;qa-recovery.md 處理技術驗收、人工驗收同常見故障修復,避免一次過佔用過多上下文。

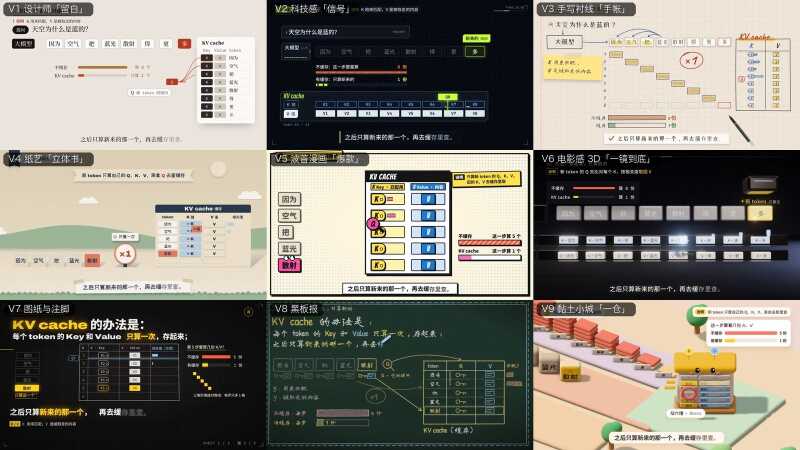
key名称the look · 画面best for · 适合3D
v1-editorialV1 设计师「留白」warm paper, ink, one vermilion accent, data blocks, page turns · 暖白纸、墨色、一抹朱红,大留白serious, premium explainers; business and product topics · 严肃、高级感、商业与产品no
v2-signalV2 科技感「信号」dark HUD, acid-lime accent, labels decode in, packets on wires, glitch cuts · 暗色仪表盘、荧光绿、数据包流动AI / infra / networking, anything “system-like” · AI、基础设施、网络、系统类no
v3-notebookV3 手写衬线「手帐」grid paper, a live pen writes every word, sticky notes, eraser · 方格纸上真笔书写、便利贴、橡皮擦teaching step by step, derivations, study notes · 一步步推导、学习笔记、教学no
v4-paperV4 纸艺「立体书」kraft pop-up book, pieces fold up with soft shadows, parallax · 牛皮纸立体书、折起的纸片、视差warm stories, processes, consumer topics · 有温度的故事、流程、大众话题no
v5-comicV5 波普漫画「爆款」halftone comic page, stickers slam on, bursts and sound words · 半调网点漫画、贴纸拍入、爆炸字punchy short videos, hot takes, myth vs fact · 节奏快的短视频、观点、辟谣no
v6-cinematicV6 电影感 3D「一镜到底」Three.js one-take in a graphite studio, porcelain props, bloom · 一镜到底的 3D 影棚、瓷质道具、辉光flagship pieces, launches, big-picture concepts · 旗舰内容、发布、宏观概念yes
v7-draftingV7 图纸与注脚one black drawing sheet, leader lines, ghost-letter karaoke, true footnotes · 黑色图纸、引线、注脚、卡拉OK式大字technical deep dives for practitioners · 面向从业者的技术深挖no
v8-chalkboardV8 黑板报a wooden blackboard written live in chalk, felt eraser, chalk mind map · 木框黑板、粉笔现写、板擦、粉笔脑图复习classroom feel, beginners, memory-friendly recaps · 课堂感、入门、便于记忆no
v9-clayV9 黏土小城「一仓」an isometric plasticine town, every analogy labelled with its real term · 等距黏土小城,比喻 + 真实术语标签analogies for non-experts, cute and friendly · 用比喻讲给外行、可爱亲和yes

預設輸出係 9:16、1080×1920、30fps 豎屏,時長 45 至 75 秒,發佈響度目標約 -16 LUFS。初始化可透過 init_job.py 自動建立標準任務目錄同 job.json,preflight.py 會做前期檢查,最後由 finalize_delivery.sh 收尾輸出,同時產出 QA 報告。環境要求 Python 3.9+、FFmpeg/ffprobe、Bash、jq、awk、sed,以及至少一種可調用嘅影片生成、語音生成同口型同步能力。

佢唔係一個獨立嘅模型,而係一套組織數字人影片工序嘅 Skill 框架,價值在於把配音、人物、字幕、剪輯、驗收等步驟統一在同一條音頻時間軸上,避免最常見嘅口型錯位同片段斷裂。內容創作者、行銷團隊、課程錄製同需要快速產出講解影片嘅場景會較受惠,特別係想喺不同 AI 服務商之間靈活切換、又唔想被單一平台鎖死嘅人。
  • 以完整配音為全片時間基準,減少口型漂移同片段接駁問題
  • 源碼不綁定服務商或模型,可按環境動態選擇配音、人物、口型工具
  • 三份參考文檔按階段讀取,控制上下文用量
  • 預設 9:16 豎屏、1080×1920、30fps、主題片長 45–75 秒
  • 支援聲音樣本、B-roll、品牌素材、平台、橫豎屏等可選參數

GitHub

Categories: 開源, Agentic, AI productions, 數字人, Video, Audio, 提示詞, 框架, Content Creator, Python, 語音, Skill 技能

XGEN-JING 世界模型開源:邊走邊生成影片與音效

XGEN Labs 把互動式第一人稱世界模型 JING 開源:輸入動作與參考圖,就能邊走邊生成對應影片與環境音效,等於把世界模型變成可即時體驗的 demo。

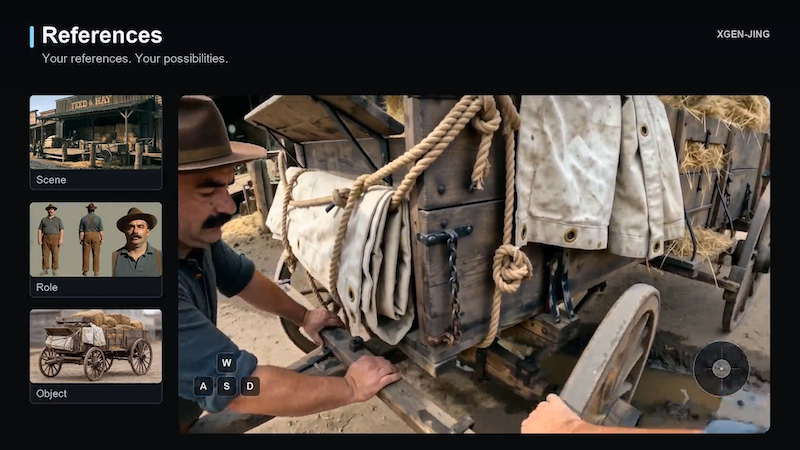
過往的世界模型 demo 多半停留在「按一個鍵播一段片」,XGEN-JING 想把互動感再推一步:鍵盤操作鏡頭、輸入文字引導角色對話,模型即時生成第一人稱影片與配對音訊,並以參考圖約束人物、物件與場景的一致性。這個項目是一個以 MiniMax-H3 為骨幹的 egocentric interactive experience 模型,屬於世界模型 / 互動影片生成一類,目標是讓「在同一個起點做出不同選擇」這件事變得可視聽。

XGEN-JING 的核心差異在「四步雙向推論」與即時性:JING-Flash-v1 用四個步驟完成推論,再把動作、觀察歷史、參考圖同時餵進去生成下一段片段;鏡頭移動、物件互動、人物對話都由文字與按鍵驅動,而畫面與聲音同步輸出,所以更像「邊走邊生成」而不是「先想好再剪片」。

Step Into a World That Responds | XGEN Labs

這版本同時提供 Inference code、examples 與 Prompt skills,後者可以從故事與參考圖自動生成經過驗證的推論案例,降低試錯成本;但因果模型與技術報告尚未釋出,想深入架構細節的人需要再等等。硬件門檻亦偏高:項目方以六張 H100 做驗證,其中一張跑 text encoder、一張跑影音 VAEs、四張跑 DiT 加 sequence parallelism,並指定 FlashAttention-4 為預設後端。

以下幾類人會比較快從中受惠:做世界模型研究、需要互動 demo 的研究者;做遊戲 / VR / 沉浸式敘事、需要快速產出第一人稱體驗的開發者;以及關心 video generation xa in 2026 路徑、想理解「影片 + 音訊 + 動作」三軸如何耦合的團隊。對一般玩家或創作者而言,Hugging Face 上的模型頁與 xgenlabs.ai gallery 已足夠先看 demo,再決定是否投入本地部署。

重點摘要

  • JING 是以 MiniMax-H3 為基礎的第一人稱互動體驗模型,支援鍵盤控鏡、文字對話與參考圖約束。
  • JING-Flash-v1 以四步雙向推論同時生成影片與音效,比單向生成更貼近即時體驗。
  • 官方硬件門檻為六張 H100(1 text encoder + 1 VAEs + 4 DiT),預設 FlashAttention-4,後端依賴 SGLang 特定 commit。
  • Prompt skills 可從故事與參考圖自動產生驗證過的推論案例,方便快速試玩法。

項目主頁 · GitHub · 模型 · 影片集

Categories: 開源, AI productions, 模型, 視頻模型, 世界模型, Google, NVIDIA, Video, Audio, Content Creator, MiniMax, Skill 技能

Page 27 of 118
1 … 25 26 27 28 29 … 118