MAI-UI 是一系列涵蓋各種規模的基礎GUI代理,包括2B、8B、32B和235B-A22B等變體。我們指出了實際部署面臨的四大挑戰:缺乏原生代理-使用者互動、僅依賴UI操作的限制、缺乏實用的部署架構以及在動態環境中的脆弱性。
MAI-UI 採用統一的方法論來解決這些問題:一個自演化的資料管道,用於擴展導航資料以包含使用者互動和 MCP 工具呼叫;一個原生設備-雲端協作系統,用於根據任務狀態路由執行;以及一個具有高級優化的線上強化學習框架,用於擴展平行環境和上下文長度。
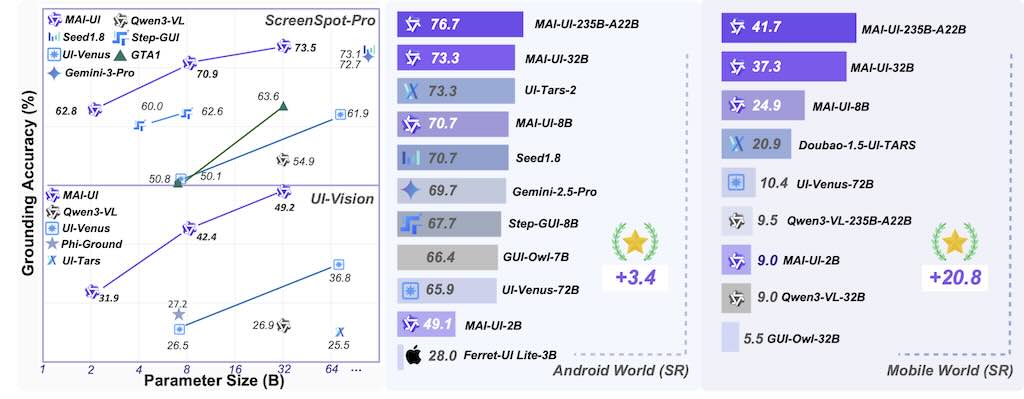
MAI-UI 是一系列涵蓋各種規模的基礎GUI代理,包括2B、8B、32B和235B-A22B等變體。我們指出了實際部署面臨的四大挑戰:缺乏原生代理-使用者互動、僅依賴UI操作的限制、缺乏實用的部署架構以及在動態環境中的脆弱性。 MAI-UI 採用統一的方法論來解決這些問題:一個自演化的資料管道,用於擴展導航資料以包含使用者互動和 MCP 工具呼叫;一個原生設備-雲端協作系統,用於根據任務狀態路由執行;以及一個具有高級優化的線上強化學習框架,用於擴展平行環境和上下文長度。
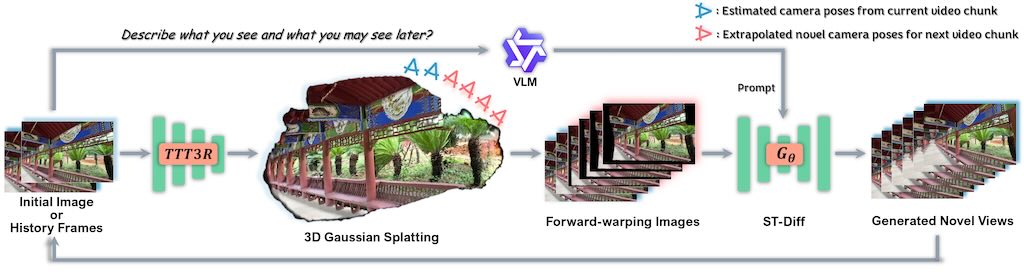
為了建立幾何基礎,WorldWarp 維護了一個透過高斯擴散(3DGS)建構的線上三維幾何緩存。透過將歷史內容明確地扭曲到新的視圖中,該快取充當結構支架,確保每個新幀都遵循先前的幾何形狀。然而,靜態扭曲不可避免地會因遮蔽而留下空洞和偽影。 WorldWarp 使用專為「填充和修正」目標設計的時空擴散(ST-Diff)模型來解決這個問題。 WorldWarp 的核心創新在於空間變化的噪音調度:空白區域接收完整的噪音以觸發生成,而扭曲區域接收部分噪音以實現精細化。透過在每個步驟動態更新 3D 緩存,WorldWarp 能夠保持視訊片段之間的一致性。因此,它透過確保 3D 邏輯引導結構,而擴散邏輯完善紋理,從而實現了最先進的保真度。
為了建立幾何基礎,WorldWarp 維護了一個透過高斯擴散(3DGS)建構的線上三維幾何緩存。透過將歷史內容明確地扭曲到新的視圖中,該快取充當結構支架,確保每個新幀都遵循先前的幾何形狀。然而,靜態扭曲不可避免地會因遮蔽而留下空洞和偽影。
WorldWarp 使用專為「填充和修正」目標設計的時空擴散(ST-Diff)模型來解決這個問題。
WorldWarp 的核心創新在於空間變化的噪音調度:空白區域接收完整的噪音以觸發生成,而扭曲區域接收部分噪音以實現精細化。透過在每個步驟動態更新 3D 緩存,WorldWarp 能夠保持視訊片段之間的一致性。因此,它透過確保 3D 邏輯引導結構,而擴散邏輯完善紋理,從而實現了最先進的保真度。
Meta 的 SAM Audio 是首個統一的多模態模型,能從複雜音頻或視頻中精準分離特定聲音。 SAM Audio 支持文字提示(如「狗叫聲」或「人聲」)、視覺選擇(如點擊視頻中樂手)或時間範圍提示,來隔離目標聲音並生成殘餘音頻。 它適用於音樂、語音和一般環境音,超越傳統單一工具。 模型基於 Flow-Matching Diffusion Transformer,在 DAC-VAE 潛在空間運作,提供小(500M 參數)、基(1B)和大(3B)版本。 它能同時生成目標與殘餘音軌,支援真實世界場景如去除背景噪音。
InfCam,一個無需深度資訊、攝影機控制的視訊生成框架,能夠實現高姿態保真度。該框架整合了兩個關鍵組件: 架構包含同次引導自注意力層(homography-guided self-attention),輸入源視頻、目標及變換潛在表示與相機嵌入,確保時間對齊與旋轉感知推理。 變換模塊處理旋轉後添加平移嵌入,將重投影簡化為相對於無限遠平面的視差估計,提升軌跡忠實度。 透過增強 MultiCamVideo 數據集生成 AugMCV,引入多樣初始姿態與焦距軌跡,解決現有 SynCamVideo 等數據集偏差。 實驗結果表明,在 AugMCV 與 WebVid 數據集上,InfCam 在相同/不同內參情境下,於姿態準確度與視覺保真度皆優於基準,尤其在真實世界數據泛化表現突出。
InfCam,一個無需深度資訊、攝影機控制的視訊生成框架,能夠實現高姿態保真度。該框架整合了兩個關鍵組件:
架構包含同次引導自注意力層(homography-guided self-attention),輸入源視頻、目標及變換潛在表示與相機嵌入,確保時間對齊與旋轉感知推理。 變換模塊處理旋轉後添加平移嵌入,將重投影簡化為相對於無限遠平面的視差估計,提升軌跡忠實度。
透過增強 MultiCamVideo 數據集生成 AugMCV,引入多樣初始姿態與焦距軌跡,解決現有 SynCamVideo 等數據集偏差。
實驗結果表明,在 AugMCV 與 WebVid 數據集上,InfCam 在相同/不同內參情境下,於姿態準確度與視覺保真度皆優於基準,尤其在真實世界數據泛化表現突出。
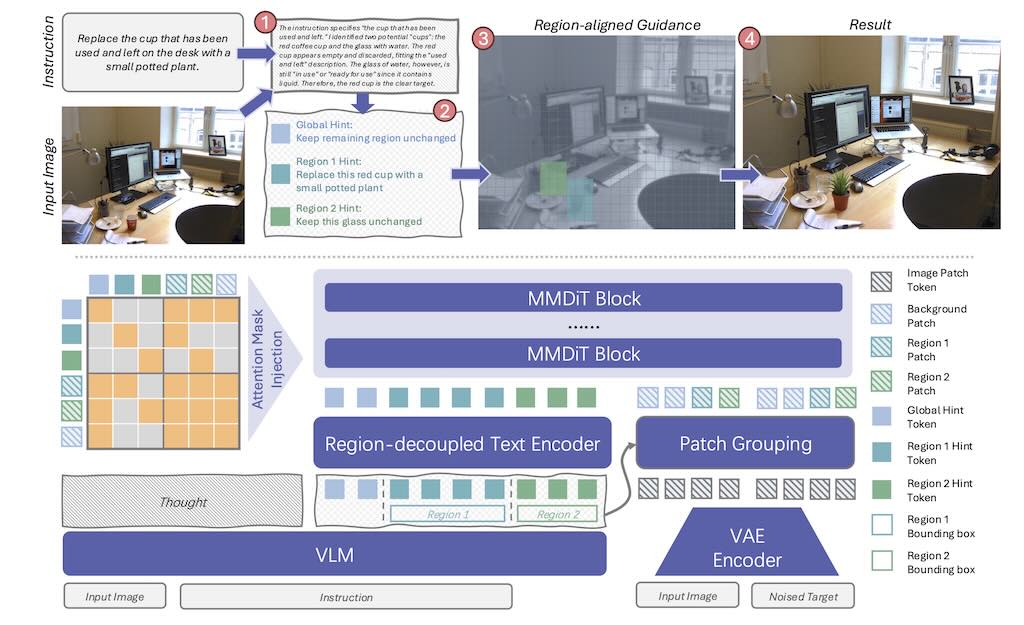
RePlan 是一個基於指令的圖像編輯框架,專門解決指令-視覺複雜度(IV-Complexity)挑戰,透過視覺語言規劃器與擴散編輯器結合實現精準區域編輯。 框架採用「規劃-執行」策略:VLM 規劃器透過逐步推理分解複雜指令,生成邊界框與區域提示;編輯器使用無訓練注意力區域注入機制,支援單次多區域並行編輯,避免迭代 inpainting。
RePlan 是一個基於指令的圖像編輯框架,專門解決指令-視覺複雜度(IV-Complexity)挑戰,透過視覺語言規劃器與擴散編輯器結合實現精準區域編輯。
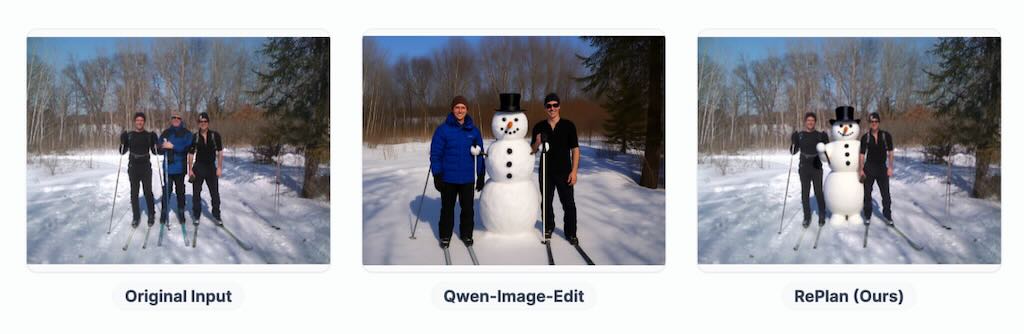
框架採用「規劃-執行」策略:VLM 規劃器透過逐步推理分解複雜指令,生成邊界框與區域提示;編輯器使用無訓練注意力區域注入機制,支援單次多區域並行編輯,避免迭代 inpainting。
影片將一步步帶你上手 PersonaLive,教你如何使用 AI 即時角色變換,在直播或影片中實現即時變身效果,全流程免費。
影片將一步步帶你上手 PersonaLive,教你如何使用 AI 即時角色變換,在直播或影片中實現即時變身效果,全流程免費。

在本機用 ComfyUI 跑 Qwen Image Edit 2511,包含 BF16、FP8 和 GGUF 量化版本,以及 Lightning 4‑step LoRA 的完整實戰示範。
在本機用 ComfyUI 跑 Qwen Image Edit 2511,包含 BF16、FP8 和 GGUF 量化版本,以及 Lightning 4‑step LoRA 的完整實戰示範。

Apple 開源的 SHARP 能讓你輸入單張 2D 圖片,輸出場景的 3D Gaussian 表示(3DGS),可以之後用 3D Gaussian splatting 實時渲染不同視角。這個推論過程在標準 GPU 上小於一秒完成。 SHARP 能產生的 3D 表示是有公尺尺度的 metric representation,所以可以支援具物理意義的相機移動,而不是純視覺特效式的視差
Saber 由 Meta 開發,是一個「只用影片+文字資料就能做參考到影片生成」的零訓練框架,輸入幾張參考圖和一段文字,就能生出既長得像參考主體、又符合文字描述的影片。(訓練和推理程式碼整理完畢後將會發布,敬請期待。) 一般 R2V (Reference to video)要「參考圖+影片+文字」三元組,資料很難蒐集也不易擴充。Saber 完全不收這種三元組,只吃大規模「影片+文字」。 訓練時,它把同一支影片中的某些幀「當成參考圖」,再加上遮罩,讓模型自己學會:怎麼在生成影片時保持主角長相一致、又能跟文字對齊。 技術做法(直覺理解)遮罩訓練:從影片抽幀,套上各種形狀與面積比例的二值遮罩,當作「動態參考圖庫」,讓模型看到超多種類的參考條件。 遮罩增強:對圖和遮罩一起做旋轉、縮放、平移、翻轉等變形,打亂空間對齊,避免模型學到「直接把參考貼上去」的作弊路線。 模型與注意力設計影片與參考圖先丟進 VAE 變成 latent,然後在時間維度把「影片 latent」和「參考 latent」串起來,一起丟進 Transformer 做擴散。參考 latent 不加噪音,保持條件乾淨。 自注意力裡用「注意力遮罩」限制:影片 token 可以互相看、也能看參考,但參考 token 只能看自己有效的前景區域,避免注意到背景干擾。 推論流程與能力推論時,會先用預訓練分割器(例如 BiRefNet)把參考圖的人或物分出來;如果想要用整張背景當條件,就不做分割而用全 1 遮罩。 Saber 可以吃多張參考,支援多視角同一主體,也能多主體;在 OpenS2V-Eval 基準上,主體一致性與整體品質都比 Phantom、VACE、Kling1.6 等專門 R2V 模型更好。 限制與展望當參考圖過多(例如 12 張)時,模型有機會「崩壞」,把不同參考碎片硬湊在同一畫面,語義整合不足。 目前重心在身份保留與視覺自然度,對非常細緻的動作控制或複雜時序一致性仍不完美,未來方向包括更聰明地整合大量參考及更可控的動作與真實感。 官方 GitHub 儲存庫為 https://github.com/franciszzj/Saber,提供模型細節與訓練資訊。 論文《Scaling Zero-Shot Reference-to-Video Generation》發布於 arXiv (2512.06905)。
Saber 由 Meta 開發,是一個「只用影片+文字資料就能做參考到影片生成」的零訓練框架,輸入幾張參考圖和一段文字,就能生出既長得像參考主體、又符合文字描述的影片。(訓練和推理程式碼整理完畢後將會發布,敬請期待。)
一般 R2V (Reference to video)要「參考圖+影片+文字」三元組,資料很難蒐集也不易擴充。Saber 完全不收這種三元組,只吃大規模「影片+文字」。
訓練時,它把同一支影片中的某些幀「當成參考圖」,再加上遮罩,讓模型自己學會:怎麼在生成影片時保持主角長相一致、又能跟文字對齊。
技術做法(直覺理解)
遮罩訓練:從影片抽幀,套上各種形狀與面積比例的二值遮罩,當作「動態參考圖庫」,讓模型看到超多種類的參考條件。
遮罩增強:對圖和遮罩一起做旋轉、縮放、平移、翻轉等變形,打亂空間對齊,避免模型學到「直接把參考貼上去」的作弊路線。
模型與注意力設計
影片與參考圖先丟進 VAE 變成 latent,然後在時間維度把「影片 latent」和「參考 latent」串起來,一起丟進 Transformer 做擴散。參考 latent 不加噪音,保持條件乾淨。
自注意力裡用「注意力遮罩」限制:影片 token 可以互相看、也能看參考,但參考 token 只能看自己有效的前景區域,避免注意到背景干擾。
推論流程與能力
推論時,會先用預訓練分割器(例如 BiRefNet)把參考圖的人或物分出來;如果想要用整張背景當條件,就不做分割而用全 1 遮罩。
Saber 可以吃多張參考,支援多視角同一主體,也能多主體;在 OpenS2V-Eval 基準上,主體一致性與整體品質都比 Phantom、VACE、Kling1.6 等專門 R2V 模型更好。
限制與展望
當參考圖過多(例如 12 張)時,模型有機會「崩壞」,把不同參考碎片硬湊在同一畫面,語義整合不足。
目前重心在身份保留與視覺自然度,對非常細緻的動作控制或複雜時序一致性仍不完美,未來方向包括更聰明地整合大量參考及更可控的動作與真實感。
官方 GitHub 儲存庫為 https://github.com/franciszzj/Saber,提供模型細節與訓練資訊。 論文《Scaling Zero-Shot Reference-to-Video Generation》發布於 arXiv (2512.06905)。
Light-X 是個視訊生成框架,它能夠從視訊中實現可控渲染,並同時控制視角和光照。 Light-X 提出一種解耦設計,將幾何形狀和光照信號解耦:幾何形狀和運動通過沿用戶定義的相機軌跡投影的動態點雲來捕獲,而光照線索則由始終投影到相同幾何形狀的重新光照幀提供。這些明確的、細粒度的線索能夠有效地解耦,並指導高品質的光照。 為了解決缺乏配對的多視角和多光照視頻的問題,Light-X 引入了Light-Syn,這是一種基於退化和逆映射的流程,它利用自然場景下的單目視頻素材合成訓練對。此策略產生了一個涵蓋靜態、動態和 AI 生成場景的資料集,確保了訓練的穩健性。大量實驗表明,Light-X 在聯合相機光照控制方面優於基線方法,並且在文字和背景兩種條件下均優於以往的視訊重光照方法。
Light-X 是個視訊生成框架,它能夠從視訊中實現可控渲染,並同時控制視角和光照。
Light-X 提出一種解耦設計,將幾何形狀和光照信號解耦:幾何形狀和運動通過沿用戶定義的相機軌跡投影的動態點雲來捕獲,而光照線索則由始終投影到相同幾何形狀的重新光照幀提供。這些明確的、細粒度的線索能夠有效地解耦,並指導高品質的光照。
為了解決缺乏配對的多視角和多光照視頻的問題,Light-X 引入了Light-Syn,這是一種基於退化和逆映射的流程,它利用自然場景下的單目視頻素材合成訓練對。此策略產生了一個涵蓋靜態、動態和 AI 生成場景的資料集,確保了訓練的穩健性。大量實驗表明,Light-X 在聯合相機光照控制方面優於基線方法,並且在文字和背景兩種條件下均優於以往的視訊重光照方法。
