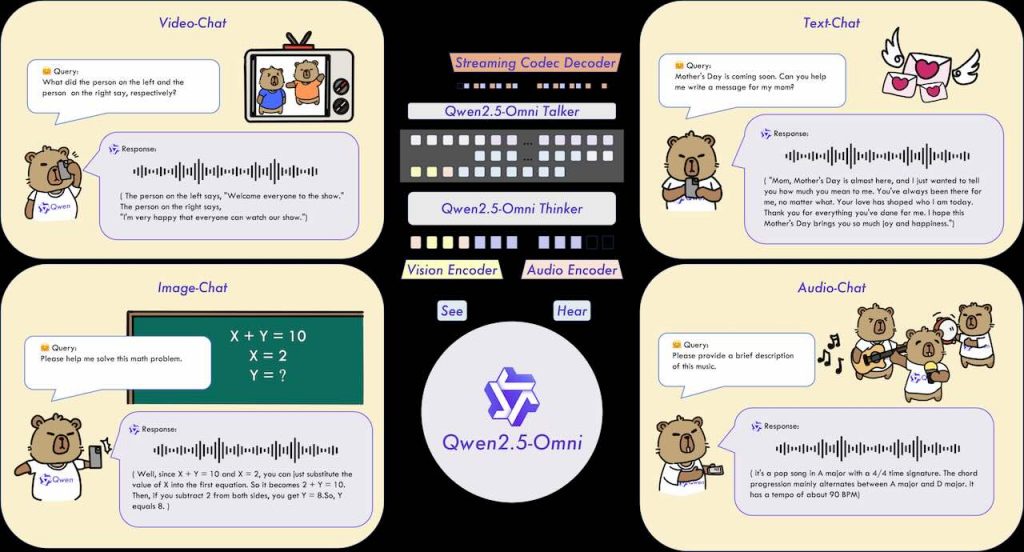
Qwen 2.5 Omni 7b 通義千問多模態模型

 Qwen 2.5-Omni,是一個由阿里巴巴團隊開發的端對端多模態模型。它的主要目的是統一處理輸入的文字、圖像、音訊和影片,能同時生成文字和自然語音作為回應。模型在多模態輸入的感知、文字與語音的同步生成以及串流處理的優化等方面都採用了創新技術同埋架構,例如 TMRoPE 時間對齊編碼和 Thinker-Talker 架構。下面的影片詳細示範了 Qwen 在不同的應用場景下的優秀表現。

 Qwen 2.5-Omni,是一個由阿里巴巴團隊開發的端對端多模態模型。它的主要目的是統一處理輸入的文字、圖像、音訊和影片,能同時生成文字和自然語音作為回應。模型在多模態輸入的感知、文字與語音的同步生成以及串流處理的優化等方面都採用了創新技術同埋架構,例如 TMRoPE 時間對齊編碼和 Thinker-Talker 架構。下面的影片詳細示範了 Qwen 在不同的應用場景下的優秀表現。

Qwen2.5-Omni-7B: Voice Chat + Video Chat! Powerful New Opensource end-to-end multimodal model
Categories: 開源, 模型, 多模態模型

DeepHermes 3 內置推理的 LLM 模型

DeepHermes 3 Preview 是世界上第一批能夠將推理和正常 L L M 模式整合的模型之一。它包括高級的代理能力、更好的角色扮演、推理、能夠保持十分長的上下文連貫性對話。而且只要簡單的系統提示詞,就可以即刻啟動推理能力 Reasoning。

DeepHermes 3 Preview 是世界上第一批能夠將推理和正常 L L M 模式整合的模型之一。它包括高級的代理能力、更好的角色扮演、推理、能夠保持十分長的上下文連貫性對話。而且只要簡單的系統提示詞,就可以即刻啟動推理能力 Reasoning。

Categories: 開源, 模型

DeepSeek-R1 的強化學習可視化

影片主要講解 DeepSeek R1 模型背後的強化學習演算法,並著重於如何透過人類回饋來訓練獎勵模型。包括如何根據人類對不同回應的偏好來調整獎勵值。接著深入探討 “近端策略優化”(Proximal Policy Optimization)演算法的細節。同時亦探討如何利用 “優勢函數”(Advantage Function)避免偏離原始策略。最後,影片亦解釋了如何運用群體策略優化成高於平均水準的回應,同時亦阻止了低於平均水準的回應,而因此提升了模型的推理能力。

影片主要講解 DeepSeek R1 模型背後的強化學習演算法,並著重於如何透過人類回饋來訓練獎勵模型。包括如何根據人類對不同回應的偏好來調整獎勵值。接著深入探討 “近端策略優化”(Proximal Policy Optimization)演算法的細節。同時亦探討如何利用 “優勢函數”(Advantage Function)避免偏離原始策略。最後,影片亦解釋了如何運用群體策略優化成高於平均水準的回應,同時亦阻止了低於平均水準的回應,而因此提升了模型的推理能力。

Reinforcement Learning in DeepSeek-R1 | Visually Explained
Categories: 開源, 模型, DeepSeek, 教學

BFS-Prover 自動定理證明

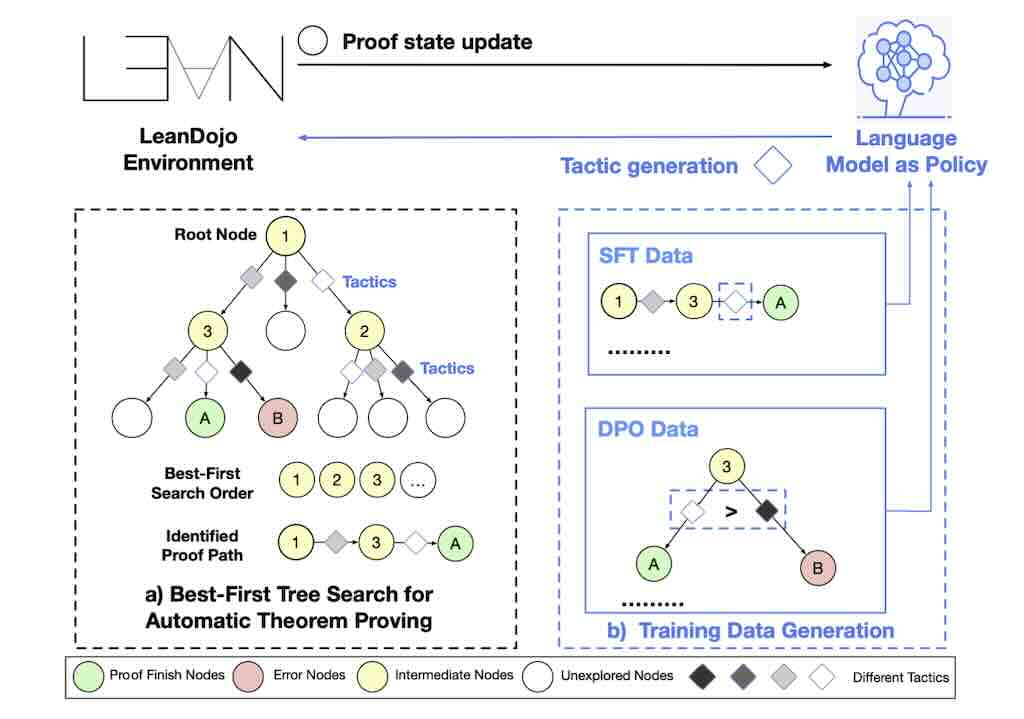
最佳優先搜尋 (BFS Best-First Tree Search) 是一種樹狀搜尋演算法,它透過優先從機率最高的節點來運作,屬於簡單和效率演算法,但普遍認為對於證明定理並不是最理想的方法。 BFS-Prover 挑戰了傳統觀點,提出一種可擴展的專家疊代框架,主要包含了三個創新點:一是策略性數據過濾,二是利用編譯回饋進行直接偏好優化 (DPO) Direct Preference Optimization,三是長度正規化。

最佳優先搜尋 (BFS Best-First Tree Search) 是一種樹狀搜尋演算法,它透過優先從機率最高的節點來運作,屬於簡單和效率演算法,但普遍認為對於證明定理並不是最理想的方法。 BFS-Prover 挑戰了傳統觀點,
提出一種可擴展的專家疊代框架,主要包含了三個創新點:一是策略性數據過濾,二是利用編譯回饋進行直接偏好優化 (DPO) Direct Preference Optimization,三是長度正規化。

Categories: 開源, 模型, 推理引擎

Deepseek – VL2 視覺模型

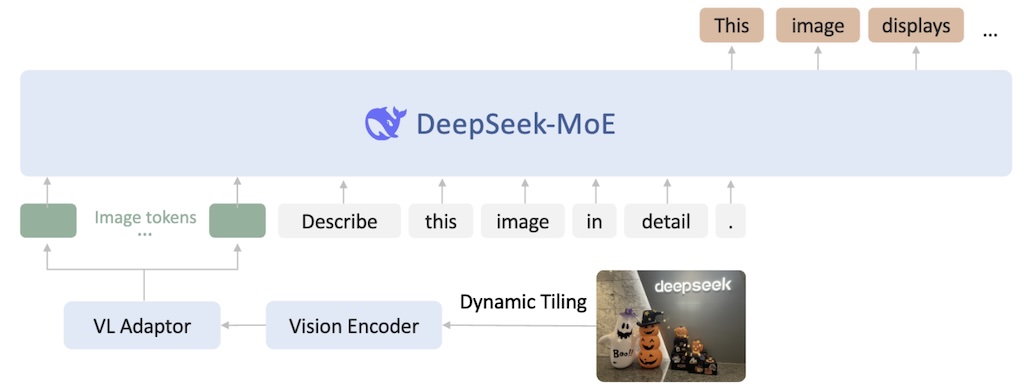
DeepSeek-VL2 使用 MoE 混合專家 Mixture-of-Experts 的視覺語言模型,主要在於提升多模態理解能力。DeepSeek-VL2 在視覺問答、光學字元識別、文件理解和視覺基礎等方面表現出色。模型包含三個版本:Tiny、Small 和 Base,並提供了模型下載、Gradio web 介面範例。

DeepSeek-VL2 使用 MoE 混合專家 Mixture-of-Experts 的視覺語言模型,主要在於提升多模態理解能力。DeepSeek-VL2 在視覺問答、光學字元識別、文件理解和視覺基礎等方面表現出色。模型包含三個版本:Tiny、Small 和 Base,並提供了模型下載、Gradio web 介面範例。

Categories: 模型, 多模態模型

ACE++ 圖像生成與編輯任務

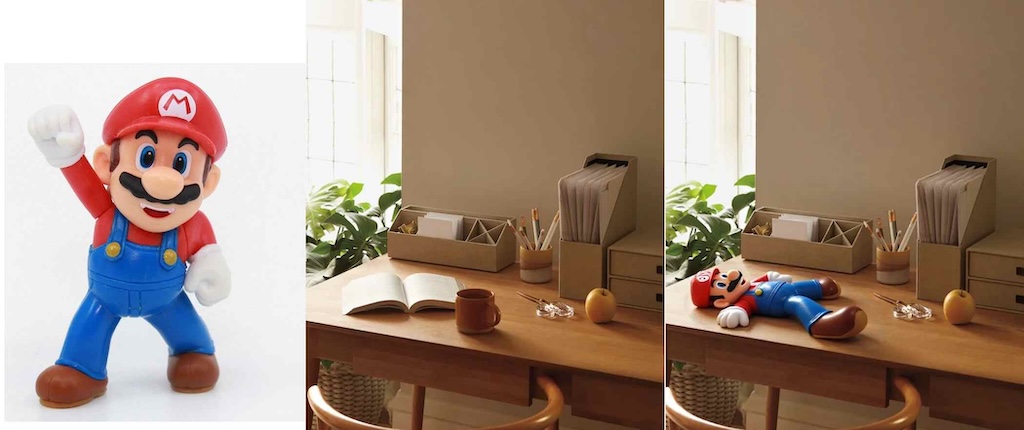
ACE++ 基於指令的擴散框架,只要輸入一張圖像即可生成與角色一致的新圖像,專門用來處理各種圖像生成和編輯任務。靈感來自 FLUX.1-Fill-dev 的輸入格式,以雙階段訓練方法來減少對圖像擴散模型進行微調所需的工作量。這框架提供了全面的模型集,涵蓋了完整微調和輕量級微調,在生成圖像品質和遵循提示能力方面展現了卓越的性能,可以廣泛應用於人像一致性、靈活指令描述和局部編輯等不同情境。

ACE++ 基於指令的擴散框架,只要輸入一張圖像即可生成與角色一致的新圖像,專門用來處理各種圖像生成和編輯任務。靈感來自 FLUX.1-Fill-dev 的輸入格式,以雙階段訓練方法來減少對圖像擴散模型進行微調所需的工作量。這框架提供了全面的模型集,涵蓋了完整微調和輕量級微調,在生成圖像品質和遵循提示能力方面展現了卓越的性能,可以廣泛應用於人像一致性、靈活指令描述和局部編輯等不同情境。

Categories: ComfyUI, 模型, 影像處理

YuE 支持粵語的開源音樂模型

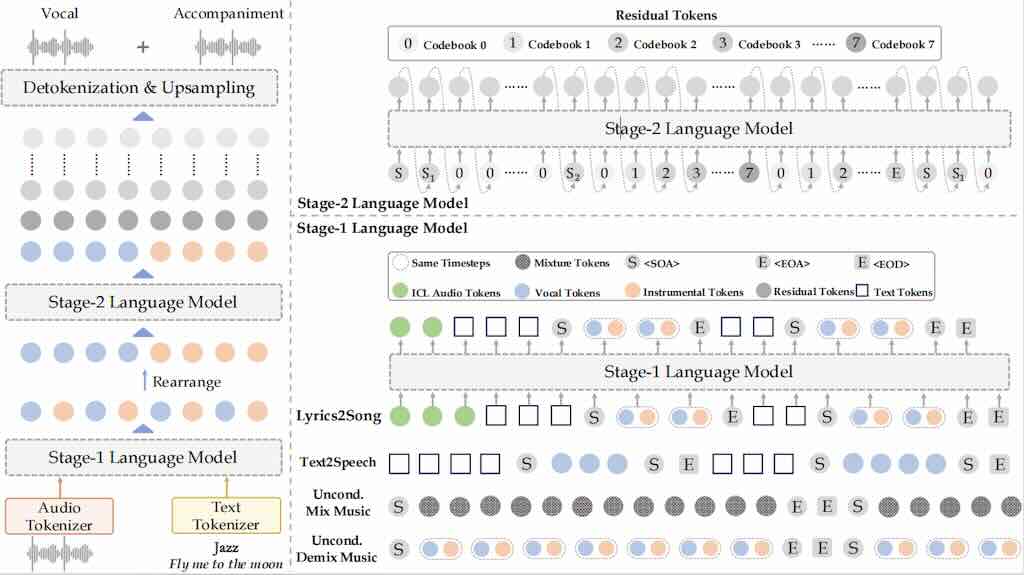
YuE 是一套開源的音樂基礎模型,專為歌詞生成完整歌曲而設計。這個名為 “lyrics2song” 的任務極具挑戰性,因為它需要處理音樂的長時序特性、音樂的複雜性、歌詞的語意,並運用語意增強的音訊雙符記技術、歌詞鏈式思考以及三階段訓練等創新方法,成功生成長達五分鐘的歌曲,並在多種音樂風格和語言中展現了令人印象深刻的結果。(支持生成塑料粵語歌)

YuE 是一套開源的音樂基礎模型,專為歌詞生成完整歌曲而設計。這個名為 “lyrics2song” 的任務極具挑戰性,因為它需要處理音樂的長時序特性、音樂的複雜性、歌詞的語意,並運用語意增強的音訊雙符記技術、歌詞鏈式思考以及三階段訓練等創新方法,成功生成長達五分鐘的歌曲,並在多種音樂風格和語言中展現了令人印象深刻的結果。(支持生成塑料粵語歌)

YuE - Local Music Generation with Audio Prompts - FOSS - 6GB VRAM!
Categories: 開源, 模型, 音樂

Page Assist 瀏覽器擴充功能

Page Assist 是一個瀏覽器外掛,透過 Ollama 於本機運行 AI 模型,Page Assist 提供了一個十分完善的 Ollama介面。Page Assist 強調不會收集個人資料,十分注重隱私。專案是由 MIT 授權。

Page Assist 是一個瀏覽器外掛,透過 Ollama 於本機運行 AI 模型,Page Assist 提供了一個十分完善的 Ollama介面。Page Assist 強調不會收集個人資料,十分注重隱私。專案是由 MIT 授權。

Categories: 開源, Embedding, 模型, Ollama

DeepSeek R1 的冷啟動 1.5b 微調

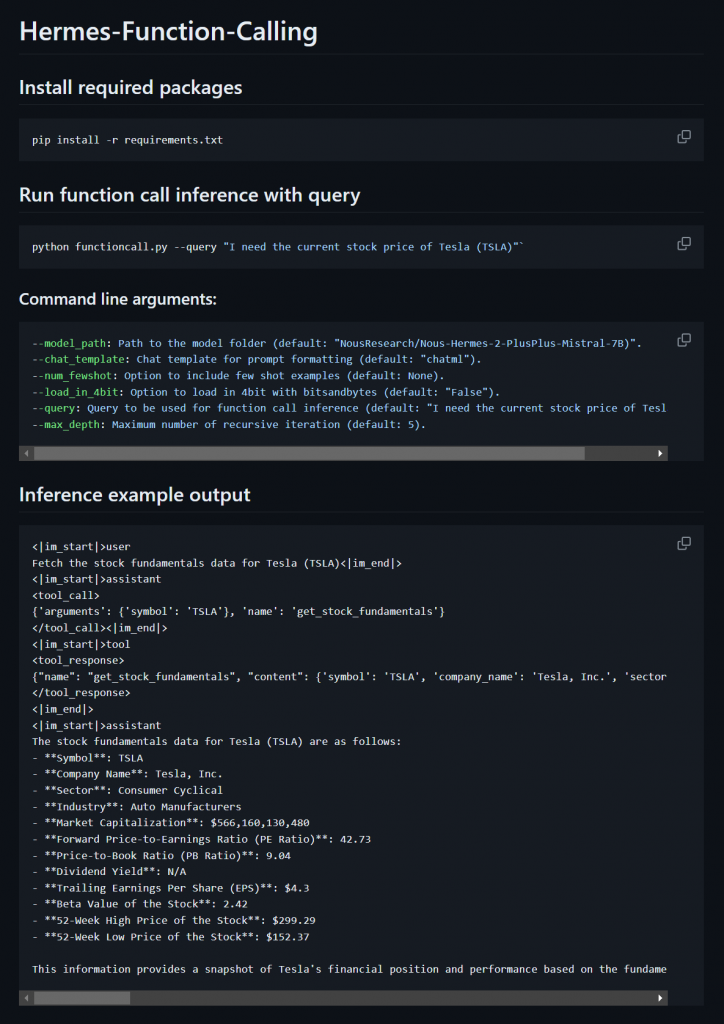
影片主要講解了如何使用冷啟動技術來提升小型語言模型(LLM)的推理能力,特別是在數學問題上的表現。影片的核心在於重現 DeepSeek R1 模型論文中提到的冷啟動方法,即透過少量高品質的合成數據集,讓模型在強化學習前就能夠生成清晰且連貫的思考鏈。這些數據集利用數學編譯器來產生精確的步驟式解題過程,並使用大型語言模型生成自然語言解釋,進而微調一個只有 15 億(1.5b)參數的小型模型,使其能夠進行複雜的數學推理,並在思考(think)和回答(answer)標籤中呈現其推理過程,而最終結果顯示即使是小型模型,也能透過冷啟動技術達到令人印象深刻的推理能力。影片也強調了冷啟動數據集的多樣性,包括數學、程式碼和其他領域,才能使模型具有強大的通用能力。
影片主要講解了如何使用冷啟動技術來提升小型語言模型(LLM)的推理能力,特別是在數學問題上的表現。影片的核心在於重現 DeepSeek R1 模型論文中提到的冷啟動方法,即透過少量高品質的合成數據集,讓模型在強化學習前就能夠生成清晰且連貫的思考鏈。這些數據集利用數學編譯器來產生精確的步驟式解題過程,並使用大型語言模型生成自然語言解釋,進而微調一個只有 15 億(1.5b)參數的小型模型,使其能夠進行複雜的數學推理,並在思考(think)和回答(answer)標籤中呈現其推理過程,而最終結果顯示即使是小型模型,也能透過冷啟動技術達到令人印象深刻的推理能力。影片也強調了冷啟動數據集的多樣性,包括數學、程式碼和其他領域,才能使模型具有強大的通用能力。
DeepSeek R1 Coldstart: How to TRAIN a 1.5B Model to REASON
Categories: 模型, 模型訓練

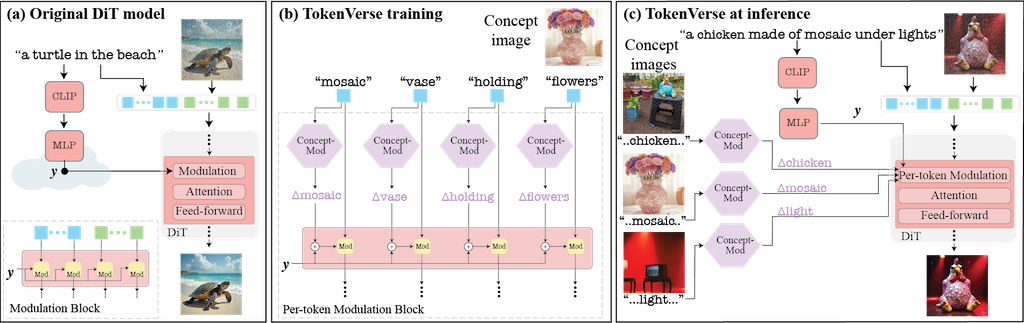
TokenVerse – Google 最新圖像處理

TokenVerse 提出一種基於預訓練文字轉圖像擴散模型的多概念個人化方法。它利用模型中的調製空間 (modulation space),從單張圖片中解開複雜的視覺元素和屬性,並能無縫地組合來自多張圖片的概念。不同於現有方法在概念類型或廣度上的限制,TokenVerse 能處理多張圖片的多種概念,包含物件、配件、材質、姿勢和光線等。核心方法是透過優化,為每個文字嵌入 (text embedding) 學習一個獨特的調製向量調整 (modulation vector adjustment),這些向量代表個人化的方向,可用於產生結合所需概念的新圖像。最後,論文展示了 TokenVerse 在具有挑戰性的個人化情境中的有效性,並突顯其優勢。

TokenVerse 提出一種基於預訓練文字轉圖像擴散模型的多概念個人化方法。它利用模型中的調製空間 (modulation space),從單張圖片中解開複雜的視覺元素和屬性,並能無縫地組合來自多張圖片的概念。不同於現有方法在概念類型或廣度上的限制,TokenVerse 能處理多張圖片的多種概念,包含物件、配件、材質、姿勢和光線等。核心方法是透過優化,為每個文字嵌入 (text embedding) 學習一個獨特的調製向量調整 (modulation vector adjustment),這些向量代表個人化的方向,可用於產生結合所需概念的新圖像。最後,論文展示了 TokenVerse 在具有挑戰性的個人化情境中的有效性,並突顯其優勢。

Categories: 開源, 模型, 影像處理

Page 53 of 59
1 … 51 52 53 54 55 … 59