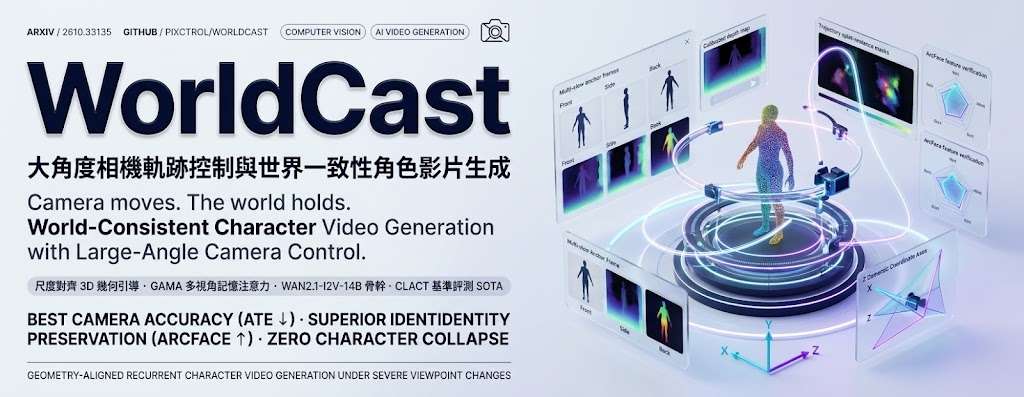
WorldCast 讓角色跟隨大角度鏡頭仍保持一致

只需一張參考圖、鏡頭軌跡及最多四張不同角度的錨點圖,WorldCast 便可生成保持角色身份的影片。

logo

只提供一張參考圖、目標鏡頭軌跡,以及 1 至 4 張不同視角的角色錨點圖,WorldCast 便能生成跟隨多角度運鏡的角色影片,同時減少轉換視角時身份走樣。這個開源模型項目針對的是影片生成中「鏡頭要郁得大」與「角色外觀要保持」難以兼顧的問題。

它以 Wan2.1-I2V-14B-720P 作為基礎模型,再加入 scale-aligned geometric guidance 和 Geometry-Aligned Memory Attention(GAMA)。前者把初始畫面轉成具校準深度的彩色 3D 點雲,沿目標軌跡渲染出 RGB 引導與 coverage mask;後者透過 Umeyama alignment 對齊多視角角色記憶,將相關特徵注入影片 token,補足新視角內容。

  • 支援 360° 鏡頭移動
  • 使用多視角 anchor images 維持角色身份
  • CLACT 包含 80,000 個訓練樣本及 42 個評測場景
  • 以 ATE、MEt3R 和影像品質比較結果

GitHub 已提供 inference code 和示範案例,但 WorldCast checkpoint、CLACT dataset 及 training code 尚未公開,因此下載 Wan2.1 基礎權重後仍未能完整執行示範。推理建議使用 Python 3.10 或以上、bf16,以及至少 48 GB 顯存;解析度和影片幀數提高後,記憶體需求亦會增加。

結果以較低的 ATE 和 MEt3R 對應更準確的鏡頭控制及跨視角一致性,影像質素則維持具競爭力。電影預視、角色廣告、遊戲過場及需要指定運鏡的生成影片工作流較適合採用。
項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Video, Image, Content Creator, 3D, Python, Dataset 數據集

RoboJudge:把影片的物理合理性與指令分開評測

RoboJudge 分開檢視具身影片的物理合理性與指令完成度,並以人類評分訓練模型,供團隊比較生成結果。

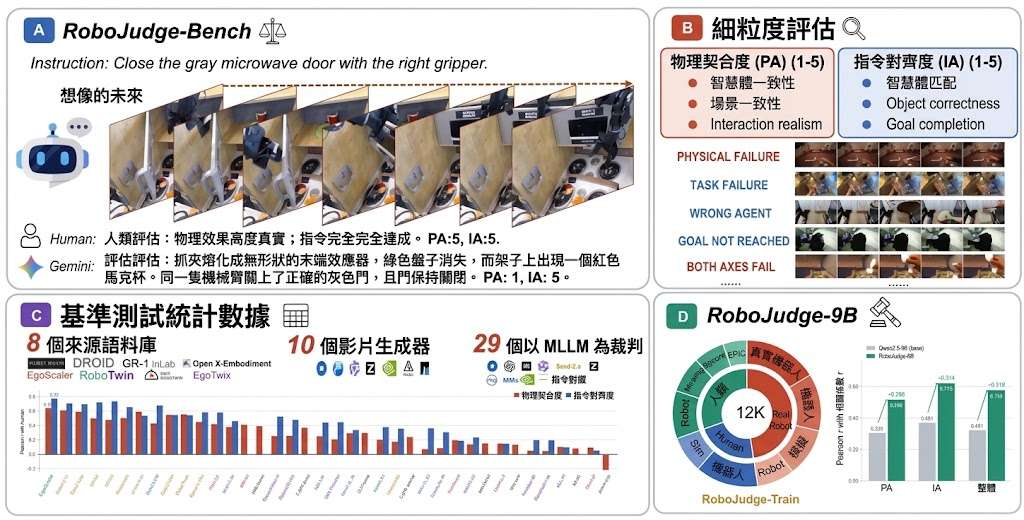
RoboJudge overview

具身影片可能動作自然卻未完成指令,也可能完成任務但違反物理規律。RoboJudge 以 Multimodal Language Models (MLLMs) 評審生成影片,分開衡量 Physical Adherence (PA,物理遵循) 與 Instruction Alignment (IA,指令符合度)。

這有助機械人及具身世界模型團隊分辨動作可信度和任務完成度。RoboJudge-Bench 收錄 800 段人工標註影片,涵蓋 8 個語料來源、10 個影片生成器,以及夾爪、人手與靈巧手。

RoboJudge-Train 收錄 12,000 段影片及 25,000 筆人工評分與理由;RoboJudge-9B 經監督學習及強化學習訓練。Pearson 相關係數在 PA 為 0.645、IA 為 0.775、整體為 0.719,較測試中的最佳專有基線高 0.089;相關性不代表每次判斷都正確。

GitHub 提供推理和基準評估程式,並連結模型與資料集。README 列出依賴安裝及執行流程,但沒有硬件需求資料,採用前宜先確認設備能否負擔模型載入與影片處理。

  • PA 檢視影片是否符合物理與時間約束。
  • IA 檢視影片動作是否符合指令。
  • 基準可用於比較評分,不能取代人工核對。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Video, 香港, Dataset 數據集, 強化學習

MotionBricks 讓動畫或機械人即時串接自然動作

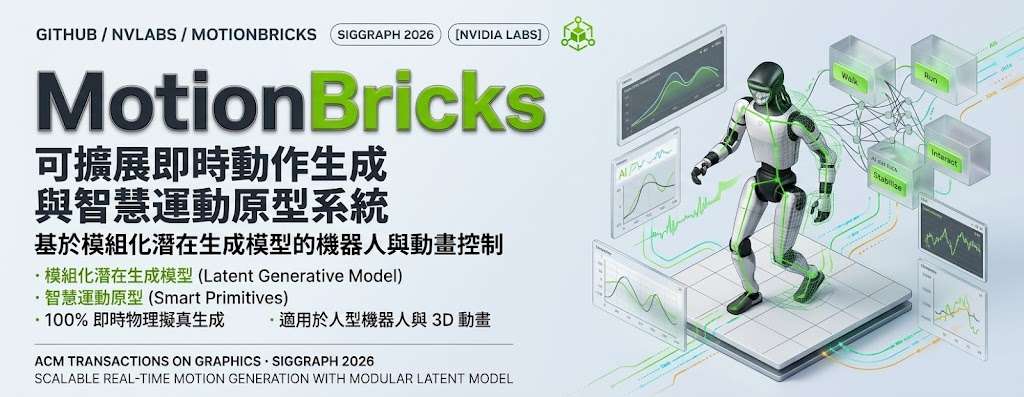
只需提供角色最近的姿勢和目標姿勢,MotionBricks 就能生成中間動作,並把行走、跨越或坐下等行為組合成連貫場景。

MotionBricks animates characters and robots with one model

機械人或遊戲角色要由一個姿勢自然移動到另一個姿勢,MotionBricks 可以即時補出中間動作。這個模組化潛在生成模型(modular latent generative model)支援角色與機械人動畫,透過最近四個姿勢作為上下文,再以一至四個目標姿勢控制終點及抵達時的動作方式。

它提供 SOMA 人體模型和 Unitree G1 機械人的預訓練模型,並附有 Python 執行環境、動作示範及場景編輯器。使用者可在 Inbetweener 放置姿勢來生成動作,也可用 Scene Preview 測試角色在場景中行走、奔跑、跨越、躲避和坐下;編輯器則可製作 Smart Primitives,將導航與物件互動動作組合起來,無須為新行為重新訓練模型。

MotionBricks 的做法,是讓三個學習模組分工生成動作,再以 Smart Primitives 提供可組合的行為積木。研究團隊表示,模型涵蓋超過 35 萬段動作,並可用於新任務而無須微調或逐項標記;這有助遊戲動畫、機械人模擬及互動場景製作,但實際效果仍取決於目標姿勢和場景設定。

項目網站報告最高每秒 15,000 FPS、延遲 2 毫秒。執行環境依賴 NVIDIA GPU 和 TensorRT,示範曾在 Windows 及 Linux x86-64、配備 GeForce RTX 4090 的系統測試;首次載入模型與精度設定時,還要建立 TensorRT 執行計劃,因此這些數字不宜直接視為所有硬件上的保證。

  • 支援 SOMA 人體模型及 Unitree G1 預訓練模型,模型以 ONNX 提供,檢查點則放在 Hugging Face。
  • Python 執行環境以 Warp、Newton 和 TensorRT 串接多次生成,形成連續動作。
  • 附有 Inbetweener、Scene Preview,以及 Smart Primitives 和場景編輯器。
  • 儲存庫提供導覽教學;但執行需要 NVIDIA GPU,設定亦涉及 Git LFS、uv 和首次建立 TensorRT 計劃。

對需要快速製作可控角色動畫、驗證機械人動作或搭建互動場景的團隊,MotionBricks 提供由姿勢控制到行為組合的一套研究原型。它減少了手工編排動作轉場及為每個任務重新訓練的需要,但硬件門檻和場景設定工作仍需納入製作流程。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, NVIDIA, 教學, Linux, Python, 庫, 動畫, Dataset 數據集

magpie:通過本機閘道,把不同 AI 編程代接上同一模型

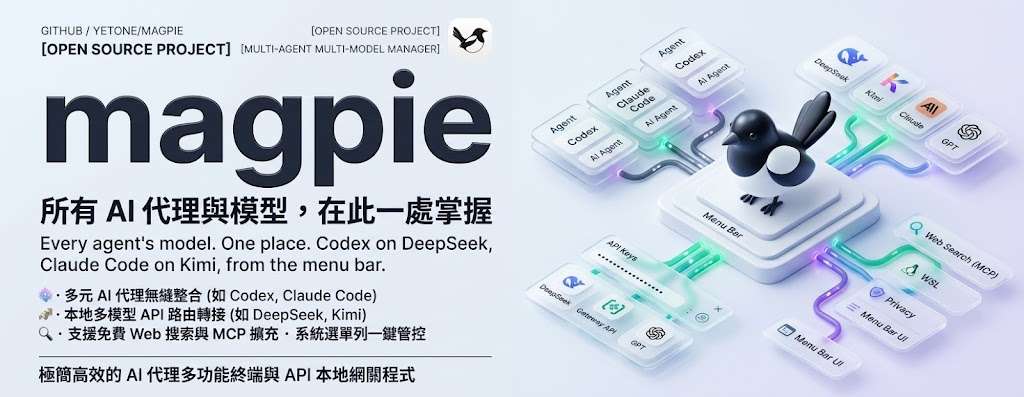
Claude Code、Codex、Gemini CLI 等代理可以各自改用其他模型或訂閱帳戶;配額用完時,Magpie 亦可按設定切換帳戶或路由到其他服務。

magpie

想讓 Claude Code 用 Kimi、Codex 用 DeepSeek,或者讓 OpenCode 使用 ChatGPT 訂閱模型,不必逐個代理手動改一堆設定。Magpie 是一款跨平台工具,透過本機閘道統一管理模型與供應商,並從選單列切換代理設定;它改動的是各代理自己的關鍵設定,並非把不同代理合併成同一個程式。

它支援 API key、本機模型,以及 Claude、ChatGPT、Copilot、Gemini、Grok 等已登入帳戶。Claude 整合會呼叫本機的 Claude CLI,並透過 MCP(Model Context Protocol)橋接代理工具;ChatGPT 訂閱模型則可供其他代理使用。這讓使用者能沿用熟悉的代理工作流程,同時更換背後的模型來源。

配額耗盡時,Magpie 可改用同一供應商的另一個帳戶;若設定了路由群組,也可轉往其他模型或供應商。沒有備用帳戶或路由群組時,錯誤仍會傳回代理,因此不中斷並非無條件保證。隱私遮罩則須在設定中手動開啟,啟用後會在請求離開本機前遮蔽提示中的金鑰、密碼和電郵地址,再把內容還原到回覆。

  • 從同一份清單為不同代理選擇模型,減少逐個修改設定的工作。
  • 可混用雲端 API、本機模型和已登入的訂閱帳戶。
  • 帳戶或路由備援可降低配額用盡造成的中斷,但須先配置可用的後備路徑。
  • 隱私遮罩預設關閉,敏感資料保護需自行啟用。

對同時使用多個 AI 編程代理、需要管理不同供應商帳戶的個人或團隊,Magpie 可集中處理切換與備援;若只用單一帳戶,或不希望工具改寫代理設定,收益會較有限。項目支援 macOS、Windows、Linux、Docker 和 Termux;提供下載與文件,但所給資料未列出效能測試或延遲數據,選用前宜確認所需代理、模型與登入方式均在支援範圍內。

GitHub

Categories: 開源, MCP, 模型, 微軟, OpenAI, DeepSeek, Gemini, API, 工具, Mac, Linux, 編程, Anthropic, Kimi, MiniMax

ComfyUI Graph Grid:一個比較提示詞、LoRA 與模型設定

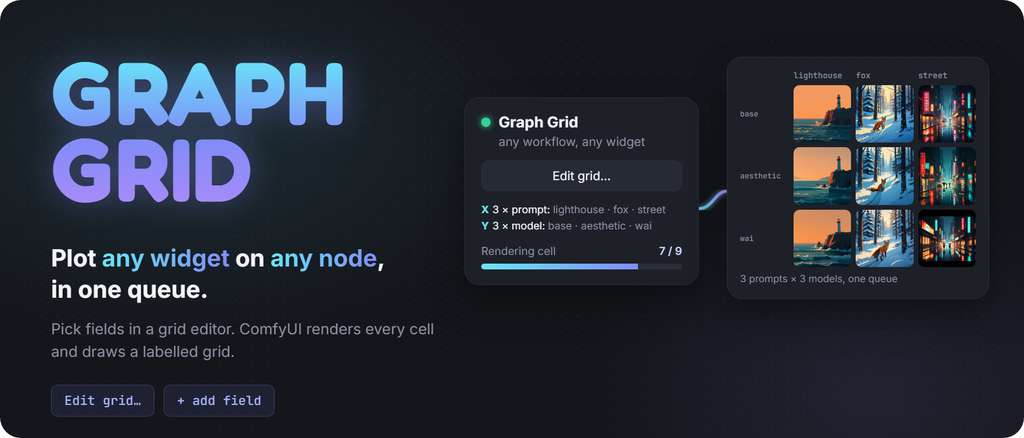
ComfyUI Graph Grid 將不同提示詞、LoRA 強度、採樣器或 checkpoint 排成圖表,列隊生成,方便逐格比較結果。

Graph Grid: plot any widget on any node, in one queue

將提示詞、LoRA 強度、CFG、採樣器或 checkpoint 放到行列中比較,ComfyUI Graph Grid 會一次佇列所有組合,再輸出附有標籤的圖像網格。它屬於 ComfyUI 自訂節點,處理的是影像生成工作流中逐組改參數、逐張記錄和肉眼比對過於零散的問題。

安裝可透過 ComfyUI Manager 搜尋 Graph Grid,或放入 ComfyUI/custom_nodes 後重新啟動。使用時把最終影像輸出接到 Graph Grid,再把 grid 輸出接至 Preview Image 或 Save Image;在編輯器中選擇要變動的 widget,填入行列值後佇列生成即可。項目已在 ComfyUI 0.41.0 測試,標籤位置亦取決於 Pillow 10.1 或更新版本。

它不要求特別的 loader 或 sampler,而是複製每格需要改動的上游圖段,讓 ComfyUI 執行各組設定;沒有變動的節點可載入一次,重複內容亦有機會由快取提供。接線中的 widget 不能直接變更,必須改動負責輸入的上游節點,其他未接入 Graph Grid 的輸出節點仍會以原值執行。

• 可同時比較多個欄位,亦能用數值範圍、下拉選單選項或逐行文字填充。
• 空白格會保留原本設定,Cross with existing 可建立完整組合。
• 適合測試 LoRA 權重、提示詞、模型和採樣參數的差異。
• 生成量會隨行列組合增加,顯存、時間和輸出整理成本仍需自行控制。

對需要挑選模型、整理提示詞實驗,或為影像生成流程建立可重現比較表的創作者和研究者,Graph Grid 能補足 ComfyUI 原生流程缺少的批量對照介面;它不會替你判斷哪組設定最好,價值在於把比較過程變得一致、可視化和容易回看。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Image, 提示詞, Content Creator, LoRA

Digital Human Koubo:一句需求生成數字人口播廣告,連聲音也自動完成

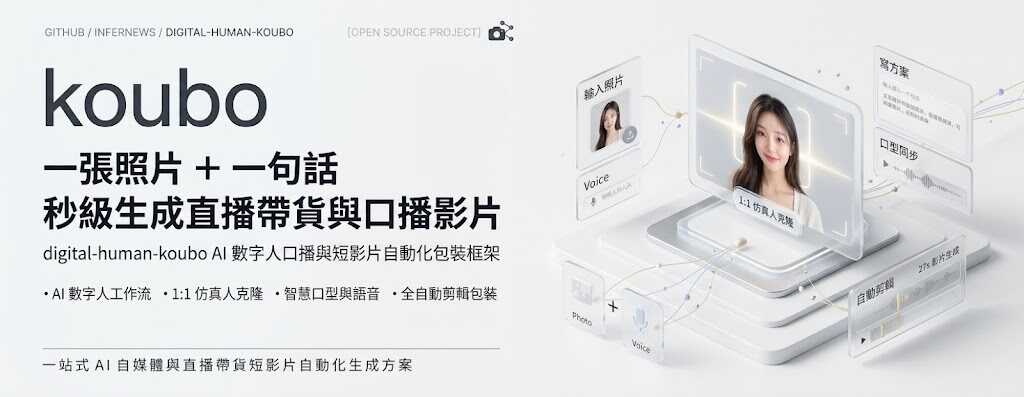
相片加一句需求,就能串起數字人口播、字幕與影片包裝;代價是依賴外部雲端生成。

一張相片加一句需求,便可生成有數字人口播、字幕和促銷包裝的短片。andyhuo520/digital-human-koubo 是由人工智能(Artificial Intelligence,AI)代理執行的影片工作流,串連文案、對嘴、聲音整理和剪輯。

主持人設定存於 persona.json,固定外觀和聲線描述;GPT Image 合成場景後,Grok Video 1.5 經 Renoise 的 Model Context Protocol(MCP)製作每段最多 15 秒的口播片。按 SKILL.md 配置代理並連接服務後,可先看倉庫示例;其中一條 27 秒廣告耗用 482 Renoise credits,不能視為固定價格。

  • Whisper 逐段轉錄核對文稿,每段檢查 4 格畫面;若畫面出現生成字幕,該段會重做。
  • 頻譜匹配、去齒音及響度標準化協助統一分段聲音;測試中的齒音差距由 13.2 dB 降至 5.9 dB。
  • 48 項影片包裝手法參考 25 條創作者影片整理,可按需要增減。

這套流程適合需要反覆製作商品介紹或社交平台短片的小型內容團隊,也能把文字置於主持人身後。成品仍受外部模型服務和點數成本限制,使用前宜先檢查口型、畫面及人物一致性。

GitHub

Categories: 開源, AI productions, MCP, 數字人, 模型, Video, Image, Audio, Content Creator, 庫, Skill 技能

AstrBot:把聊天平台接入大模型

AstrBot 將聊天平台、模型服務與插件串成一個可管理的 AI 助手項目,適合想自建聊天機械人的團隊。

Featured|HelloGitHub

想在 QQ 等聊天平台加入 AI 對話、插件功能和自訂服務,AstrBot 提供的是一套可自行運行的開源框架,而不是單一模型。項目以 Python 3.12+ 為基礎,將訊息接收、模型呼叫及擴充功能放進同一個工作流,減少團隊自行黏合多個服務的工作量。

簡單講係一個「將 AI 接入通訊軟件」嘅開源平台:你可以將雲端或本機大模型,接駁 Telegram、Discord、LINE、Slack、企業微信等平台,變成可以聊天、查知識庫、使用工具同執行任務嘅 AI 助理。佢本身唔係大模型,而係負責整合模型、訊息平台、插件同 Agent 功能。

  • 適合建立個人助理、社群機械人及內部聊天工具
  • Python 生態方便加入自訂插件與外部 API
  • 支援多語言文件,方便跨地區協作
  • 需要自行處理模型服務、平台帳戶及運行環境

相比直接使用封閉式聊天服務,AstrBot 把控制權交回管理者,換來較高的設定彈性和維護成本。它較適合有基本 Python 能力、需要掌握資料流向,或希望按團隊需求改造聊天機械人的使用者;只想即時開啟對話服務的人,則要先考慮環境配置和平台整合工作。

項目本身屬於聊天機械人框架,實際解決的是訊息平台與大型語言模型之間的整合問題。項目提供版本、文件、路線圖及 Issue Tracker 等入口。

GitHub

Categories: 開源, 模型, API, 框架, 工具, Python

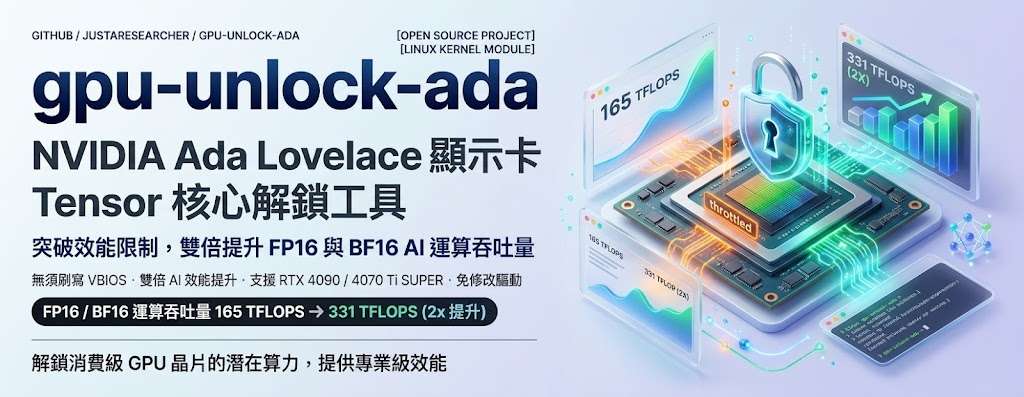
gpu-unlock-ada:RTX 4090 張量運算吞吐翻倍

Linux 核心模組可在 NVIDIA 驅動程式載入前啟用 Ada GPU 的 SM speed-select override,讓 RTX 4090 的 FP16、BF16 張量指令吞吐接近翻倍。實際 GEMM 增幅較小,量化推理甚至沒有受益。

Repository image for JustAResearcher/gpu-unlock-ada

想提升 RTX 4090 的 FP16、BF16 張量運算能力,這個 Linux 核心模組會在原廠 NVIDIA 驅動程式啟動前套用 SM speed-select override。它針對的是 FP32 累加的張量指令路徑,不是全面提高顯示卡效能;項目亦列出 RTX 4070 Ti SUPER 的實驗結果,Ada 系列支援仍須按型號和環境驗證。

測試中,RTX 4090 的 FP16/FP32 指令吞吐由約 160 TF/s 升至 320 TF/s,BF16/FP32 亦接近翻倍。不過,cuBLAS GEMM 的增幅按矩陣尺寸約為 12% 至 34%;量化混合專家模型推理測試則沒有加速,反映指令吞吐提升不等於應用程式整體提速。

模組須在 NVIDIA 驅動程式初始化前生效,因此項目提供 mkinitcpio 和 dracut 的 initramfs 設定方式,並附有 Quick Start、測試流程及各次硬件與驅動程式測試記錄。測試涵蓋 PCIe Function Level Reset、驅動程式交接和數值檢查,但不少結果來自單張顯示卡或單次配對測試,未足以證明長期穩定性。

• RTX 4090 的 FP16、BF16 張量指令吞吐接近翻倍。
• GEMM 增幅依矩陣形狀而異,量化推理未見收益。
• 支援依賴核心、顯示卡型號及 NVIDIA 驅動程式組合。
• 適合有 Linux GPU 測試環境、能自行核對結果的研究者與工程團隊。

對需要測試 NVidia RTX 4090 Ada GPU 張量指令上限的團隊,這項目提供了可查閱的測試流程與硬件證據;若工作負載主要依賴量化矩陣運算,或要求長時間穩定運行,現有結果並未證明它能帶來相應收益。

GitHub

Categories: 開源, 模型, NVIDIA, Linux, 庫

detectorscope:DeepMind AI 文字偵測器,逐句交代判斷依據

AI 文字偵測常被質疑只給標籤、看不到理由;DetectorScope 會列出影響判斷的文字特徵,並標示它們出現的位置。

DetectorScope demo

當文字被判定為 AI 生成,DetectorScope 會進一步指出哪些字詞或句式推高了判斷分數,並讓使用者在文字上查看相關片語。這個開源工具把黑箱 AI 文字偵測器轉成可檢視特徵的系統,也能用來分析不同語言模型的寫作習慣。

它先在偵測器的 residual stream 上訓練稀疏自編碼器(SAEs),為特徵產生描述和驗證分數,再篩選合格特徵,交由稀疏分類頭作出預測。結果會列出 AI 機率、特徵描述及各特徵的影響方向;示例中,「about」作介詞和重複語句提高 AI 分數,而口語填充語則降低分數。

你可以先到 Hugging Face Space 試用示範,開發者則可透過 Python 套件載入預訓練的 liamdugan/detector-scope 模型,提交文字並讀取特徵結果。亦把自有黑箱偵測器轉成可審核版本的流程,但沒有提供可據以比較準確率或誤判率的評測數據。

  • 判斷結果附有可讀特徵,並可定位相關文字片段。
  • 特徵描述及驗證分數用來篩選分類器採用的訊號。
  • 可用於檢視模型文字傾向,或研究偵測器如何作出判斷。
  • 特徵解釋有助審查結果,但不能單憑解釋證明偵測準確或公平。

對研究文字偵測、模型行為或內容審核的團隊而言,DetectorScope 提供了比單一 AI 標籤更可追查的分析線索。由於資料未列出不同領域、語言或改寫文本上的可靠度,涉及學術紀律或其他高風險決策時,仍應配合人工審核,避免把偵測分數當成定論。

GitHub

Categories: 開源, 模型, 模型訓練, Google, 工具, Python

StateTree-Representation:讓 LLM 壓縮後仍保留 BF16 精度

StateTree 同時壓縮模型權重與 KV cache,減少記憶體佔用之餘,生成結果仍可逐 bit 對齊 BF16。

BF16 and statetree answering the same question side by side in vLLM; statetree finishes first with the identical answer

大型語言模型在長上下文或多請求場景,瓶頸往往不是算力,而是反覆讀取權重和 KV cache。StateTree 以約 12 bits 儲存原本 16-bit 的資料,屬於結合模型表示法與推理引擎的開源項目,處理的是記憶體流量、快取容量與生成速度之間的取捨。

它把每組權重表示成共享離散決策的 state tree,並以 fused CUDA kernels 直接在 vLLM 和 🤗 Transformers 中解碼;KV cache 則以每個 vLLM block 16 tokens、每個 KV head 四組 16 × 64 records 儲存。權重與 cached key/value 都能還原至 exact BF16 bits,不涉及 quantization、calibration 或精度換取壓縮率。

Qwen3-8B 在單張 A100-40GB、vLLM 0.32 的測試中,權重由 15.3 GiB 降至 12.8 GiB,KV cache 每 token 由 144 KiB 降至 112.5 KiB;同一 GPU 預算可容納 1.49 倍 tokens,batch 1 生成速度由 75.6 提升至 97.2 tok/s,完整回答快 1.10 至 1.28 倍。Decode attention 相對 FlashAttention-2 則達 1.21 至 2.46 倍,但結果會受 GPU、批次大小和上下文長度影響。

測試需要 NVIDIA sm_80 或更新架構、CUDA 12.6,以及項目列出的 PyTorch、vLLM 0.32 或 Transformers 5.0 環境;可先用 greedy generation、prefix-cache hit 和長 prompt chunk prefill 對比 BF16。teacher-forced top-1 token 一致率為 97.6% 至 99.8%,差異集中於近似機率的 token,適合重視容量和吞吐、又不能接受量化誤差的推理服務團隊。

  • 權重及 KV cache 均可逐 bit 還原至 BF16
  • 權重佔用減少 24%,KV cache 佔用減少 22%
  • 支援 vLLM fused kernels、paged blocks 和 prefix caching
  • 測試結果涵蓋小 batch、長上下文及多請求情境
  • 需要相容的 NVIDIA GPU、CUDA 與指定框架版本

項目主頁 · GitHub

Categories: 開源, 模型, Qwen, NVIDIA, 框架, Python, 推理引擎

Page 3 of 59
1 2 3 4 5 … 59