Motion-Omni:「講嘢」同「做嘢」視為同一件事,直接生成全身動作

Motion-Omni 把語音和全身動作綁在同一個模型,講一句話就能即時生成對應嘅身體動作、表情同手势,適合需要邊講邊做嘅虛擬角色。

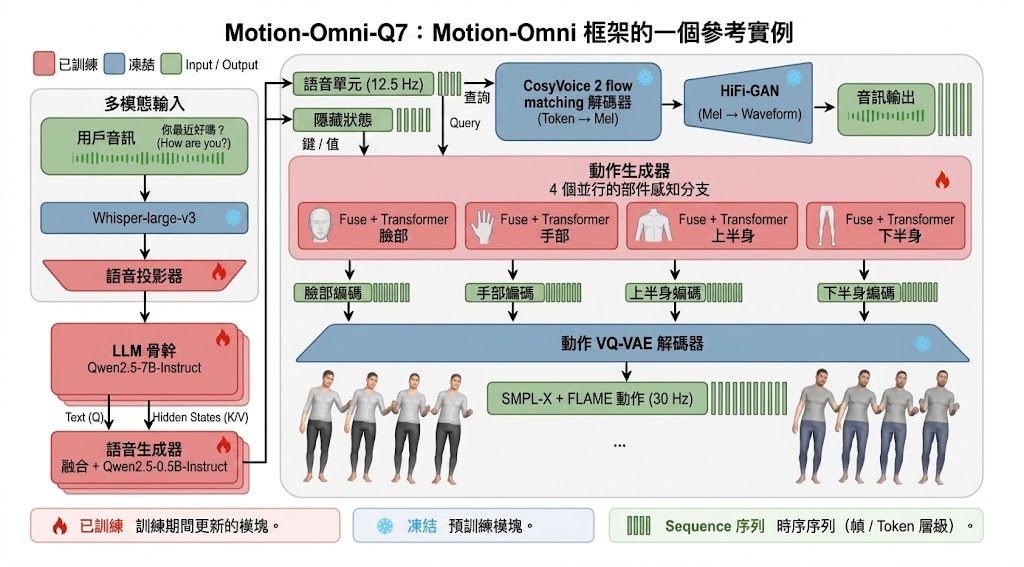
Motion-Omni framework

試過睇虛擬角色傾偈,個口形郁但身體硬晒,或者要逐段人手配動作?Motion-Omni 想解決嘅就係呢種「聲有、體無」嘅唔自然感。佢係一個端到端嘅多模態模型,輸入一段語音,輸出唔只有語音本身,仲有頭部、表情、手势以至全身姿態,全部喺同一個框架一齊生成,避免傳統做法分開處理再硬砌嘅斷裂感。

Motion-Omni 用咗一個統一嘅 tokenizer 把語音、文本同動作 token 化,配合 LoRA(Low-Rank Adaptation)adapter 等輕量微調技術,令模型可以同時學語音同肢體表達。生成嘅動作涵蓋手部、軀幹、面部表情,適合需要即時互動嘅場景,例如 AI 助手、虛擬客服、遊戲 NPC、語音驅動嘅動畫原型。

傳統動畫要先錄關鍵動作、再做 lip-sync 後製,而坊間部分開源方案往往只能控制頭部或者手部其中一樣。Motion-Omni 嘅做法係將「講嘢」同「做嘢」視為同一件事,所以動作會跟語氣、節奏同步變化,唔使額外人手調整。佢同時支援文字輸入,等開發者可以更直接控制角色行為。

對做 AI 角色、互動內容、語音動畫嘅團隊嚟講,呢種端到端做法可以慳唔少配動作同後製嘅工序,尤其適合需要快速原型嘅項目。讀者可以透過官方頁面睇影片 demo,評估生成動作嘅自然度同延遲表現,再判斷適唔適合自己嘅工作流。

重點摘要

  • Motion-Omni 係一個端到端多模態模型,同時輸出語音、表情同全身動作
  • 用統一 tokenizer 加 LoRA adapter 處理語音、文本同動作 token
  • 覆蓋頭部、手部、軀幹同面部表情,適合即時互動角色
  • 傳統做法分開配音同配動作,呢個模型將兩者合併生成
  • 適用於 AI 助手、虛擬客服、遊戲 NPC、語音動畫原型等場景
項目主頁 · GitHub

Categories: 開源, 香港中文大學, 北京大學, AI productions, 模型, 多模態模型, Video, 框架, 語音, 動畫

MiniMax-H3 Singularity:提升影像轉影片品質

基於 MiniMax-H3 深度微調的多模態影片模型,針對動作模糊、遠景人臉失真與光影過油等痛點進行修補。

Minimax-h3_Singularity 是建基於 MiniMax-H3 的多模態影片生成模型,採用 Apache-2.0 授權,於 ComfyUI 環境原生支援 Text-to-Video(T2V)、Image-to-Video(I2V)、Reference-to-Video(Ref2V)以及 Video-to-Video(V2V)四種工作流程。開發者並非單純做一次 LoRA 貼片,而是將 ref、fl、b25-49 等多個關鍵 checkpoint 進行策略性融合,再以高步數深度微調,最後花三天做精準剪枝與權重優化,目的是在保留 MiniMax-H3 原生 prompt 適應力與泛化能力的同時,壓住高步數訓練帶來的鬼影與過擬合。

這個版本重點針對三類常見瑕疵:高動態場景的運動模糊、Medium-to-Long Shot 距離下的人臉崩壞與糊化,以及人物皮膚過油、光澤不自然的問題。在功能面上,它特別加強了武打對戰、魔法施法、粒子光暈等奇幻動作場景的動感張力,同時提升鏡頭語言對搖鏡、推拉、追蹤等運鏡指令的回應度。

模型以 ComfyUI 節點工作流為主要入口,並附帶 RunningHub 線上 Demo 以及 YouTube、Bilibili 展示頻道連結,方便先觀察實際輸出再決定整合方式。

MiniMax H3 Singularity开源!全面微调融合,基础能力还在!嗨,大家好,这里是啊ban!快去玩!纯推荐分享视频!

重點摘要:

  • 基礎模型:以 MiniMax-H3 為底,融合 ref、fl、b25-49 等 checkpoint 做高步數微調與剪枝
  • 支援工作流:T2V、I2V、Ref2V、V2V 四種 ComfyUI 多模態流程
  • 主要修正:HDR 影像品質、遠景人臉修復、去油感光影、強化武打與魔法 VFX 動感
  • 鏡頭控制:對 pan、tilt、zoom、tracking 等運鏡指令有更敏銳回應

項目主頁

Categories: 開源, ComfyUI, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, Video, Image, MiniMax

MiniMax H3 Semantic Bridge:單卡煉成的極輕量視頻生成適配器

約 11 MB 的小型適配器,可在不改動 H3 權重的情況下,把跨架構語意信號融入 MiniMax H3 的視頻生成流程。

Og image

由社群開發者 speach1sdef178 發佈的 MiniMax H3 Semantic Bridge,基於 MiniMaxAI 嘅 MiniMax-H3 進行延伸,定位係一個輕量嘅 conditioning-space 適配器,主要服務於標準 H3 FL2VA 文字生成視頻流程,整個項目僅用單張 NVIDIA RTX 3090 Ti 24 GB 完成訓練,並無動用多 GPU 叢集。

這並非 LoRa、checkpoint 合併或傳統的參數轉接。此適配器在影片Transformer之前轉換原生H3條件,並將學習到的語意表示以可控強度融合回H3。佢嘅核心做法係將原本用於 SenseNova U1.5 嘅語意表示,透過跨架構遷移與蒸餾,壓縮成一個獨立嘅小型檔案(MiniMaxH3_SemanticBridge_v1.safetensors)。使用時 SenseNova 完全唔需要載入,適配器會喺視頻 transformer 之前轉換 H3 嘅原生 conditioning,再以可控強度將學到嘅語意信號混合返入 H3。檔案本身只有約 11 MB,並唔係 LoRA、權重合併或者傳統參數嫁接,安裝方法係將 MiniMax_H3_Semantic_Bridge_v1.0.zip 解壓至 ComfyUI 自訂節點目錄,再將適配器放入新增嘅 ComfyUI/models/semantic_bridge/ 資料夾即可。

目前 v1 只支援文字條件嘅標準 FL2VA 流程,Ref2VA 參考圖生成或參考音訊工作流並唔適用。官方亦提到,喺參考音訊場景插入呢個適配器時,唱歌同嘴型同步表現會明顯下降,因此使用前要留意任務邊界,避免硬套落唔支援嘅流程。呢個項目提供咗 examples/ 對照素材、workflow JSON 同研究文章,方便用家直接喺 ComfyUI 內做 Native H3 同 Semantic Bridge 嘅 A/B 比較。

重點摘要:

  • 基礎模型:MiniMaxAI/MiniMax-H3,定位係 H3 嘅 conditioning-space 適配器而非權重合併。
  • 檔案規模:約 11 MB 嘅獨立 .safetensors,外加 ComfyUI 自訂節點 zip 同 workflow JSON。
  • 訓練條件:單張 RTX 3090 Ti 24 GB 完成,無需多 GPU 叢集,SenseNova 只用於訓練階段。
  • 支援範圍:適用於 H3 FL2VA 文字生成視頻,Ref2VA 同參考音訊流程未獲支援。
  • 整合方式:放入 ComfyUI custom nodes,並透過新增節點將 conditioning 同 latent 注入原有 H3 流程。

項目主頁

Categories: 開源, ComfyUI, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Audio, MiniMax

Hojo TTS Light 輕量語音合成,4000 萬參數就做到 15 種聲線

Hojo-TTS-Light 僅約 0.08B 參數,以 ONNX 格式在 CPU 即時合成 24 kHz 語音,並預載 15 種聲線,免依賴 PyTorch。

Og image

想把文字轉語音(TTS)嵌入邊緣裝置或本地腳本,最大阻力往往來自 PyTorch 依賴肥大、GPU 門檻高。Hojo-TTS-Light 直接以 ONNX Runtime 執行,連 PyTorch 都不用安裝,對只有 CPU 或資源受限的環境相當友善。模型檔約 4000 萬參數(0.08B),輸出 24 kHz 音訊,並內建 15 種預設說話人聲線,開發者只需切換 embedding 即可換聲,省下自行收集語料或微調的工序。

隨倉提供的 infer.py 與 onnx_model.py 展示完整推理流程,搭配 requirements.txt 即可用幾行程式碼完成合成。對需要快速在本地或伺服器側加入語音回饋的項目而言,這種「開箱即播」的設計,比傳統 TTS pipeline 更貼近部署需求。

不過,15 種聲線屬於 preset 性質,若要新增自訂說話人,就需要額外準備參考音訊與對應 embedding,無法像大型 TTS 模型那樣靠一句話克隆。整體取向偏向「輕量、即用」,而非追求擬真度或表現力。

重點摘要:

  • 參數量約 0.08B,屬輕量級 TTS 模型
  • 採用 ONNX 格式,免安裝 PyTorch 即可在 CPU 環境執行
  • 預載 15 種 speaker-conditioned 聲線,可即時切換
  • 隨附 infer.py、onnx_model.py、requirements.txt,方便快速整合
  • 發佈平台為 Hugging Face,授權與權重可至該頁查閱

適合需要把語音合成嵌進邊緣裝置、CLI 工具或本地自動化流程的開發者;對追求高擬真或自訂聲線克隆的場景,則需要再評估擴充成本。

項目主頁

Categories: 開源, 文字轉語音, Agentic, Embedding, 模型, Audio, 語音, Skill 技能

Hojo-ASR-Multi-V1:廣東話語音識別引擎

基於 Qwen3-4B-Instruct-2507 微調而成的多語言語音辨識模型,覆蓋歐亞九種語言,嘈雜環境與口語修正都有對應訓練。

Og image

如果你聽過一段嘈雜環境裡帶口音嘅外語對話,想即時轉成文字,Hojo-ASR-Multi-V1 就係針對呢類場景設計嘅。它並非由零訓練嘅語音模型,而係喺 Qwen/Qwen3-4B-Instruct-2507 之上做微調,把語音編碼器接駁到大語言模型嘅解碼端,形成 Encoder-Adapter-LLM 嘅典型結構,再加入多幀聲學融合模組去保留細粒度嘅聲音特徵。訓練過程分階段進行並結合強化學習,所以喺噪音、非標準發音、講錯即改口呢類真實情境下都唔會輕易崩潰。

多語言覆蓋係佢最突出嘅賣點。官方公布支援德、法、西、葡、意、日、阿拉伯、韓、俄等九種主要語言,並加入咗普通話、英語、廣東話同四川話等方言支援。從公開評測結果睇,佢喺多個 CoVoST、MLS 同 FLEURS 基準上都錄得相當低嘅 WER,例如意大利 FLEURS 2.30、法語 MLS 2.95、德語 CoVoST 3.85,整體表現平穩。

喺使用層面,開發者可以透過 PyPI 上嘅 hojo-asr 套件快速部署,亦支援 Hugging Face Transformers 後端。HOJO_ASR.load_model 介面可以直接接收 wav 檔案路徑、scp 清單或原始音訊 bytes,配合 CUDA 設備做批次推論。授權用 Apache-2.0,並提供商業整合支援,方便團隊接入產品線。

由於佢建基於 Qwen3-4B 體量,運行門檻比傳統大型 ASR 親民得多,但仍然需要 GPU 推論以維持批次速度。

重點摘要:

  • 基礎模型:以 Qwen/Qwen3-4B-Instruct-2507 為骨幹,採用 Encoder-Adapter-LLM 架構
  • 語言覆蓋:歐亞九國主要語言,加普通話、英語、廣東話、四川話
  • 訓練方式:多階段模組化訓練結合強化學習,針對噪音同口語修正優化
  • 評測表現:CoVoST、MLS、FLEURS 多語言 WER 普遍處於 2–5 區間
  • 部署方式:pip install hojo-asr 後用 HOJO_ASR.load_model 載入,支援檔案路徑、scp 或 bytes 輸入

需要留意嘅係,頁面並未提供 GGUF 量化檔案或本地推論引擎資訊,目前主要以 transformers 後端配合 GPU 運行;如果你想喺純 CPU 或邊緣裝置上使用,就要留意後續會唔會補上量化版本。

項目主頁

Categories: 開源, 模型, Qwen, Audio, 庫, 語音, Dataset 數據集, 廣東話

ComfyUI-CGlide:MiniMax H3 短片創作者的自訂節點

這是一套給 ComfyUI 用的 MiniMax H3 影片生成自訂節點,把提示詞拼裝、即時預覽、寫檔與續接四步壓成四個節點,特別適合用 H3 拍短片的人。

Repository image for CGlide/ComfyUI-CGlide

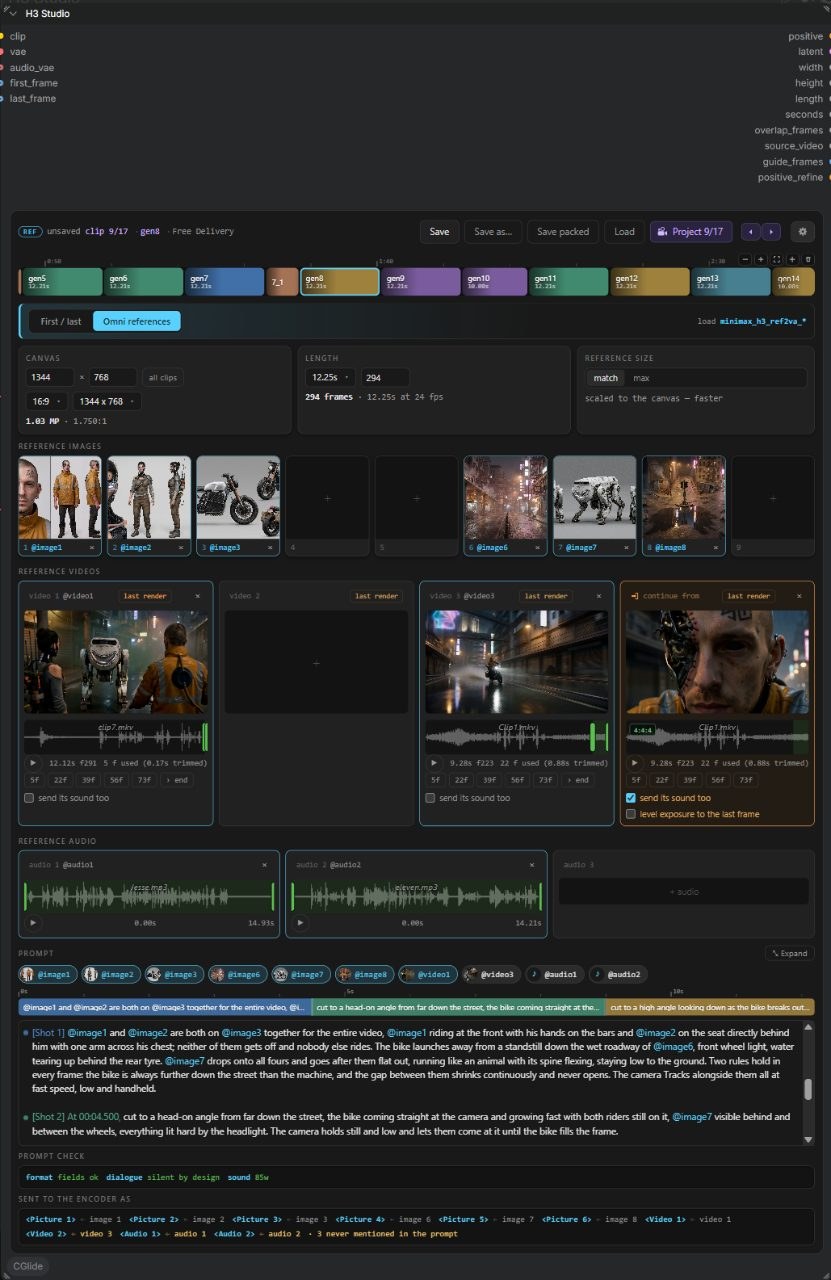
想做 H3 短片但不想在 ComfyUI 裡堆十幾個 loaders 同 text box 嘅人,可以留意 CGlide 嘅呢套自訂節點。佢將成個 H3 影片生成流程拆成四個節點:拼裝 prompt 同 conditioning、邊取樣邊預覽當下鏡頭、寫出影片檔,以及將續寫片段接返去原本嘅 clip。H3 Studio 更加將九張圖、三段影片、三段聲音同 prompt 全部塞入一個面板,但保留原本嘅 sampler 同步數,唔會插手推 sampling。

安裝好簡單,喺 ComfyUI Manager 搵 CGlide 或者 git clone 入 custom_nodes就得,不過官方提醒 ComfyUI 一定要更新,因為低 VRAM 嘅 w4a8 路徑要 0.31.0 或以上,否則會出黑畫面有聲冇畫,唔彈 error。模型要從 Comfy-Org 嘅 MiniMax H3 repo 拎,reference-to-video 或 first-last-frame checkpoint 入 diffusion_models,text encoder 入 text_encoders,影片同音訊 VAE 就擺去 vae。VRAM 唔夠嘅話可以用 Kijai 嘅 w4a8 版同 int8_convrot video VAE,大約 11.8 GB 就推到,原 workflow 唔使改。

H3 Studio: prompts, projects and clip extension for MiniMax H3

呢套節點嘅 chain 機制用 source_video 同 guide_frames 兩個輸出做接駁,比較啱做有連貫性嘅敘事短片,作者就用呢套工具完成咗 THE RECITATION。PyAV、torchaudio 同 ffmpeg 屬於依賴項目,PyAV 多數已經裝好,ffmpeg 放上 PATH 就夠,Glide Video 內部會 shell out 畀佢用。

對習慣 ComfyUI 節點工作流、又想用 H3 拍短片或敘事片段嘅創作者嚟講,呢套節點減少咗重複接線嘅時間,亦令低顯存方案更易落地。

重點摘要:
– 四節點設計:拼 prompt、即時預覽、寫檔、續接,分工清晰。
– H3 Studio 整合面板:九圖三影片三音訊同 prompt 集中管理,但唔干預 sampling。
– 低 VRAM 路徑:w4a8 加 int8_convrot VAE 約 11.8 GB,但要 ComfyUI 0.31.0 以上。
– chain 輸出:source_video 同 guide_frames 支援敘事鏡頭接駁。
– 作者實戰驗證:用同一套工具完成短片 THE RECITATION。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 多模態模型, Video, Audio, 提示詞, 工具, Content Creator, Clone, MiniMax

UI-Venus:多平台介面的高性能代理

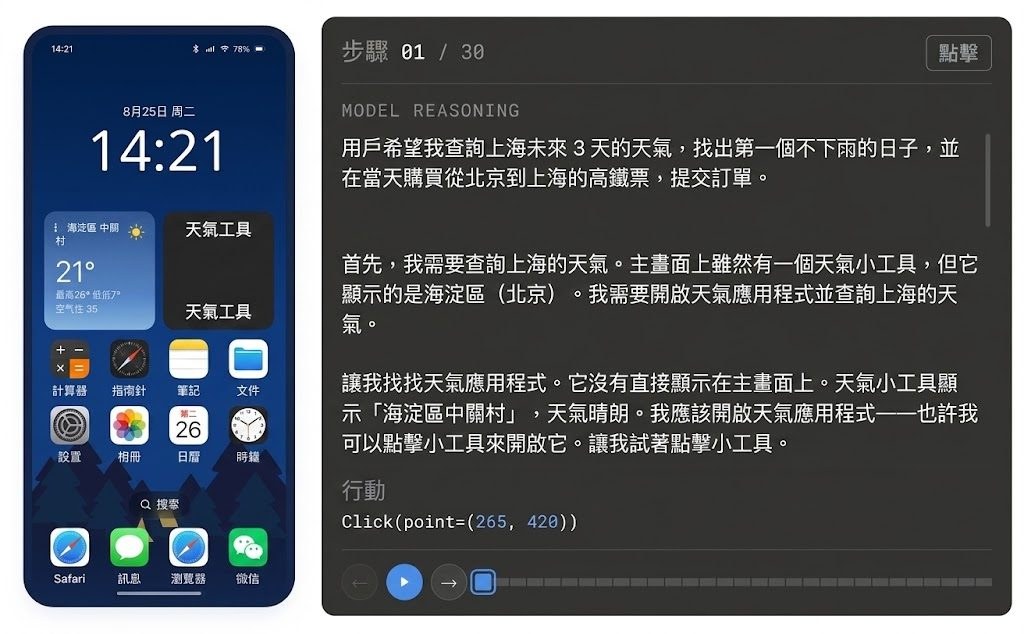
UI-Venus 是一個針對手機、桌面和網頁介面的 GUI agent,重點處理視覺定位與互動導航。它用 35 萬筆專業標註資料和 RFT 提升長流程操作與跨平台泛化。

UI-Venus Performance Across Datasets

UI-Venus 是一個 GUI agent,直接面向手機、桌面和網頁介面,目標是解決看得懂畫面、點得準位置、又能沿著多步驟流程完成任務這幾個卡位。它把 Reinforcement Fine-Tuning(RFT)放進訓練流程,令動作預測不只是識判斷,仲可以連住環境回饋去修正下一步。

項目提供 7B 同 72B 兩個 checkpoint,亦交代咗評估流程同推理腳本,方便按截圖、標註檔同模型路徑去做測試。不過原始資料未提供完整安裝細節同實際部署步驟,較合理的理解係先用它的推理與評估流程驗證在 ScreenSpot-Pro、OS-World-G、AndroidWorld 等基準上的行為。

它的賣點不只是識辨認介面元件,而係把 credit assignment 放到長鏈路任務入面處理,令代理在連續操作時較易對齊目標。官方聲稱它在 AndroidWorld、ScreenSpot-v2、UI-Vision 同相關跨平台基準有競爭力,對需要自動化操作、界面導航同複雜任務拆解嘅團隊會較有吸引力。

  • 針對 GUI 理解同 action prediction,覆蓋 mobile、desktop、web 三類場景
  • 以 350K 高質量、專業標註樣本訓練,並加入 RFT
  • 提供 7B 與 72B checkpoint,以及評估和推理腳本
  • 強調長流程任務的 credit assignment,適合多步驟互動工作
  • 基準表現覆蓋 AndroidWorld、ScreenSpot-Pro、OS-World-G 等項目

對要做介面代理、手機自動化、網頁操作或桌面工作流整合的團隊,UI-Venus 比較像一個可以直接拿去評估能力邊界的基礎模型。它的限制亦清楚:原始資料未交代完整安裝與落地流程,實際接入時仍要按你手上的環境、介面類型同任務難度再做驗證。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, UI/UX

Breeze TTS 2 即時語音生成

Breeze TTS 2 主打即時語音互動,兼顧聲線設計、聲線模仿與低延遲串流。它把自然語言指令和參考音訊結合起來,令語音生成更靈活。

Og image

Breeze TTS 2 屬於 text-to-speech(TTS)模型,核心目標是把即時語音互動做得更自然,並同時處理聲線模仿、聲線設計和語氣控制。它基於自然語言指令,既可以用參考音訊去保留聲線特徵,也可以不靠參考音訊直接設計聲音,這令使用場景比一般單一路徑的 TTS 更廣。

模型權重只限研究與非商業用途,而原始程式碼則採用 Apache 2.0,這表示權重與程式碼的授權條款並不相同。

Breeze TTS 2 支援 Voice Clone、Voice Design、Voice Direction,同時提供 Vocal Events,讓使用者可在文字中加入 (laugh)、(cough) 之類的表現指令。頁面亦強調它有 ultra-low-latency streaming,適合需要即時回應的對話式語音互動。

重點主要集中在功能和評測定位,沒有提供 GGUF 檔案、mmproj、量化版本、檔案大小,亦未提到 llama.cpp、Ollama 或 LM Studio。只見到它在 Artificial Analysis TTS leaderboard 排名第一,並聲稱表現超越部分閉源前沿系統;但由於頁面未展示完整測試細節,較適合把它視為一個以互動延遲、可控性和聲線表現力作賣點的語音模型。

  • 支援參考音訊模仿,也支援純文字描述生成新聲線
  • 可以用文字內嵌事件控制笑聲、咳嗽等表現細節
  • 主打低延遲串流,適合即時語音互動
  • 權重屬研究與非商業用途,授權限制要先看清
  • 頁面未提供量化、GGUF 或本地推論框架資訊

模型

Categories: 開源, 文字轉語音, 模型, 語音

ReFlowSET 影像翻譯模型,衛星影像新標準

ReFlowSET瞄準 SAR 影像難讀這個老問題,唔再沿用 latent diffusion model 的天花板。它用高保真 latent 空間配合 flow matching,換來更快取樣同更穩定畫質。

Repository image for KAIST-VICLab/ReFlowSET

落雨、夜晚甚至雲層遮擋時,Synthetic Aperture Radar(SAR)仍然影到地表,但訊號雜訊同幾何外觀都令判讀門檻偏高。ReFlowSET 屬於影像翻譯模型項目,處理的是 SAR-to-EO image translation:把 SAR 影像轉成較接近光學 Earth Observation(EO)影像的表達,方便人看,也方便接到後續視覺流程。

它沒有沿用常見的 latent diffusion model 微調路線,而是保留凍結的 FLUX.2 autoencoder,改用從零開始訓練的 conditional flow-matching transformer。這個選擇直接避開舊方法受限於原有 autoencoder 重建上限的問題,同時把生成放進較高保真的 latent space 內處理;代價是主體模型仍然相當大,DiT 達 509M 參數,訓練門檻不算低。

訓練時,模型會根據 SAR latent 去預測由隨機噪聲走向 EO latent 的線性 flow velocity,並加入 representation alignment,將中途特徵對齊到凍結的 DINOv3 ViT-L/16 teacher。呢個 teacher 同 REPA projector 只在訓練期間使用,推理時會移除,所以正式生成流程比訓練結構簡潔,亦解釋到它點樣兼顧語義對齊同推理效率。

項目在 QXS-SAROPT 與 SAR2Opt 上,團隊把十五種早前方法放到同一 protocol 同 evaluator 之下重訓比較,ReFlowSET 取得兩個資料集最佳 DISTS,並在 SAR2Opt 拿到最佳 FID 與 LPIPS。它亦提供四步取樣設定,速度約比五十步版本快 11 倍,較適合想測試 SAR 轉光學可視化、遙感分析前處理,或研究生成品質與延遲取捨的團隊。

  • 以 frozen FLUX.2 autoencoder 加 conditional flow-matching transformer 重建 SAR-to-EO 流程
  • 用 DINOv3 ViT-L/16 做 representation alignment,但 teacher 不會帶入推理
  • 在 QXS-SAROPT 與 SAR2Opt 拿到最佳 DISTS,SAR2Opt 亦有最佳 FID 與 LPIPS
  • 四步取樣版本大幅縮短生成時間,適合做速度與畫質折衷測試
  • 已公開 PyTorch 實作、論文預印本與預訓練模型,較適合研究型團隊直接驗證

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Image, Python, Dataset 數據集

CogEvol-4B 離線模型在手機筆電直接生成完整互動課程

CogEvol-4B 把一句課程大綱變成結構化投影片 JSON 加可獨立運行的互動 HTML,全程在筆電離線完成,無需 API 或雲端。

BF16 slide render

一般提到 AI 自動生成教材,多半還是要連雲端 API 才能輸出 HTML,但 CogEvol-4B 的做法是把整個流程壓進一個 2.4 GB 的 Q4_K_M GGUF 檔案。它以 Qwen3.5-4B 混合架構(48 層 GDN 線性注意力 + 16 層全注意力)為底,經過五萬多筆生產驗證樣本的 SFT,再做投影片 RL 與 HTML RL 兩階段強化,結果是單次前向傳遞就能同時吐出結構化投影片和自包含的互動式 HTML,不需要任何外部依賴。

在 MacBook Pro M2 Pro 16 GB 上,模型跑出約 33 tok/s 生成、470 tok/s prefill,整份互動課程約六分鐘完成。對教師、培訓設計師或自學者而言,這意味著斷網也能把一行大綱擴展成可互動的學習素材,不用排隊等雲端,亦沒有 API 成本。

項目可整合 OpenMAIC 與評測工具,權重放在 HuggingFace,並已整合到開源平台 OpenMAIC,透過 .env.local 切換本地 provider,再加上一個 runtime brief expander 補丁即可在斷網環境下渲染所有 widget。

重點摘要:

  • 離線可用:模型、應用、素材全部本地,關 WiFi 仍能完整跑
  • 極輕量部署:單一 2.4 GB GGUF 檔,Apple Silicon、CUDA、CPU 皆可
  • 一鍵生成:一句大綱直接變投影片 JSON 加可互動 HTML,無需 agent loop
  • OpenMAIC 原生整合:本地 provider 設定加上補丁,斷網渲染 widget
  • 雙重授權:程式碼 MIT、權重 Apache 2.0,可商用且易於二次開發

項目主頁 · GitHub • 模型

Categories: 開源, Agentic, 模型, Qwen

Page 26 of 59
1 … 24 25 26 27 28 … 59