RePlan 是一個基於指令的圖像編輯框架,專門解決指令-視覺複雜度(IV-Complexity)挑戰,透過視覺語言規劃器與擴散編輯器結合實現精準區域編輯。
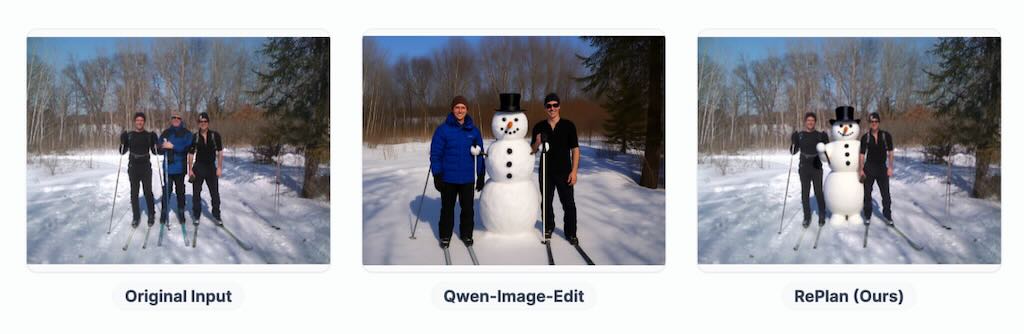
框架採用「規劃-執行」策略:VLM 規劃器透過逐步推理分解複雜指令,生成邊界框與區域提示;編輯器使用無訓練注意力區域注入機制,支援單次多區域並行編輯,避免迭代 inpainting。
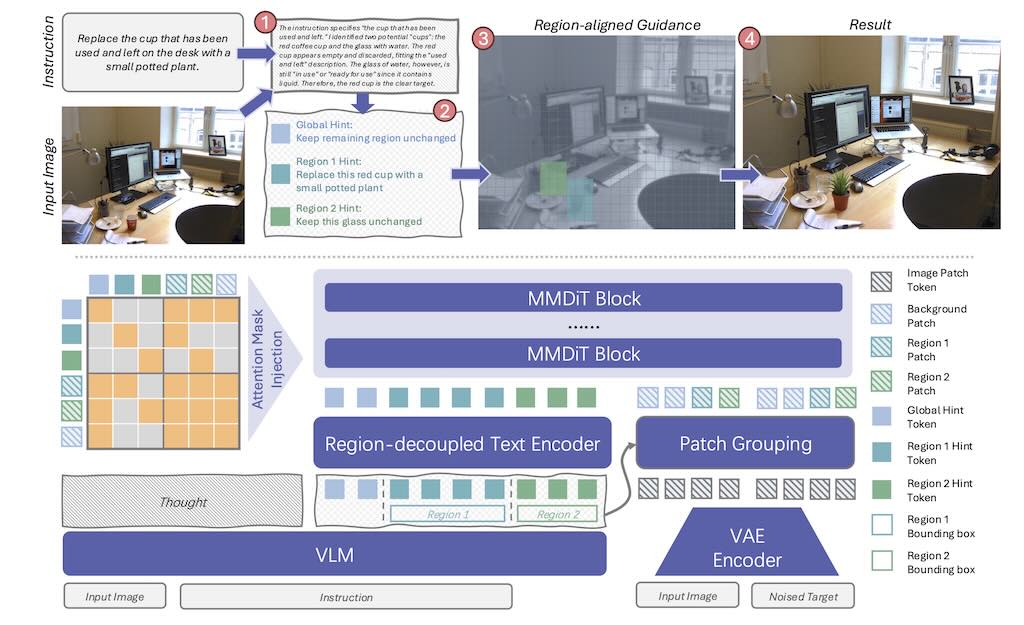
RePlan 是一個基於指令的圖像編輯框架,專門解決指令-視覺複雜度(IV-Complexity)挑戰,透過視覺語言規劃器與擴散編輯器結合實現精準區域編輯。 框架採用「規劃-執行」策略:VLM 規劃器透過逐步推理分解複雜指令,生成邊界框與區域提示;編輯器使用無訓練注意力區域注入機制,支援單次多區域並行編輯,避免迭代 inpainting。
RePlan 是一個基於指令的圖像編輯框架,專門解決指令-視覺複雜度(IV-Complexity)挑戰,透過視覺語言規劃器與擴散編輯器結合實現精準區域編輯。
框架採用「規劃-執行」策略:VLM 規劃器透過逐步推理分解複雜指令,生成邊界框與區域提示;編輯器使用無訓練注意力區域注入機制,支援單次多區域並行編輯,避免迭代 inpainting。
影片將一步步帶你上手 PersonaLive,教你如何使用 AI 即時角色變換,在直播或影片中實現即時變身效果,全流程免費。
影片將一步步帶你上手 PersonaLive,教你如何使用 AI 即時角色變換,在直播或影片中實現即時變身效果,全流程免費。

在本機用 ComfyUI 跑 Qwen Image Edit 2511,包含 BF16、FP8 和 GGUF 量化版本,以及 Lightning 4‑step LoRA 的完整實戰示範。
在本機用 ComfyUI 跑 Qwen Image Edit 2511,包含 BF16、FP8 和 GGUF 量化版本,以及 Lightning 4‑step LoRA 的完整實戰示範。

Apple 開源的 SHARP 能讓你輸入單張 2D 圖片,輸出場景的 3D Gaussian 表示(3DGS),可以之後用 3D Gaussian splatting 實時渲染不同視角。這個推論過程在標準 GPU 上小於一秒完成。 SHARP 能產生的 3D 表示是有公尺尺度的 metric representation,所以可以支援具物理意義的相機移動,而不是純視覺特效式的視差
Saber 由 Meta 開發,是一個「只用影片+文字資料就能做參考到影片生成」的零訓練框架,輸入幾張參考圖和一段文字,就能生出既長得像參考主體、又符合文字描述的影片。(訓練和推理程式碼整理完畢後將會發布,敬請期待。) 一般 R2V (Reference to video)要「參考圖+影片+文字」三元組,資料很難蒐集也不易擴充。Saber 完全不收這種三元組,只吃大規模「影片+文字」。 訓練時,它把同一支影片中的某些幀「當成參考圖」,再加上遮罩,讓模型自己學會:怎麼在生成影片時保持主角長相一致、又能跟文字對齊。 技術做法(直覺理解)遮罩訓練:從影片抽幀,套上各種形狀與面積比例的二值遮罩,當作「動態參考圖庫」,讓模型看到超多種類的參考條件。 遮罩增強:對圖和遮罩一起做旋轉、縮放、平移、翻轉等變形,打亂空間對齊,避免模型學到「直接把參考貼上去」的作弊路線。 模型與注意力設計影片與參考圖先丟進 VAE 變成 latent,然後在時間維度把「影片 latent」和「參考 latent」串起來,一起丟進 Transformer 做擴散。參考 latent 不加噪音,保持條件乾淨。 自注意力裡用「注意力遮罩」限制:影片 token 可以互相看、也能看參考,但參考 token 只能看自己有效的前景區域,避免注意到背景干擾。 推論流程與能力推論時,會先用預訓練分割器(例如 BiRefNet)把參考圖的人或物分出來;如果想要用整張背景當條件,就不做分割而用全 1 遮罩。 Saber 可以吃多張參考,支援多視角同一主體,也能多主體;在 OpenS2V-Eval 基準上,主體一致性與整體品質都比 Phantom、VACE、Kling1.6 等專門 R2V 模型更好。 限制與展望當參考圖過多(例如 12 張)時,模型有機會「崩壞」,把不同參考碎片硬湊在同一畫面,語義整合不足。 目前重心在身份保留與視覺自然度,對非常細緻的動作控制或複雜時序一致性仍不完美,未來方向包括更聰明地整合大量參考及更可控的動作與真實感。 官方 GitHub 儲存庫為 https://github.com/franciszzj/Saber,提供模型細節與訓練資訊。 論文《Scaling Zero-Shot Reference-to-Video Generation》發布於 arXiv (2512.06905)。
Saber 由 Meta 開發,是一個「只用影片+文字資料就能做參考到影片生成」的零訓練框架,輸入幾張參考圖和一段文字,就能生出既長得像參考主體、又符合文字描述的影片。(訓練和推理程式碼整理完畢後將會發布,敬請期待。)
一般 R2V (Reference to video)要「參考圖+影片+文字」三元組,資料很難蒐集也不易擴充。Saber 完全不收這種三元組,只吃大規模「影片+文字」。
訓練時,它把同一支影片中的某些幀「當成參考圖」,再加上遮罩,讓模型自己學會:怎麼在生成影片時保持主角長相一致、又能跟文字對齊。
技術做法(直覺理解)
遮罩訓練:從影片抽幀,套上各種形狀與面積比例的二值遮罩,當作「動態參考圖庫」,讓模型看到超多種類的參考條件。
遮罩增強:對圖和遮罩一起做旋轉、縮放、平移、翻轉等變形,打亂空間對齊,避免模型學到「直接把參考貼上去」的作弊路線。
模型與注意力設計
影片與參考圖先丟進 VAE 變成 latent,然後在時間維度把「影片 latent」和「參考 latent」串起來,一起丟進 Transformer 做擴散。參考 latent 不加噪音,保持條件乾淨。
自注意力裡用「注意力遮罩」限制:影片 token 可以互相看、也能看參考,但參考 token 只能看自己有效的前景區域,避免注意到背景干擾。
推論流程與能力
推論時,會先用預訓練分割器(例如 BiRefNet)把參考圖的人或物分出來;如果想要用整張背景當條件,就不做分割而用全 1 遮罩。
Saber 可以吃多張參考,支援多視角同一主體,也能多主體;在 OpenS2V-Eval 基準上,主體一致性與整體品質都比 Phantom、VACE、Kling1.6 等專門 R2V 模型更好。
限制與展望
當參考圖過多(例如 12 張)時,模型有機會「崩壞」,把不同參考碎片硬湊在同一畫面,語義整合不足。
目前重心在身份保留與視覺自然度,對非常細緻的動作控制或複雜時序一致性仍不完美,未來方向包括更聰明地整合大量參考及更可控的動作與真實感。
官方 GitHub 儲存庫為 https://github.com/franciszzj/Saber,提供模型細節與訓練資訊。 論文《Scaling Zero-Shot Reference-to-Video Generation》發布於 arXiv (2512.06905)。
現實世界的視訊敘事往往由多個鏡頭組成——這些鏡頭表面上不連續,但在語義上彼此關聯,共同構成完整且連貫的故事。然而,現有的多鏡頭視訊生成(Multi-Shot Video Generation, MSV)方法難以有效捕捉長距離的跨鏡頭語意關聯,主要因其依賴有限的時間窗口或單關鍵影格條件,導致在複雜敘事場景中表現受限。 為此,Meta 提出 OneStory,一種可同時建模全局語義與緊湊上下文的多鏡頭生成方法,實現一致且可擴展的長篇敘事生成。OneStory 將 MSV 問題重新定義為「下一鏡頭生成」任務,基於預訓練的影像轉影片(Image-to-Video, I2V)模型進行強視覺條件化,並透過自回歸方式生成鏡頭序列。
現實世界的視訊敘事往往由多個鏡頭組成——這些鏡頭表面上不連續,但在語義上彼此關聯,共同構成完整且連貫的故事。然而,現有的多鏡頭視訊生成(Multi-Shot Video Generation, MSV)方法難以有效捕捉長距離的跨鏡頭語意關聯,主要因其依賴有限的時間窗口或單關鍵影格條件,導致在複雜敘事場景中表現受限。
為此,Meta 提出 OneStory,一種可同時建模全局語義與緊湊上下文的多鏡頭生成方法,實現一致且可擴展的長篇敘事生成。OneStory 將 MSV 問題重新定義為「下一鏡頭生成」任務,基於預訓練的影像轉影片(Image-to-Video, I2V)模型進行強視覺條件化,並透過自回歸方式生成鏡頭序列。
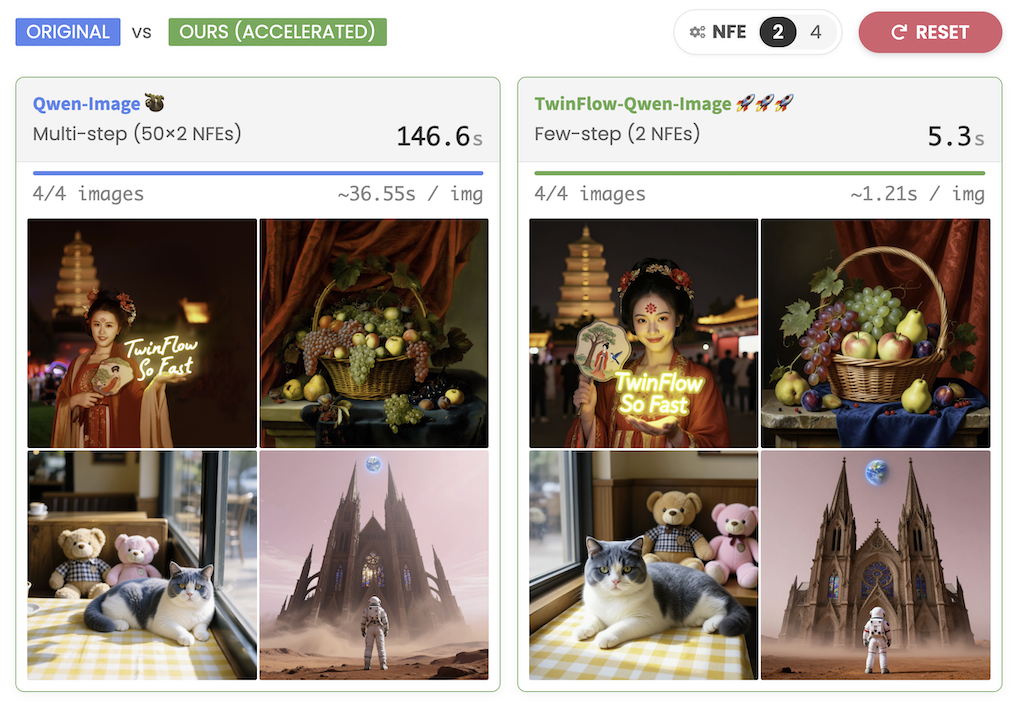
TwinFlow 利用自對抗流實現大型模型的一步生成框架,是一個能夠實現高品質單步和少步生成而不會造成管道臃腫的框架。 值得注意一般大型多模態模型為了取得了驚人的生成能力,代價十分高昂:因為推理效率低。標準的擴散模型和流動匹配模型通常需要50-100 次非特徵提取 (NFE)才能產生一幅影像。
TwinFlow 利用自對抗流實現大型模型的一步生成框架,是一個能夠實現高品質單步和少步生成而不會造成管道臃腫的框架。
值得注意一般大型多模態模型為了取得了驚人的生成能力,代價十分高昂:因為推理效率低。標準的擴散模型和流動匹配模型通常需要50-100 次非特徵提取 (NFE)才能產生一幅影像。
華為 Bayer Lab 在 Hugging Face 上發布的 WindowSeat (開源)應用,採用 Alibaba 的 Qwen-Image-Edit 2509 模型,主要用於移除單張圖像中的窗戶反射。 WindowSeat 自動產生無反射的乾淨版本,專門針對窗戶、飛機、商場或辦公室玻璃反射設計。 它基於擴散轉換器(DiT)框架,透過單步潛在擴散實現端到端反射移除。
華為 Bayer Lab 在 Hugging Face 上發布的 WindowSeat (開源)應用,採用 Alibaba 的 Qwen-Image-Edit 2509 模型,主要用於移除單張圖像中的窗戶反射。
WindowSeat 自動產生無反射的乾淨版本,專門針對窗戶、飛機、商場或辦公室玻璃反射設計。 它基於擴散轉換器(DiT)框架,透過單步潛在擴散實現端到端反射移除。
https://www.youtube.com/watch?v=1D_j8rNlGK8 LongCat-Image-Edit 模型 這個模型主打中英雙語精準編輯、保持未編輯區域的一致性(構圖、材質、色調、人臉一致)


