BadWAM 直指 World-Action Models 盲點

BadWAM唔係做更強控制,而係專門測試 World-Action Models 會點樣「想得啱、做錯事」。對研究機械人安全同對抗攻擊的人來說,呢類偏移比一般失敗更值得警惕。

Repository image for LiQiiiii/BadWAM

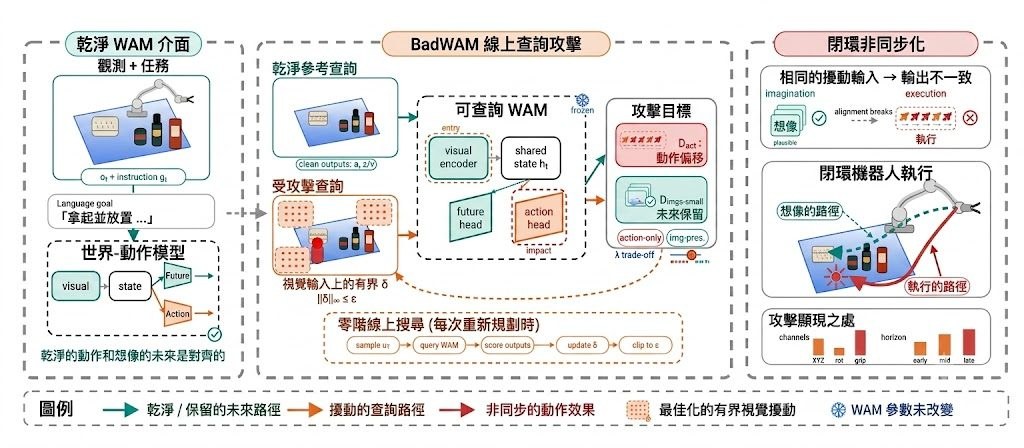
當一個 World-Action Models(WAMs)睇落仍然能夠預測合理未來,但實際控制已經被悄悄帶偏,問題就唔再只是準確率高低。BadWAM 屬於研究型安全測試框架,集中模擬 World-Action Drift Attacks,用細微視覺擾動去拆開「想像」同「行動」之間原本應該對齊的部分。

呢個項目的價值,在於它唔係單純證明模型會失手,而係指出一種更難察覺的失效方式:未來預測仍然似樣,行動卻已經朝向任務失敗。相比一般只睇輸出有冇偏移的對抗攻擊做法,BadWAM更貼近 WAM 的結構特性,分成 Action-only Adversarial Attack 同 Imagination-preserving Adversarial Attack 兩條路線,後者尤其針對「表面正常、實際出錯」的情況。

重點可先睇幾項:
– 支援 query-based 攻擊,重點在凍結的 WAM 上做線上搜尋
– 提供 LIBERO closed-loop attack evaluation,唔只停留在單步分析
– 包含 matched-strength stealth analysis 同 ablation experiments
– 內附 statistics export 與 plotting utilities,方便整理結果

從部署角度看,儲存庫提供的是研究代碼而唔係開箱即用套件,基礎環境指向 Python 3.10+,並建基於 FastWAM。README 亦講明未附 model checkpoints、LIBERO data、dataset statistics、RoboTwin assets 同實驗輸出,所以要重現結果,仍然要自行補齊相關資源與依賴。

現有公開結果已經說明這個框架唔只係概念展示。在 LIBERO closed-loop 測試中,action-only WAM 成功率由 96.5% 跌到 43.1%,joint WAM 亦由 98.1% 跌到 61.5%。受益最大的會係做機械人控制、WAM 安全、對抗魯棒性測試的研究團隊;對一般應用開發者來說,它未必直接幫你部署產品,但很適合作為檢查模型是否「睇落可靠、其實已偏航」的驗證工具。
項目主頁 · GitHub

Categories: 開源, 香港理工大學, 世界模型, 框架, 香港, Python, 安全, Dataset 數據集

Ring-Zero 1T 參數零樣本強化學習

唔靠人工標註推理步驟,模型一樣可以練出更成熟的思考方式。Ring-Zero 想解的,正是大模型推理愈大愈難教、愈難穩定訓練的問題。

Og image

當模型愈做愈大,真正困難唔只係算力,而係點樣令佢喺冇人工示範推理鏈嘅情況下,仍然學到清晰、有效又可延伸嘅思考方式。Ring-Zero 屬於大型語言模型推理訓練研究,重點放喺將 zero RL 擴展到 1T 參數,觀察推理能力會唔會隨規模自然湧現。

呢個項目要處理嘅問題幾具體:以 Reinforcement Learning with Verifiable Rewards(RLVR)直接訓練 base model,雖然可以避開昂貴嘅人工 chain-of-thought(CoT)資料,但簡單放大規模會帶來可讀性差、token 冗餘,同埋推理深度唔夠靈活。Ring-Zero 針對呢幾個卡位,加入 clipped importance sampling、training-inference ratio correction 同 mixed-precision control,目標係令訓練流程更穩定,輸出亦更精煉。

同常見依賴監督式推理示範或者較細模型做 zero RL 嘅做法相比,Ring-Zero 想證明一件事:規模本身會改變模型學推理嘅方式。研究者觀察到訓練大致會經歷「discovery」再到「sharpening」兩個階段,而且模型會自發出現 anthropomorphism、structured formatting、self-verification、parallel reasoning 同 context anxiety 等行為,顯示部分人手設計技巧未必再係必要。

  • 把 zero RL 擴展到 1T 參數,核心焦點係大規模推理湧現
  • 唔用人工標註 CoT,改用 RLVR 從 trial-and-error 中學習
  • 除咗最終答案,仲額外檢查 comprehensibility、reproducibility、efficiency
  • 在七個數學 benchmark 上,Ring-2.5-1T-Zero 表現具競爭力

對研究 LLM 推理、模型訓練同 scaling law 嘅讀者,呢個項目最有參考價值。佢唔單止關心分數高低,仲嘗試回答大模型點樣學會更短、更有結構、亦更容易重現嘅 CoT;呢一點對之後做 AGI、模型訓練同推理優化都幾關鍵。

Youtube · Paper

Categories: 清華大學, 模型訓練, 安全, AGI, 中國, Dataset 數據集

GitHub 規則集新增審核撤銷權限控制

團隊而家可以直接限制邊啲人有權撤銷 pull request 審核。對需要嚴格合併流程嘅項目,呢個更新可減少誤操作同權限過闊帶來嘅風險。

Og image

當團隊依賴 pull request 審核去把關程式碼質素時,最怕唔係冇人批核,而係批核已經完成後,任何唔合適嘅人都可以把審核撤銷。GitHub 今次更新屬於 repository rulesets 功能強化,處理嘅正正係合併前權限邊界唔夠細緻呢個問題。

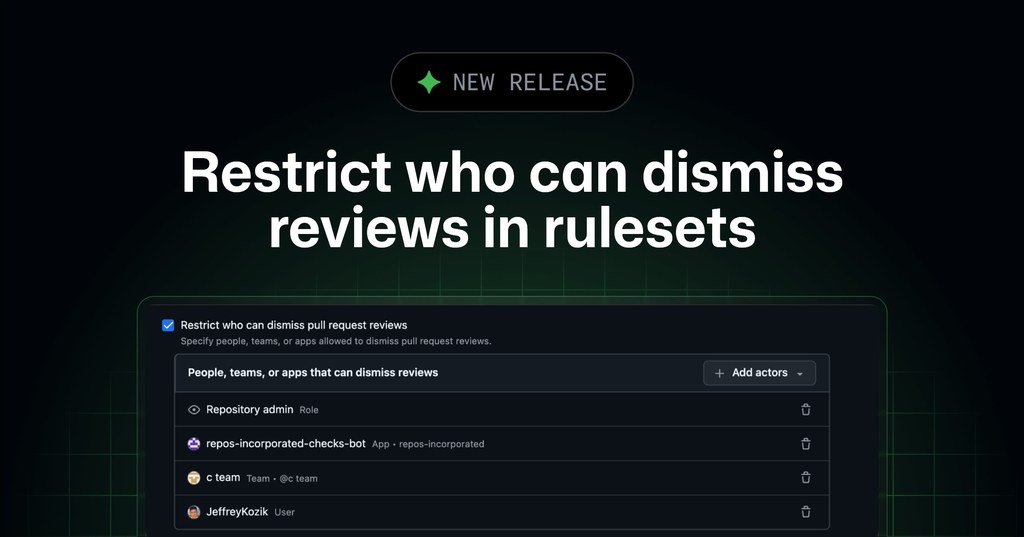
新設定放入 Require a pull request before merging 規則之中,管理者可以直接指定邊啲 users、teams 同 apps 能夠 dismiss reviews。對比以往較寬鬆或者分散嘅管控方式,呢種做法將審核撤銷權限收返去規則集內統一管理,分支保護流程會更清晰。

重點整理:
– 可限制特定 users、teams、apps 撤銷 pull request reviews
– 設定位置已整合到 repository rulesets 既有審核規則內
– 可透過 UI、REST API 同 GraphQL 配置
– 功能已經 generally available,適用於 github.com 上嘅 repository rulesets

呢個更新最適合有多人協作、需要明確審批責任,或者要配合內部治理要求嘅開發團隊。Rulesets 本身已經係 GitHub 建議用來保護 branches 嘅方式,而家再加上審核撤銷限制,等項目喺合併前多一層可追蹤、可控嘅流程保護。

使用上做法唔複雜,只要打開 repository-level ruleset,啟用 Require a pull request before merging,再選擇 Restrict who can dismiss reviews 就可以。呢類更新唔係花巧功能,而係直接改善日常協作入面最常見嘅權限管理細節。

項目主頁

Categories: 開源, 微軟, API, 教學, 軟件, 安全

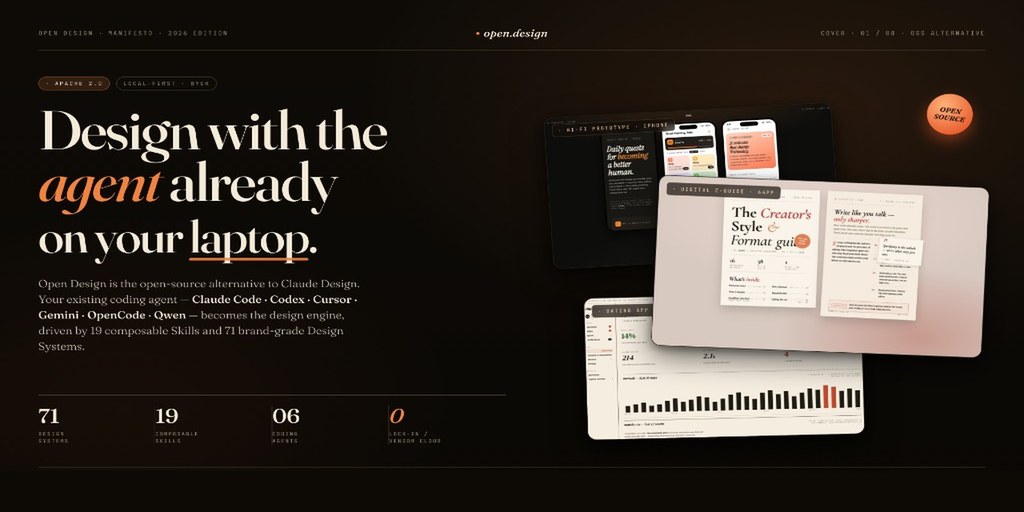
open-design:本地優先的開源設計工具

open-design 是一款本地優先的桌面應用,讓 AI 編碼代理直接生成設計稿、頁面與多媒體內容。

Og image

open-design 是一款本地優先(local-first)的開源桌面應用程式,主打讓 AI 編碼代理(coding agent)直接充當設計引擎,協助用戶快速產出原型設計(prototypes)、登陸頁面(landing pages)、儀表板(dashboards)、投影片、圖片甚至影片等各種多媒體素材,並輸出真實可用的檔案。這個項目的定位是 Claude Design 的開源替代方案,強調在桌面環境中本地執行,無需依賴雲端服務即可完成設計工作。

與傳統的設計工具相比,open-design 的最大差異在於將 AI 編碼代理作為核心驅動力,用戶可以透過自然語言指令讓代理直接生成設計內容,省去手動拖拽元件的繁瑣流程。從 GitHub 上的數據可見,該項目已獲得超過 7.5 萬顆星及 8 千多次 fork,社群關注度相當高,顯示開源社群對本地化 AI 設計工具的強烈需求。

這個項目最適合需要快速產出網頁原型或行銷素材的開發者、設計師及內容創作者。對於重視資料隱私、希望在本地環境完成設計工作的人來說,local-first 的架構尤為吸引。開發者亦可將其整合到現有的編碼工作流中,讓 AI 代理同時負責程式碼與設計兩個層面。

以下是這個項目的重點摘要:

  • 屬於本地優先的開源桌面應用,定位為 Claude Design 的替代方案
  • 核心功能是讓 AI 編碼代理生成設計稿、頁面、儀表板及多媒體內容
  • 強調本地執行,無需依賴雲端服務,保障資料私隱
  • 適用於開發者、設計師及內容創作者快速產出原型與行銷素材
  • 社群關注度高,GitHub 上已累積超過 7.5 萬顆星

由於該項目仍處於活躍開發階段,功能成熟度與跨平台支援等細節尚未完全明朗,建議有興趣的使用者持續關注其更新進度。

項目主頁

以下是該網頁主要內容(麻省理工學院電子工程與計算機科學系 MIT EECS 的訪談文章)的繁體中文翻譯:

(more…)
Categories: 開源, Agentic, MCP, Vibe Coding, 編程, 安全, Skill 技能


拆解 AI Agent Loop 核心運作

用最簡單控制流程,講清 AI Agent 點樣反覆調用模型與工具。

Og image

這是一段介紹 AI Agent 底層控制流程的教學影片。它主要用來解釋主流 Agent 為何能連續思考、調用工具並完成任務,核心其實是一個簡化版 while 迴圈。

內容重點不是堆砌框架名詞,而是把 Agent Loop 拆成幾個基本步驟:先問模型、按模型要求執行工具、把結果回填,再繼續詢問模型,直到模型不再要求工具。這種講法有助非技術讀者理解,很多看似複雜的 AI Agent,底層控制流未必複雜。

它要處理的問題,是怎樣讓語言模型由一次性回答,變成可逐步執行任務的系統。相比只靠單輪提示詞的做法,Agent Loop 多了狀態延續、工具調用與停止條件,因此更適合查資料、操作 API、分步完成工作等情境。

  • 核心概念:Agent Loop 可視為模型與工具之間的反覆回合
  • 主要流程:模型決定下一步,系統執行工具,再把結果交回模型
  • 關鍵價值:把複雜 Agent 拆成可理解、可實作的最小控制單位
  • 適用情境:想學 AI Agent、工具調用、任務自動化流程的人最受用

這類內容特別適合剛接觸 Agentic 系統、MCP、工具代理或自動化工作流的讀者,也適合寫程式的人建立正確心智模型。單靠目前提供的資料,未見具體效能數字、基準測試或完整程式實作細節,因此較適合視為概念導讀,而不是完整技術文件。

項目主頁

Categories: Agentic, MCP, Google, API, 框架, 安全

AnyGroundBench 點出影片定位模型盲點

AnyGroundBench不是新模型,而是專門測試影片理解能力的 benchmark。它把專業場景放入同一套規則,直接揭示現有 VLMs 的適應落差。

Repository image for rinost081/AnyGroundBench

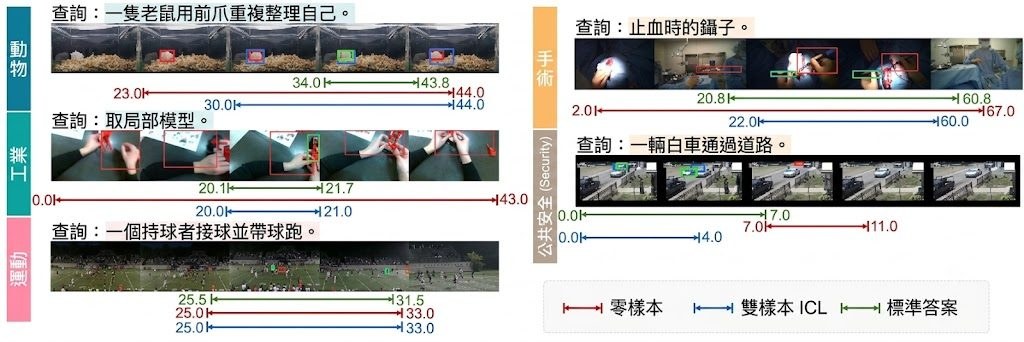
AnyGroundBench 是一個影片 grounding benchmark,也是面向專業領域的資料集與評測基準。它主要用來測試 Vision-Language Models(VLMs)在 animal、industry、sports、surgery、public security 幾類場景中,能否把文字描述準確對應到影片中的時間、位置,以及時空同時發生的事件。

現有做法多數停留在 general、daily-life benchmark 的 zero-shot 測試,重點是看模型有沒有通用理解力;作者認為這種範式無法反映專門場景,因為稀有視覺概念、複雜動作關係與領域術語,通常不會在通用資料裡被充分學到。AnyGroundBench 因而把評測重心轉去 domain adaptation,並加入 dedicated training subsets,令測試不再只問模型「有沒有見過」,而是進一步量度它「能不能適應新領域」。

這個項目的差異,在於它把 temporal、spatial、spatio-temporal annotations 用統一方式整理,並混合 newly captured videos 與 existing datasets。資料來源涵蓋 mouse、american_football、Animal-Kingdom、MECCANO、EgoSurgery 等,覆蓋面比單一領域 benchmark 廣,亦更接近研究團隊、產業分析、醫療影像研究與安全監測場景會遇到的資料分佈。

項目提供 Hugging Face dataset、project page:這不是即插即用應用程式,而是供研究與模型比較的 benchmark。部署重點不是介面安裝,而是按 domain 讀取整理後的資料,然後以 STVG、TVG、SVG 三類任務跑推理與評分;指標分別用 vIoU@0.3、tIoU@0.3、sIoU@0.3。

  • 類型屬於 benchmark / 資料集,目的是測量 VLMs 的 specialized-domain video grounding 能力
  • 舊範式以 zero-shot general benchmark 為主,新設計改為檢查 domain adaptation 與 In-Context Learning(ICL)是否真的有效
  • 評測涵蓋 temporal、spatial、spatio-temporal 三層,較容易看出模型究竟是看錯時間、找錯位置,還是兩邊都失準
  • 已評測 15 個 state-of-the-art VLMs,結果指出現有模型在 specialized domains 的 zero-shot 與 ICL 表現都不穩定

建議模型包括 GPT-4o、GPT-5.1、Gemini-2.5-Flash 等 proprietary VLMs;現有結果顯示,加入 2-shot ICL 雖然在部分 domain 有改善,但整體仍未解決 specialized-domain spatio-temporal reasoning 的缺口。對研究 VLM evaluation、video grounding、視覺模型遷移能力的團隊來說,這個項目最有價值的地方,是它把「通用測試看似可用」與「專業場景仍然失手」之間的差距量化出來。

項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, OpenAI, Gemini, Video, 安全, Dataset 數據集

微軟用殘差強化學習補強機械人 VLA

這是一個提升機械人操控穩定性的研究方法。它用模擬訓練的殘差策略,零樣本補強真實世界的 VLA 表現。

Og image

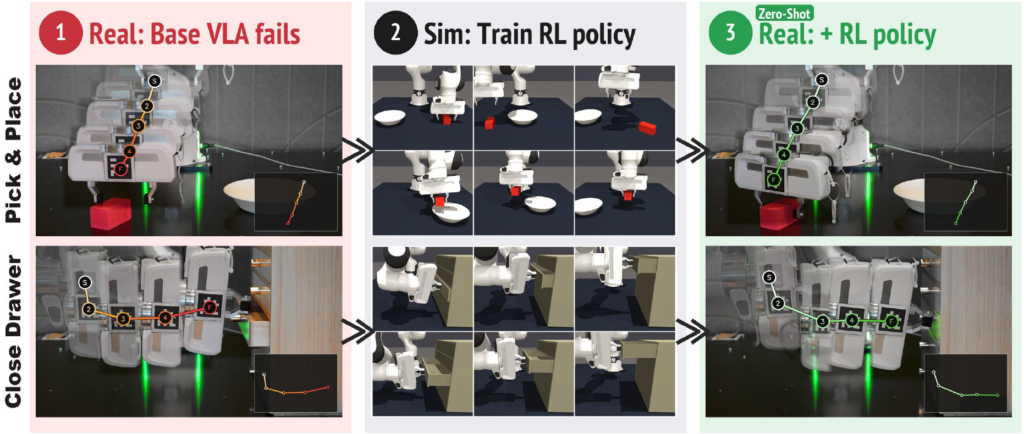
這是 Microsoft Research 的 Object-Centric Residual RL 方法。它的用途是為 Vision-Language-Action(VLA) 模型加入一層修正策略,減少機械人在真實操控中因細小誤差累積而失手的情況。

核心做法是把一個已凍結的 base VLA 保留不變,再額外疊加一個輕量 residual policy。這個 residual policy 完全在模擬環境訓練,輸入不是原始影像,而是 object-centric state、proprioception,以及 base VLA action,藉此避開常見的 visual sim-to-real gap,令策略可直接 zero-shot 轉移到真實機械人。

這個方法處理的是 imitation learning 常見的脆弱性:示範資料未覆蓋到的狀態一旦出現,誤差會一路放大。與直接微調 VLA、或在真實世界再做 reinforcement learning 相比,這個方法的差異在於只學「修正量」,而且訓練放在模擬中完成,成本與風險都較低。

  • 保留 frozen base VLA,不用重訓整個模型
  • residual policy 以物件中心狀態為主,減少依賴影像對齊
  • 目標是 zero-shot sim-to-real enhancement
  • 適合需要精準抓取、放置或接觸操作的機械人工作流

這類方法較適合關注 VLARobotic 與 sim-to-real transfer 的研究者和開發者。現有資料清楚交代方法方向與問題設定,但未提供完整安裝流程或操作步驟;評估部分可確認作者以真實機械人成功率改善作為重點,更多數值細節仍需參考原始論文。

項目主頁 · Paper

Categories: Agentic, AI productions, 視覺模型, 多模態模型, 微軟, Image, VLA, Robotic, 框架, 編程, 安全

MMBench2 點樣預測 World Model 幻覺

MMBench2唔只係資料集,亦連同模型、評測同互動介面一齊公開。重點在於預測同減少 World Models 出現 hallucination。

walker run

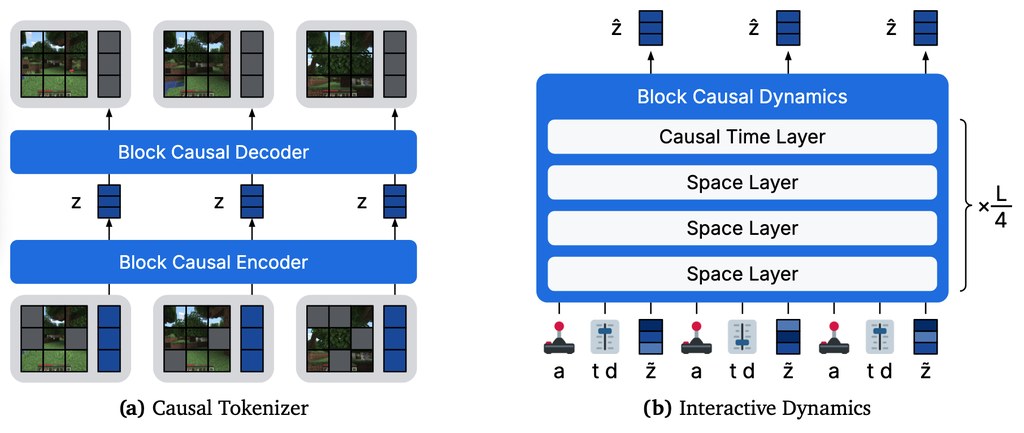
MMBench2 是一個圍繞 large generative world models 的研究型基準與開源項目,結合資料集、模型、訓練與評測程式。它主要處理 World Models 在生成未來軌跡時出現 hallucination 的問題,也就是畫面看似合理,但已經偏離真實動態與動作條件。

現有做法多數集中在把 world model 做得更大,或沿用固定的 open-loop rollout 範式觀察生成效果;作者認為這樣很難直接找出模型何時開始失真。這個項目改以「可預測、可預防」為核心,提出三種 runtime hallucination predictors:tokenizer round-trip residual、flow instability、inter-seed denoising variance,並配合 motion-normalized 版本做即時監測。

模型設計大致跟隨 Dreamer 4 路線,但重點不只在架構本身,而是把 coverage-aware training 與 targeted data collection 放入同一套流程。作者把 hallucination 視為 data coverage 問題,因此會重抽樣 under-represented 的 state-action space,亦會用 predictors 當 curiosity reward 做 closed-loop online data collection,這比單純加大模型更有方向性。

部署理解上,這個項目已提供互動式網頁介面,可在 CUDA GPU 上直接啟動,並用 live simulators 種出 rollout,連完整資料集都唔一定要先下載。官方亦公開 350M-parameter pretrained 與 finetuned world models,以及 427 小時、涵蓋 210 個 continuous control tasks、10 個 domain 的 MMBench2 dataset,方便研究團隊重做訓練、比較不同變體,或者先用 checkpoint 檢查 hallucination predictor 的表現。

  • 項目性質:研究型 benchmark 加工具鏈,不只是單一模型
  • 核心差異:把 hallucination 當成 coverage 問題,而非單靠更大模型硬推
  • 可測內容:即時 predictor 疊圖、不同模型變體、互動 rollout 對照
  • 相關模型:base、coverage_aware、combined 三類變體,以及 350M-parameter world models
  • 適合情境:world modeling、planning、policy learning、模型安全檢查

這個項目較適合研究 world models、Robotic 控制、模型可靠性與安全的團隊閱讀和試驗。它未必是一般開發者即裝即用的應用工具,但作為 benchmark、分析框架與資料基礎設施,辨識 hallucination 成因與改善方向都相當清楚。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 世界模型, 模型訓練, Robotic, 框架, 安全, Dataset 數據集

ReMMDBench-Agent 驗證多模態假資訊

這是一組重現論文結果的研究代碼,集中比較三種多模態 misinformation detection agent 系統。重點不只看分數,亦看證據如何被拆解、檢索與重用。

Repository image for DANG-ai/ReMMDBench-Agent

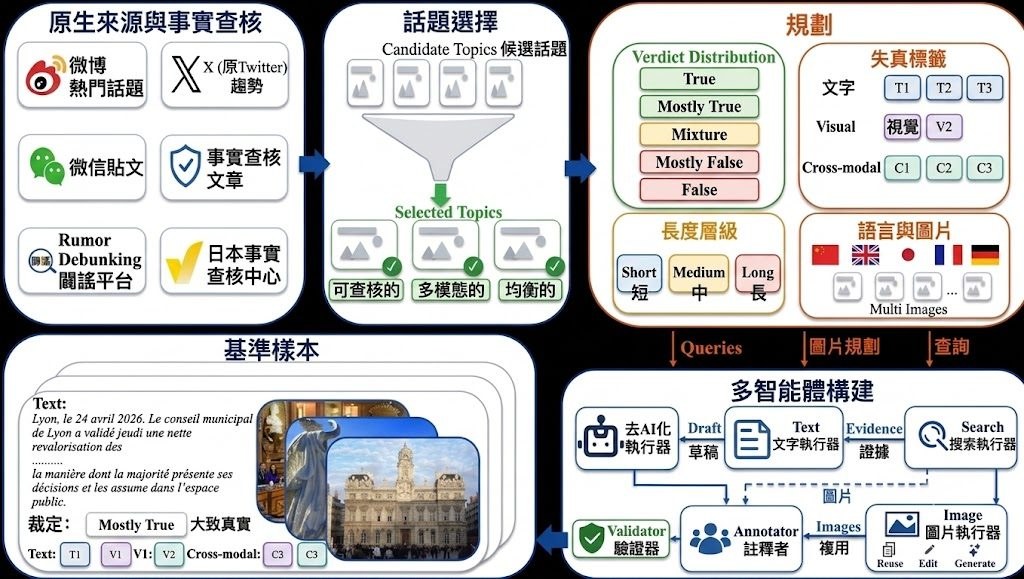
開發團隊來自上海交通大學、上海人工智慧實驗室、清華大學、中南大學,以及中國電子科技集團第十五研究所,核心作者把 ReMMDBench 同 ReMMD-Agent 一起公開,方向很明確:用較接近真實網絡帖文的方式,檢查圖文混合內容中的 misinformation。這個 GitHub 項目屬於研究原型加評測代碼集合,主要用來重現三個 multimodal misinformation detection agent 系統在 ReMMDBench 上的結果,並比較它們怎樣做判斷。

現有做法常把多模態假資訊檢測收窄成單圖、二分類,或者一次過把整段文字與圖片丟給模型判斷;作者認為這種 fixed-pass 判斷方式難以處理長敘事、多張圖片、跨語言與部分真實內容。這個項目因此提出一套以 ReMMDBench 為核心的 agentic 驗證路線:Baseline 1 是 3-stage MMD-Agent,Baseline 2 是 MCTS-based 5-verdict + 8-taxonomy agent,而主系統 ReMMD-Agent 則用 atomic decomposition、RAG(Retrieval-Augmented Generation)與 multi-expert judge,把結論建立在可追蹤的證據狀態上。

跟同類方法相比,ReMMD-Agent 的取向不是只追求一次答中,而是先把帖文拆成 atomic claims、image observations、text-image bindings,再檢索 multimodal evidence,之後重用 persistent memory,減少重複工具呼叫。這種設計的取捨很清楚:流程更長、配置更多,但換來較好的可解釋性,也更適合處理 five-way L1 veracity labels、8 個 L2 distortion labels,以及 multilingual multi-image 場景。

安裝與測試思路也相當具體。三個子項目各自有 requirements.txt、設定檔與啟動腳本;要先把資料根目錄指向 ReMMDBench,再在 .yaml.env 內填入模型端點與金鑰佔位內容,之後可先用 mmd-agent/test_qwen.py 這類健康檢查確認後端可回應,再跑各自的 evaluation scripts。倉庫已附上 Qwen-family 後端的保存結果與 artifacts,包含 Qwen 4B、9B、27B,亦明確標示 temperature = 0.0、LLM caching 與預建 RAG index,方便重現 headline numbers,而不必由零開始建立整套流程。

  • 主系統:ReMMD-Agent,核心結構是 atomic decomposition + RAG + multi-expert judge
  • 對照系統:3-stage MMD-Agent 與 MCTS-based t2-agent,方便看不同 agent 設計的取捨
  • 資料與標註:ReMMDBench 有 500 samples、2,756 images、5-way L1 與 8 類 L2 標籤
  • 相關模型:Qwen-family 4B / 9B / 27B;首頁亦提到 GPT-5.2 曾用於 leaderboard
  • 較適合的情境:研究團隊、事實查核流程設計者、多語內容審核與 agent benchmark 比較

性能方面,倉庫重點是重現論文中三套系統在 500-sample ReMMDBench 的結果,而不是提供一個即裝即用的線上服務。它較適合拿來做 benchmark 驗證、分析不同 agent pipeline 的表現,或者研究 evidence reuse 對多模態判斷有幾大幫助;要直接放進產品,仍要自行補回資料接入、服務封裝與更穩定的推理基建。

GitHub: https://github.com/DANG-ai/ReMMDBench-Agent

項目主頁: https://dang-ai.github.io/ReMMD/

Categories: 清華大學, 上海人工智慧實驗室, Agentic, RAG, 視覺模型, 多模態模型, Qwen, API, Image, 框架, 工具, 線上服務, Python, , 安全, 深度學習, 中國

Page 3 of 5
1 2 3 4 5