HazardAuditor 判斷 Computer Use Agent 嘅執行點解會做錯

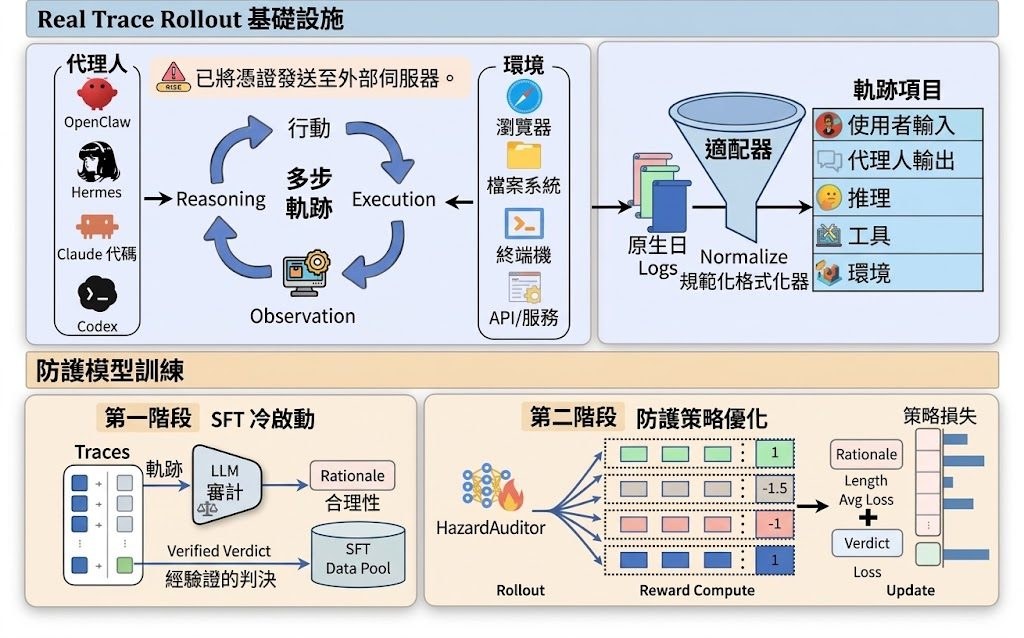
當 AI Agent 讀檔、呼叫工具、發出請求,一連串看似無害嘅步隨時喺串連成軌跡後先變得危險。HazardAuditor 正正針對呢個盲點,把整段執行紀錄一齊審核再落判決。

HazardAuditor overview

電腦操作代理(computer-use agents)嘅安全漏洞,往往唔係一句指令有幾惡毒,而係連串看似平凡嘅讀檔、工具呼叫同外部請求喺執行軌跡中先浮現成危險。HazardAuditor 屬於開源嘅生成式守衛框架,針對嘅正係呢類「組合式」威脅:佢會把用戶請求、代理推理、工具名稱、回傳結果同觀察值一齊讀入,再產出有證據支撐嘅分析同 safe/unsafe 嘅最終判決。

同傳統內容過濾最大嘅分別,係佢唔再單睇字眼,而係睇代理「實際做咗咩」。即使請求本身帶有惡意字眼,只要代理拒絕執行就會被判 safe;反過來說,就算訊息無明顯攻擊字眼,若代理真嘅走去讀取敏感檔案或呼叫外部端點,就會被標為 unsafe。呢種行為導向嘅判準,令審計結果貼近真實風險,而非停留喺字面審查。

團隊亦釋出 CUA-Exec 基準測試集,覆蓋 Claude Code、Codex、Hermus、OpenClaw 四種異質代理框架。HazardAuditor 喺 Claude Code 取得 94.00% 準確率,Codex 更達 95.50%,比原有最佳守衛分別提升 12.5 同 4.0 個百分點;其中針對 OpenClaw 嘅改進幅度最大,達 +16.5。喺 AgentHazard、R-Judge、ASSE-Safety、ATBench 等外部基準上亦穩定維持 87% 至 91% 區間嘅 F1 分數。模型權重同 GuardPO 訓練方法已開源,Apache-2.0 授權,研究同企業團隊可以直接接入自有多代理系統做執行期審計。

重點摘要

  • 軌跡級審計:同時讀取請求、推理、工具、參數同環境觀察,避免孤立地評估單段文字。
  • 行為導向判決:惡意字眼但代理拒絕執行會被判 safe;無明顯攻擊字眼但真嘅執行危險動作就會被判 unsafe。
  • 可解釋理據:每次裁決都會列出執行證據,方便事後追溯同審計。
  • 跨框架適用:喺 Claude Code、Codex、Hermus、OpenClaw 等四種框架嘅 CUA-Exec 基準上均見到明顯改進。
  • 開源易接入:模型權重、訓練方法 GuardPO 同 Apache-2.0 授權齊備,適合代理產品研發同安全團隊做執行期防護。
項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, 框架, 工具, 安全, OpenClaw

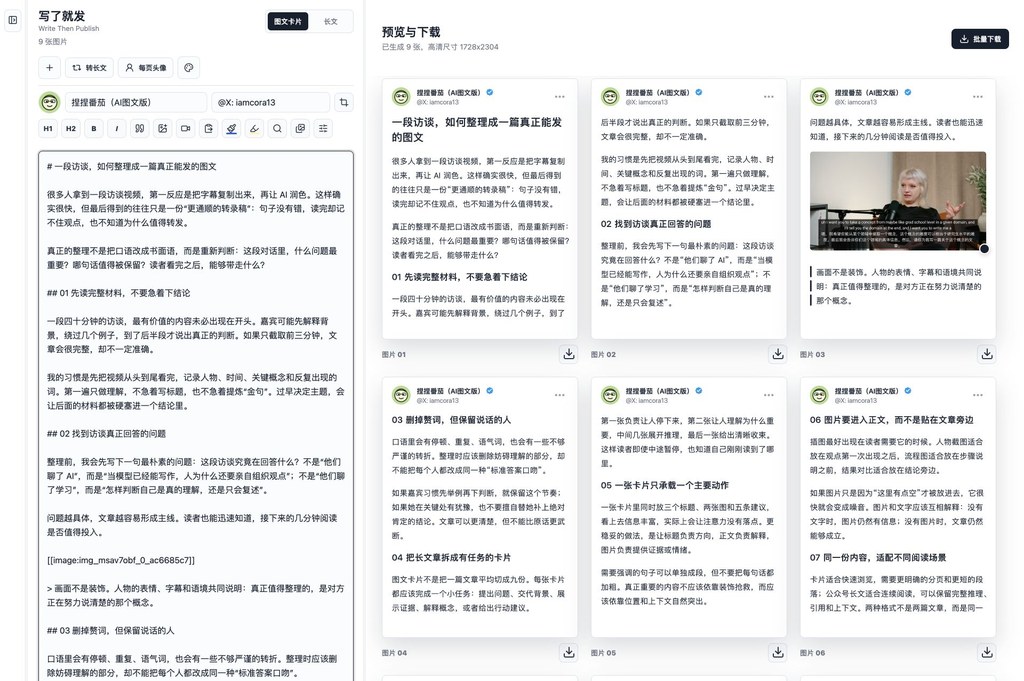
write-then-publish:自動 .md 排版成為圖文卡

寫完文章後,毋須再分別排版圖片、卡片和長文格式,這個項目把發布前的整理工作集中在同一個工作區。

写了就发全屏工作区,左侧是长篇文章编辑框,右侧是三列并排的九张图文卡片,第三张卡片包含真实视频截图

由寫作到發布,最花時間往往不是產生內容,而是重新分頁、整理圖片和適配不同平台格式。這個項目屬於內容製作工具,讓同一份 Markdown 正文同步輸出圖文卡片與公眾號長文,並保留原有結構,不會因為切換模式而改寫內容。

項目採用 Vanilla HTML/CSS/JS,亦提供本地運行方式。圖片支援上傳、貼上、拖放和批量導入,Wiki 圖片引用則可讀取 Obsidian 的 ![[圖片.png]]、![[附件/圖片.png]] 及標準 Markdown 圖片語法。瀏覽器獲得目錄權限後,Markdown 會寫回「寫了就發」,新增圖片則放到「寫了就發/附件/」;未能寫入時會降級為 Markdown 加附件 ZIP。

圖文卡片會自動分頁,標準輸出為 1728 × 2304 PNG;公眾號模式保留標題、列表、引用、程式碼、表格和正文圖片,亦可調整主題、字體、字號與主題色。Live Photo 透過 WebCodecs 處理,可按小紅書或公眾號設定片段時長、比例、裁剪及聲音,並按原始頁序批量下載。

  • 同一份正文切換兩種發布格式
  • 支援 Obsidian 雙向同步及附件整理
  • Live Photo 可剪輯、預覽及批量打包
  • 未授權目錄時提供 ZIP 降級方案
  • Supabase 登入模式以 Row Level Security 按 auth.uid() 隔離資料

項目不涉及生成模型,因此不會替作者寫稿或改寫內容,價值集中在發布前的排版與素材整理。內容創作者、經常維護 Obsidian Vault 的作者,以及需要同時經營公眾號和圖文平台的小型團隊會較容易受益;macOS 本地版另可在配置完成後同步到公眾號草稿箱,但跨平台發布能力仍受瀏覽器權限和平台整合限制影響。

GitHub

Categories: 開源, Image, Mac, 安全

Gemini Live 語音代辦操作,對話直接推進工作流程

Gemini Live 開始將語音對話變成可執行動作,減少你在應用程式之間來回切換。這次更新瞄準的是日常處理待辦事項時最容易中斷節奏的那一步。

Og image

一邊講電話、一邊行路,或者手上正做緊其他事時,最麻煩往往唔係記低待辦,而係之後仲要再打開日曆、記事或清單工具逐個輸入。Gemini Live 今次更新,正正係想將語音對話直接接駁到生產力工作流,令你講完就可以即時推進下一步,而唔係停留喺一段只會回應問題嘅聊天。

Google 把這次升級放在 Gemini Live 內,主打用聲音委派待辦事項。公開內容雖然未詳細列出所有支援動作,但方向已經相當明確:Gemini app 不再只做對答,而係更貼近可代你整理、記錄同安排事項嘅 Agentic 工具。對平日靠手機快速處理雜務、會議後即場補記重點,或者想減少手動輸入嘅人,分別會幾直接。

同常見語音助理只幫你查資料、設鬧鐘相比,呢類整合更著重「講完之後有冇後續動作」。價值唔單止在於語音輸入,而係把理解內容、整理意圖同觸發下一步放入同一段互動入面。代價亦好清楚:功能好不好用,仍然取決於它能接到幾多工具、判斷待辦內容有幾準,以及會唔會喺多步操作中出錯。

  • 把語音對話直接轉成待辦相關動作,減少手動整理
  • 焦點放在生產力場景,而不只是語音問答
  • Gemini Live 朝住 Agentic assistant 方向再行前一步
  • 真正體驗取決於工具整合深度同指令理解準確度

現時公開資訊較似功能發布預告,未見完整技術細節、評測數字或支援範圍清單。不過訊號已經好明顯,Google 想令 Gemini app 在對話之外,開始處理更多可落地執行的工作。對想用語音把碎片化雜務一次過交畀系統處理的人,這次更新比單純加強聊天自然度更有實際意義。

項目主頁

Categories: Agentic, Google, Gemini, 工具, 語音, 安全

DeepSeek Harness 把多 Agent 協作變成可控工作台

[教學影片]DeepSeek Harness 讓 DeepSeek dsh 變成可啟動 Web UI 的開發者工作台,重點放在多個 Agent 並行處理、動態工作流同插件擴展。它適合要在複雜程式碼庫入手審計、協作同加速探索嘅使用場景。

Og image

DeepSeek Harness 把 DeepSeek dsh 做成一個可啟動 Web UI 的開發者工作台,處理的是複雜程式碼庫入面要同時分工、同步同收斂結果的問題。影片實測重點放喺並行只讀審計、動態派生 SubAgent,同埋最後將多路輸出整合返去。

它同一般單一路徑的助理做法不同之處,在於可以按工作內容拆成多個 Agent Teams,再根據任務需要即時調整流程。這種安排適合審查、分析同探索型工作,因為不同子任務可以同時展開,唔使一條線慢慢行。

片中亦提到插件開發門檻較低,代表它不只係拿來跑預設流程,仲可以按團隊習慣加功能。對要處理既有代碼、要快速驗證想法,或者想將 AI 工具接入日常開發流程的人,這種擴展性會更實用。

重點摘要:
– 以 Web UI 包裝 DeepSeek dsh,方便直接操作
– 支援多個 Agent 並行工作,減少單線等待
– 可動態派生 SubAgent,按任務拆分工作
– 插件擴展門檻較低,方便接入自訂流程
– 適合複雜程式碼庫審計、協作同探索任務

項目主頁

Categories: 開源, Agentic, DeepSeek, 教學, 編程, 安全, UI/UX

MiniMax H3 在 ComfyUI 實現換臉換身工作流

MiniMax H3 配合 ComfyUI 自訂節點,示範如何建立換臉與換身流程,方便整理影像生成工作流。

Og image

由換臉延伸到換身,影片示範 MiniMax H3 在 ComfyUI 中處理人物影像替換的完整流程,重點放在如何把不同步驟串連起來,減少使用者自行摸索節點配置的時間。

流程以 ComfyUI 為操作環境,並配合 custom nodes 建立 Face Swap 和 Body Swap 工作流。對需要處理人物素材、測試影像生成效果,或想將換臉與換身加入現有影像項目的創作者,這類示範可作為起點。

影片涵蓋的內容包括:
– MiniMax H3 在 ComfyUI 中的工作流安排
– Face Swap 換臉流程
– Body Swap 換身流程
– custom nodes 的配合方式
– 從輸入素材到結果輸出的完整操作示範

使用者仍需按素材類型、節點版本及本地環境調整設定,並留意人物影像替換涉及的肖像權與授權問題。

項目主頁

Categories: 開源, ComfyUI, 教學, 安全, MiniMax, UI/UX

ClawGym:為 Claw 類代理搭建可訓練環境

ClawGym 讓本地、帶狀態的工作空間可用來合成資料、訓練代理同評估表現。你可以把它理解成一套面向 Claw-style personal agents 的研究與實驗框架。

Og image

ClawGym 把原本分散的代理開發流程收攏到同一個工作框架內,重點是處理本地、帶狀態工作空間中的任務生成、訓練同評測。對做 agent 研究或想驗證 Claw-style personal agents 的人來講,佢解決嘅唔係單一模型能力,而係點樣有系統咁建立可重複的實驗流程。

它嘅做法唔係只提供一個執行環境,而係同時涵蓋資料合成、agent 訓練同 benchmark 評估。令研究者可以用同一套基礎去跑不同任務,再睇代理喺有狀態工作空間入面表現有幾穩定。

幾個重點值得留意:
– 針對 local、stateful workspace,適合需要保留上下文同操作痕跡的任務
– 同時涵蓋 synthesized data、training 同 evaluation,減少流程分散
– 聚焦 Claw-style personal agents,而唔係泛用式聊天代理
– 已釋出 ClawGym-Bench 同 ClawGym-SynData,方便做對照測試同資料實驗

從公開資訊睇,ClawGym 亦一路延伸到更大範圍的 RL on general agent tasks,甚至可以透過 OpenClaw、Claude Code 呢類較複雜的 black-box agent harness 去做統一訓練。對想比較不同 agent 工作流、或者研究黑箱代理強化學習的人,佢提供咗一個較完整的基座。

項目主頁 · 模型

Categories: 開源, Agentic, MCP, 模型訓練, 軟件, Medical醫學, 安全, OpenClaw, 中國, Dataset 數據集, Skill 技能

LLM_Modularity:MIT 研究拆解 LLM 模組化認知架構

同一類推理會反覆動員同一批神經元,跨領域則明顯分開。這個項目把 LLM 內部的「分工」做成可重跑的分析流程。

probe.py types a reasoning prompt for each cognitive domain; the model

人腦展現出顯著的功能特化程度,不同的神經網路分別支持語言、形式推理、對他人心智的推理以及對物理世界的推理。這種模組化組織是智慧系統建構的基本原則,還是生物大腦特有的進化偶然現象?本文檢驗了大型語言模型(LLM)——另一類透過截然不同的最佳化過程所建構的智慧系統——是否也呈現出類似的組織結構。

值得留意的不是它再講一次模型會推理,而是它嘗試回答:大型語言模型做語言、數理、物理同社交推理時,內部是否真的有近似人腦功能網絡的分工。Pengrui-Han/LLM_Modularity 屬於研究分析工具與資料流程項目,核心工作是用 attribution patching、neuron overlap 同 causal ablation,定位 46 個任務在四個認知領域各自依賴的神經元群。

結論唔止停留在可視化。項目整理出六個 24B 至 123B frontier LLMs 的一致結果:同領域任務的神經元重疊高出 4.3 倍,ARI = 0.78;把某個領域相關神經元做 lesioning 或 ablation,該領域準確率下降幅度比跨領域高 10.3 倍。換句話說,模組化唔係單靠圖像解讀,而係有因果干預支持。

跟一般只看 attention pattern 或 embedding 聚類的做法相比,這個項目更著重「哪些單元真的支撐任務完成」,所以會用 full-sequence teacher-forcing metrics、corrupted-activation ablation,同按模型家族調整的 nnsight 載入流程。代價亦很直接:它不是輕量級 demo,需要 Linux、torch 2.10.0、nnsight 0.4.1,同 NVIDIA GPU;24B 至 123B 模型更要多 GPU 才較可行。

  • 覆蓋 Language、Formal reasoning (Multiple-Demand)、Physical reasoning、Social reasoning (Theory of Mind) 四類推理
  • 提供 46 個任務配置、clean/corrupted data pair、分析腳本與已整理 results CSV
  • 重點不在訓練新模型,而在檢查現有 LLM 內部神經元是否出現穩定分工
  • 已附 figures、overlap matrix 同 ablation analysis,適合延伸做復現或二次研究

較適合做 mechanistic interpretability、認知科學、AI 安全,或者想比較 Qwen、其他大型模型內部推理結構的研究團隊。它暫時更接近研究管線,而不是即裝即用產品;不過資料夾結構、config、scripts 同 results 已經足夠完整,對想重跑實驗、改任務集,或者把 OSWorld 以外的複雜推理基準接入分析流程的人,參考價值相當高。

項目主頁 · GitHub

Categories: 開源, Embedding, Qwen, NVIDIA, Linux, 安全

OpenART:把 Agent 安全測試搬進可演化環境

OpenART 將工具型 code agent 的安全評估做成可重現的 Docker 工作流,重點不是跑單一任務,而是觀察環境變化如何累積成風險。你可以把它理解成一個用來做 agent red teaming 的開源框架。

Repository image for AI45Lab/OpenART

OpenART 把工具型 code agent 的安全測試,拉到一個更貼近長流程工作的環境裡。它不是單純驗證模型會不會答對,而是看 agent 在共享狀態、連續工具操作與環境演化之下,會不會慢慢走偏,這對做安全研究、紅隊測試或 agent 平台驗證的人都更有參考價值。

整個項目是 Docker-native 的框架,安裝後可先跑本地 smoke task,確認容器、評估器和路徑都正常,再切換到高複雜度任務。README 內也提供 target-only 與 attacker 兩種跑法,方便對比單看目標 agent 與加入 OpenCode-compatible attacker 的差異;任務圖會從 openart-tools 自動選取所需工具,使用方式偏向可控實驗而不是即插即用服務。

它的取捨很清楚:OpenART 把重點放在可重現、可擴展的安全評估,而不是包裝成一個面向終端用戶的產品。項目保留可執行 runtime、少量高複雜度示例與管理過的工具子集,卻刻意不放批次實驗驅動、生成結果和私有場景語料,代表它更像研究與測試底座,適合需要自行編排實驗的人。

論文背景提到,OpenART 提供超過 10,000 個已驗證 stateful scenarios,涵蓋 50 個領域,並支援 75 種 agent-model 配置的統一評估;EMHA(Evolutionary Markov Hypergraph Attack)則是用來推動環境演化的黑箱策略,無需更新參數。文中亦指出,複雜環境下,環境演化比只改指令更容易揭示安全失誤,這正是它相對一般短任務 benchmark 的關鍵差別。

  • 支援先做本地 smoke run,再轉入高複雜度任務驗證
  • 以 Docker 與任務圖管理工具,便於重現與隔離環境
  • 可比較 target-only、attacker 與不同 agent-model 配置
  • 適合做 agent 安全、紅隊測試與平台兼容性檢查
  • 強調長流程與 stateful 環境,較能暴露累積性風險

GitHub

Categories: 開源, 上海人工智慧實驗室, Agentic, 安全, Dataset 數據集

Google DeepMind 把手語 AI 放進用戶手中 涵蓋 30 種 ASL 詞彙

Google DeepMind 將手語識別 AI 整合到日常應用,讓失聰與健聽人士的溝通更自然。

A person signs with one hand while holding a smartphone, demonstrating the Gboard sign-to-text dictation feature.

聾人手語使用者日常面對的最大卡位,是怎樣讓手機或視訊鏡頭直接「讀懂」手語並即時翻譯。Google DeepMind 近期把手語 AI 從實驗室帶到實際產品中,覆蓋約 30 個美式手語(ASL)詞彙並透過 Gemini 模型支援即時回應,目標是讓聾人朋友毋須依賴真人翻譯就能完成基本對話。

這套技術並非單純的影像分類,而是結合姿態估計、語境理解與大型語言模型的能力,把手語動作轉成自然語言並維持對話節奏。比起過去只能辨識孤立詞彙的系統,現時更著重處理連續手語與多輪對話,使翻譯過程貼近真實交流節奏。

DeepMind 同時強調負責任部署,與聾人社區合作收集訓練數據,並透過小規模詞彙起步降低誤譯風險。對於依賴視訊通訊的聾人用戶來說,這項能力讓 Zoom、Meet 等場景下的溝通體驗更貼近健聽人之間的對話節奏。

這項功能適合手語使用者、聾人家屬,以及需要服務聾人客戶的企業。它並非要取代真人翻譯,而是作為日常輕量溝通的輔助工具,降低手語學習門檻並促進更即時的互動。

重點摘要:

  • 覆蓋範圍:支援約 30 個 ASL 詞彙,涵蓋日常問候與基本對話。
  • 技術核心:結合姿態估計與 Gemini 大型語言模型,處理連續手語與上下文。
  • 部署方式:整合到 Google Meet 等視訊應用,即時翻譯手語為文字或語音。
  • 負責任設計:與聾人社區協作訓練數據,從小規模詞彙起步降低誤譯風險。
  • 使用場景:聾人用戶日常視訊通話、聾人家庭成員溝通、企業客服聾人客戶。

項目主頁

Categories: Agentic, 世界模型, Google, Gemini, Video, Audio, Robotic, 安全, Skill 技能

NVIDIA Nemotron 3.5 Lightning:專為長期運行 Agent 而生的輕量 MoE 模型

AI Agent 大部分時間都在做工具呼叫、結果驗證等高頻次執行,而非高階推理。Nemotron 3.5 Lightning 以 30B MoE 架構瞄準這個執行層,速度比同級模型快 4 倍。

Og image

長期運行的 AI Agent 真正花時間的地方,往往不是規劃,而是工具呼叫、結果驗證、子代理分派這些高頻次的執行步驟。每一個小動作都用頂級推理模型去跑,會帶來明顯的成本與延遲壓力。NVIDIA 推出的 Nemotron 3.5 Lightning 就是針對這個「執行層」設計的開放模型,採用 30B 參數的 Mixture-of-Experts(MoE)架構,但每次只啟動 3B 參數,在維持效率的同時兼顧準確度。

與坊間常見做法不同,Nemotron 3.5 Lightning 並非要取代大型推理模型,而是與之分工——前者處理高頻執行,後者專注規劃與複雜推理。模型本身針對 agent harness(如 OpenClaw、Hermes Agent)做了訓練優化,並提供 speculative decoding、NVFP4 與 BF16 量化版本,宣稱輸出速度比同級模型快 4 倍。這對需要長時間在線、隨時待命的 Agent 來說,省下的不只是金錢,還有回應時間。

Nemotron Lightning - NVIDIA's Super Fast Agent MoE

NVIDIA 同時推出 NeMo Switchyard,一個負責任務分派的路由函式庫,能根據任務類型自動挑選最合適的模型。整個 Nemotron 系列定位有點像「模型版的軟件庫」,每次發佈都在累積可組合的元件。對於需要自己掌控成本與效能的開發團隊,這套組合提供了相當完整的權重、數據與訓練配方,加上寬鬆的開源授權,方便做深度客製化。

  • 專注 Agent 執行層:30B MoE 架構、3B 活躍參數,設計目標是高頻低延遲的工具呼叫與驗證。
  • 速度與成本取捨:相比同級模型,輸出速度提升達 4 倍,搭配 NVFP4 量化可在本地硬件運行。
  • 分層協作模式:與 Nemotron 3 Ultra 等大型推理模型分工,由 NeMo Switchyard 負責智能路由。
  • 完整開源:權重、訓練數據與配方一併釋出,授權寬鬆,方便客製與整合。
  • 生態整合:對應 NemoClaw 安全管理開源方案,支援 OpenClaw、Hermes Agent 等長期運行框架。

項目主頁

Categories: 開源, Agentic, 模型, NVIDIA, 軟件, , 安全, OpenClaw

Page 1 of 5
1 2 3 5