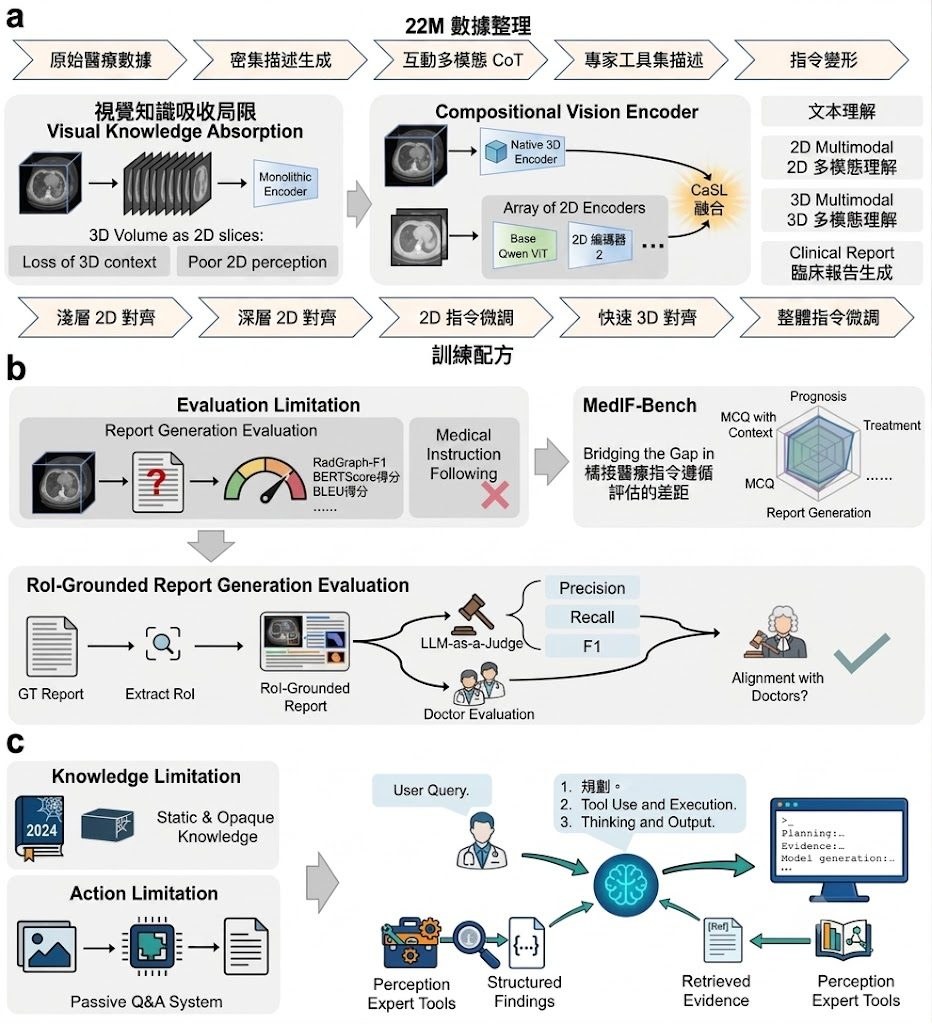
醫療多模態模型最易失準的位置,往往不是會不會答,而是有沒有真正對準影像內容。ClinFusion屬於模型,更準確地說是面向臨床理解的 vision-centric Multimodal large language models (MLLMs) 系統,重點放在同時處理 2D 圖像、原生 3D NIfTI 影像與文字任務,減少只靠文字對齊時常見的臨床細節流失。
現有做法常把醫療問題當成一般多模態問答處理,但作者認為這種範式忽略了 3D 影像與放射科判讀流程,因此用 compositional and cascaded vision encoder 配合 Cascade Spatial-Aware Locality Fusion,把 2D 與 native 3D 醫療影像放進同一個 fused encoder。另一個關鍵不是只換模型,而是連評測也改寫:加入 MedIF-Bench 檢查 instruction following,並用 region-of-interest-grounded 方法評估報告生成的 factualness。