Ox Alpha 百萬 Token 上下文免費試用

Z.ai 最新模型 Ox Alpha 提供 1M-token context window,讓大型程式碼庫、圖像與影片可在同一個推理流程中處理。

Og image

面對大型程式碼庫、長篇規格文件或連續多步工作,Ox Alpha reasoning model(推理模型)可把最多 1M-token context window 的內容放在同一個脈絡中處理,減少反覆切分資料或遺失前文。它亦支援文字、圖像和影片輸入,適合除錯、重構及分析截圖或介面流程。

Ox Alpha 會先規劃和自我檢查,再產生答案,並以 visible thinking 展示推理過程。模型同時提供原生 tool calling、tool_choice,以及配合 response_format 的結構化 JSON 輸出,方便用於長時間運行的 agentic 工作流程。

網站列出的獨立測試涵蓋 10 項真實編程任務,Ox Alpha 完成 8 項,得分 80%;同一比較中,Fable 為 65%,GLM-5 為 62%,GPT-5 和 Grok 4 均為 52%。樣本只有 10 項任務,結果較適合作為參考,未足以代表所有編程場景。

• 1M-token context window,最高 131K tokens 輸出
• 支援文字、圖像和影片三種輸入
• 適合大型程式碼庫的 debugging 和 refactoring
• 原生 tool calling 與結構化輸出
• 免費試用、毋須登入,網站表示不會把聊天儲存在伺服器
項目主頁

Categories: Agentic, 模型, 多模態模型, Video, Image, 軟件, Python, 編程, 免費試用, UI/UX

JIT-Agent:讓模型即時寫出專屬代理框架

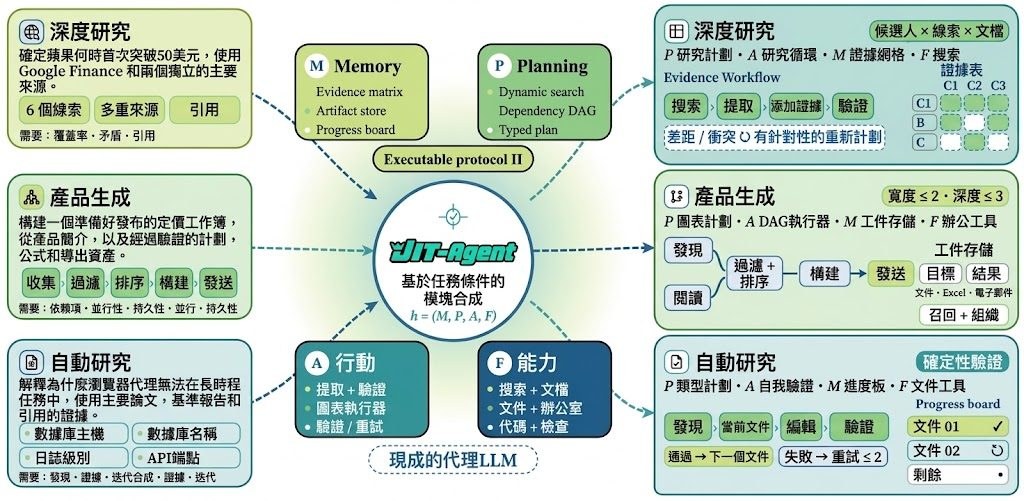
JIT-Agent-27B會按任務即時組合可執行的代理框架,令同一個 Agentic LLM 更貼近研究、辦公及規劃工作。

JIT-Agent

面對深度研究、日常工作或工作區操作等不同任務,固定不變的代理框架未必能有效轉用。JIT-Agent 屬於一個 meta-agent 模型項目,接收任務規格、協議、工具及技能註冊表,再為現成的 agentic LLM 生成特定任務的可執行 harness,處理代理流程難以適配的問題。

JIT-Agent-27B 並非直接取代底層模型,而是負責組合包裝模型的工作方式。每個 harness 由 memory、planning、action 及 capability orchestration 四個模組組成,並透過 HarnessFactory 的共享介面輸出結構化程式碼,避免每次都由模型自由撰寫整套代理程式。

  • 按任務生成不同的記憶、規劃和行動流程
  • 可包裝不同的 off-the-shelf agentic LLM
  • 測試期間會根據 trace 與 feedback 修訂 harness
  • 生成器保持 frozen,改進內容寫入 harness archive
  • 涵蓋研究、辦公、規劃及 workspace 類代理基準

同類方案通常先準備一個通用 scaffold,再期待它在不同任務中轉移;JIT-Agent 將可轉移的能力放在 harness 生成與演化,而不是只依賴 base model 擴大。代價是系統需要任務規格、工具註冊表、過往 harness 及測試回饋,生成品質亦會受這些輸入影響。

JIT-Agent 把 jit/、scripts/、harness_factory/、benchmark/ 及 dataset/ 分開,涵蓋生成與修復提示、代理核心、評估器和基準適配器。 JIT-Agent-27B 在九個代理基準中領先八個。適合研究代理架構、需要為多類工作測試流程的團隊,以及想比較「擴大底層模型」與「改進 harness」效果的人員。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 框架, 編程, Dataset 數據集

GigaBrain-0.7 讓機械人跨場景理解並執行任務

由家居整理到工業操作,GigaBrain-0.7嘗試令機械人適應更多身體形態與工作環境。

GigaBrain-0 Overview

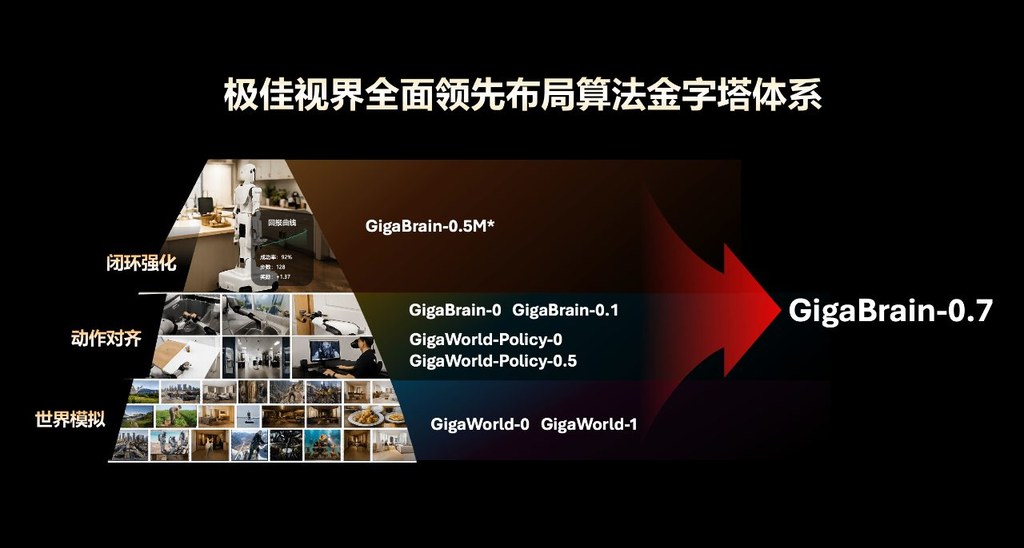
由家居整理到工業操作,機械人要面對的不只是看懂畫面,還要理解指令、預測下一步並控制不同硬件。GigaBrain-0.7 屬於 Vision-language-action (VLA) embodied foundation model,透過統一 understanding、prediction 與 action,處理跨任務及跨機械人形態的泛化問題。

項目以 three-system architecture 組織模型能力,並把預訓練資料擴展至超過 37,000 小時的異質 embodied data,再以 one-stage alignment training 同時優化 vision-language understanding 和 multi-embodiment action generation。相比 GigaBrain-0 系列及包括 π 0.5 在內的先進模型,開發團隊聲稱它在 foundation zero-shot capabilities、language-conditioned instruction following 及 post-training task success rates 均有明顯提升。

GigaBrain-0.7 已提供程式碼、模型和 sample data,模型及資料亦連接至 Hugging Face;但 VLM evaluation code、RoboColiseum、RoboTwin2.0 和 EBench benchmark code 仍列在待辦清單。這代表項目適合研究團隊先重現流程及測試資料管線,未必已具備完整、即插即用的標準化評測環境。

讀者可從以下幾點理解其價值與取捨:
– 支援多種機械人形態,目標是提升跨硬件泛化能力。
– Maker H01 及主流機械人平台涵蓋家居和工業場景。
– 大規模異質資料有助擴闊任務範圍,但亦提高訓練及硬件需求。
– 開放程式碼、模型與樣本資料,方便研究及二次開發。

對機械人研究、具身智能及需要跨平台控制的團隊,GigaBrain-0.7提供了較完整的模型、資料與訓練實作入口;商業落地仍需自行驗證安全性、硬件兼容性、延遲及長時間任務穩定度。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, VLA, Robotic, Dataset 數據集

OraRL:標註即 Rollout,統一多模態模型強化學習

OraRL 把影片標註轉成可靠的正向 rollout,令同一模型兼顧定位、分割、追蹤、問答與空間理解。

Animated OraRL method preview

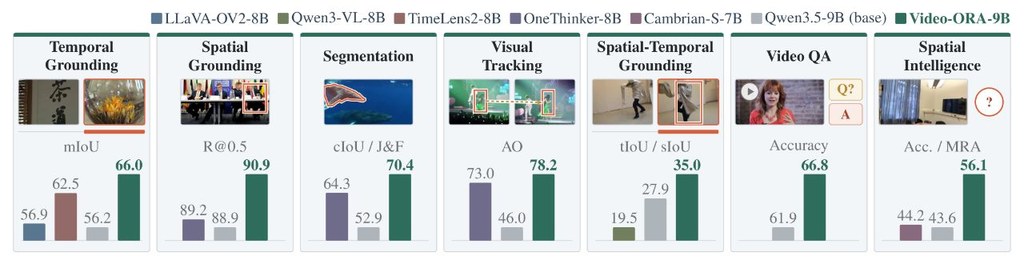
面對一段長影片,模型要同時回答內容問題、找出時間片段、定位畫面區域,往往要在多套任務方法之間取捨。OraRL 是一個用於統一影片多模態模型(video MLLMs)強化學習的研究項目,將原本只用來評分答案的標註,序列化成模型可直接學習的 oracle rollout。

它的核心做法是把一條標註答案加入同一提示的 policy samples,再只用 policy rewards 計算 on-policy baseline,避免準確標註扭曲模型原本的相對比較;annotation-policy reward gap 則用於方向性修正,最後以 sign-balanced pruning 篩選更新訊號。這個安排保留探索,同時不需要 chain-of-thought supervision 或額外解碼。

同一套更新規則覆蓋 temporal grounding、spatial grounding、segmentation、tracking、spatial-temporal grounding、video QA 及 spatial intelligence,Video-ORA-9B 則以一個模型處理七類影片理解任務。4B 設定的更新時間由每步 92.5 秒降至 62.4 秒,速度提升 1.48 倍,單張 GPU 峰值記憶體亦由 62.4 GB 降至 50.9 GB。

推理部分提供較實用的取捨參考:H20 以 vLLM 和 BF16 載入時,4B 及 9B 分別佔 8.6 GiB 和 17.6 GiB;十分鐘、每秒兩幀的影片採用 answer-only decoding 後,總延遲由 29.03 秒降至 24.30 秒。儲存庫列出 Environment、Training 及 Evaluation 文件,但提供的資料未包含完整安裝步驟或可直接下載模型的細節,較適合研究團隊按文件檢查環境後測試。

  • 訓練方法:標註同時作為正向 rollout 和任務有效的學習目標。
  • 涵蓋範圍:一套 RL recipe 支援七類影片感知任務。
  • 效率改善:4B 更新速度提升 1.48 倍,記憶體需求下降。
  • 推理優化:支援影片快取、一次解碼重用及 answer-only decoding。
  • 適合情境:需要統一處理影片定位、追蹤、分割、問答和空間推理的研究或工程團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 世界模型, 模型訓練, Video, 影像處理, 框架, Dataset 數據集

VA-Judger 生成更貼近人類偏好的影片與聲音

VA-Judger 以人類偏好比較影片和聲音生成結果,改善單靠獨立指標造成的失真與獎勵錯配。

VA-Judger training pipeline

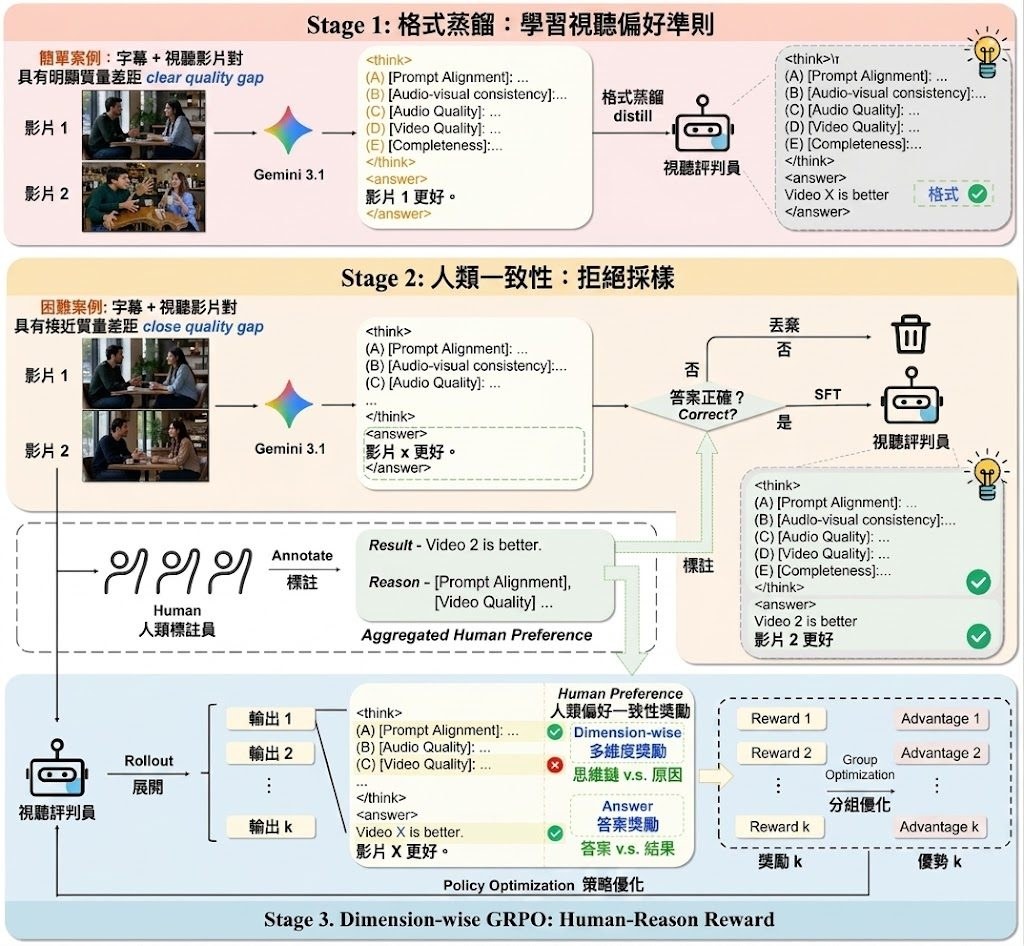
同一個提示詞產生兩段影音內容時,VA-Judger會比較哪一段更符合人類偏好,並拆解提示詞對齊、影音一致性、音質、畫質及內容完整度。它屬於聯合影片與音訊生成的 Reward Model,處理傳統指標難以捕捉整體連貫性的問題。

模型以 Qwen3-Omni 為基礎,先從品質差距明顯的配對學習比較準則,再透過拒絕採樣處理接近的結果,最後以 dimension-wise Group Relative Policy Optimization(GRPO)把人類回饋分配到不同品質維度。這比把音質、畫質及同步指標簡單相加更貼近觀看者的整體判斷,也減少生成模型鑽指標漏洞的機會。

VA-Judger-Bench包含同領域及跨領域模型比較,用來測試 Reward Model 是否能對齊人類選擇;研究結果指向它優於多項指標基線。VAPref-10K則包含9K提示詞及10.3K組細緻的影音配對比較,但資料集及部分訓練程式仍未發布。

項目提供 Reward Model 推理、Video Model 推理、模型 SFT,以及以 VA-Judger 分數優化 LTX-2 的流程;README亦列出合併已發布 RL LoRA 的 LTX-2 checkpoint。提供的資料沒有列出完整安裝步驟,使用者需要按項目頁面、checkpoint及程式碼狀態自行確認環境。

  • 適合場景:研究影音生成、偏好對齊及 RL post-training 的團隊
  • 可評估內容:提示詞對齊、影音一致性、音質、畫質及內容完整度
  • 主要取捨:比較人類偏好的方法較全面,但需要配對資料及額外訓練流程
  • 目前限制:dimension-wise GRPO 程式碼及 VAPref-10K 仍列為待發布項目

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 視頻模型, 模型訓練, Qwen, Video, LTX, Dataset 數據集

WeMM-Embedding 統一多模態向量

WeMM-Embedding 把文字、圖片、影片和視覺文件放進同一套向量空間,適合要做檢索、比對和跨模態搜尋的場景。它同時提供不同尺寸選擇,方便在準確度與成本之間取捨。

WeMM-Embedding Performance Overview

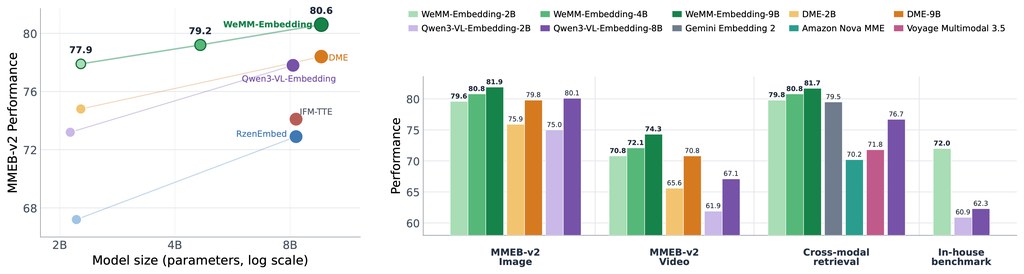
WeMM-Embedding 是一組多模態 embedding 模型,目標是把文字、圖片、影片、視覺文件和交錯式多模態輸入,轉成可直接比對的統一向量。對要做搜尋、相似度比對、內容檢索或跨媒體匹配的團隊來說,這種做法比逐一分開處理不同素材更省事。

它提供 2B、4B、9B 三個版本,還支援 Matryoshka dimensions,代表可以按需要輸出不同長度的 embedding,減少計算和儲存成本。README 也提到,向量來自 <embedding> token 的最後一層 hidden state,再做 L2 normalization;目前不支援 audio。

實作和試跑方式都算直接,既可以用 transformers,也可以用 SentenceTransformer 直接載入 Hugging Face 模型 ID。作者同時標明推理較建議用 transformers==5.2.0,原因是較新的版本在前處理行為上可能有差異;serving 方面則測過 vLLM 和 SGLang。

  • 統一處理 text、image、video、visual document 和 interleaved multimodal inputs
  • 支援 Matryoshka dimensions,可按成本需要縮短 embedding 長度
  • 適合做跨模態搜尋、內容去重、相似度比對和檢索索引
  • 推理可用 transformers 或 SentenceTransformer,部署可接 vLLM、SGLang
  • 現階段不支援 audio,做語音相關流程要另配其他模型

對要處理多媒體內容的應用團隊、檢索系統、內容平台和資料整理流程,這類模型最直接的價值是減少多套表示法之間的銜接成本。它在多個基準上取得領先結果,但實際選型仍要看你要的是完整維度、較低成本版本,還是偏向部署效率的配置。

GitHub · 模型

Categories: 開源, 騰訊, AI productions, Embedding, 模型, 多模態模型, Video, Image, Audio

RiboSpan 把長篇 RNA 納入 10K 上下文模型

長篇 mRNA 不再需要截斷處理,RiboSpan 以單核苷酸解析度同時理解完整轉錄本。

RiboSpan architecture

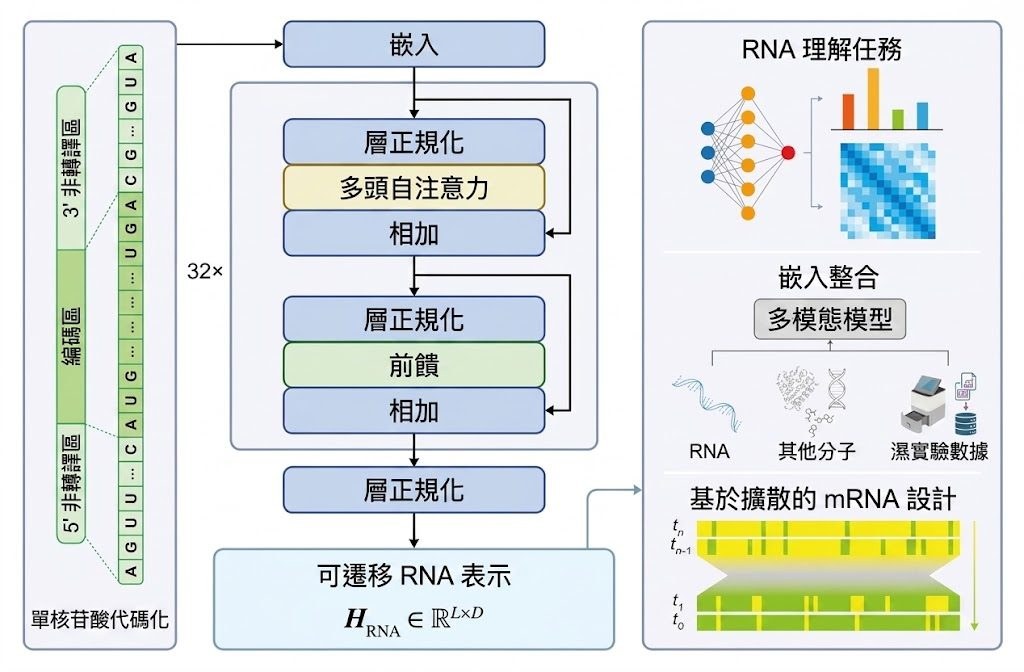
長篇 mRNA 過往容易因約 1K 的上下文限制而被截斷,令 5′ UTR、CDS 和 3′ UTR 無法放在同一個模型視野內。RiboSpan 是一個 RNA foundation model,實際處理的是完整長鏈 RNA 的聯合表示與下游建模問題。

項目採用 1.61B 參數的雙向 Transformer,每層都使用 dense self-attention,並以每個核苷酸一個 token 的方式保留位置對齊資訊。RiboSpan-10K 原生以最多 10,240 nt 的長度預訓練,不依賴推理階段延長上下文;訓練資料包括 6,760 萬條 RNA 序列,合共 857 億個核苷酸,來源涵蓋 RNAcentral、Ensembl 和 Ensembl Genomes。

  • 單核苷酸 tokenization,保留高解析度序列位置
  • Bidirectional Transformer 可同時讀取上游、下游及遠距離資訊
  • RiboSpan-10K 原生支援 10,240 nt 長上下文
  • 不加 task-specific head 或 fine-tuning,frozen representation 在評測中達到 state-of-the-art,長 RNA 尤其突出
  • 以 40% masking 繼續預訓練,可提升高比例遮罩下的重建能力,同時保留 15% masked language modeling(MLM)訓練建立的 backbone 表示

研究者可從 Hugging Face 載入預訓練 RIBOSPAN checkpoint,再以 Python 整合序列表示、重建或其他 RNA 分析流程;checkpoint 會自動下載並快取,亦可改用本地路徑。模型規模和 dense attention 帶來較高的記憶體及運算成本,長度超過 10,240 nt 的轉錄本仍需另行切分或設計處理策略。

RiboSpan 適合研究 RNA 功能、長轉錄本表示和生物資訊模型的團隊,尤其方便先固定 backbone、再測試下游任務的人員。相較只處理約 1K 上下文的 dense RNA encoder,它保留完整轉錄本關係;代價是 1.61B 參數令本地推理和微調門檻更高,而模型權重亦採用非商業授權,商業項目需要先核對限制。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Python

WithEveryone 多人合照不再撞臉

復旦大學、騰訊混元與香港大學研究團隊,嘗試一次保留五至十個人物身份的群組生成。

WithEveryone teaser

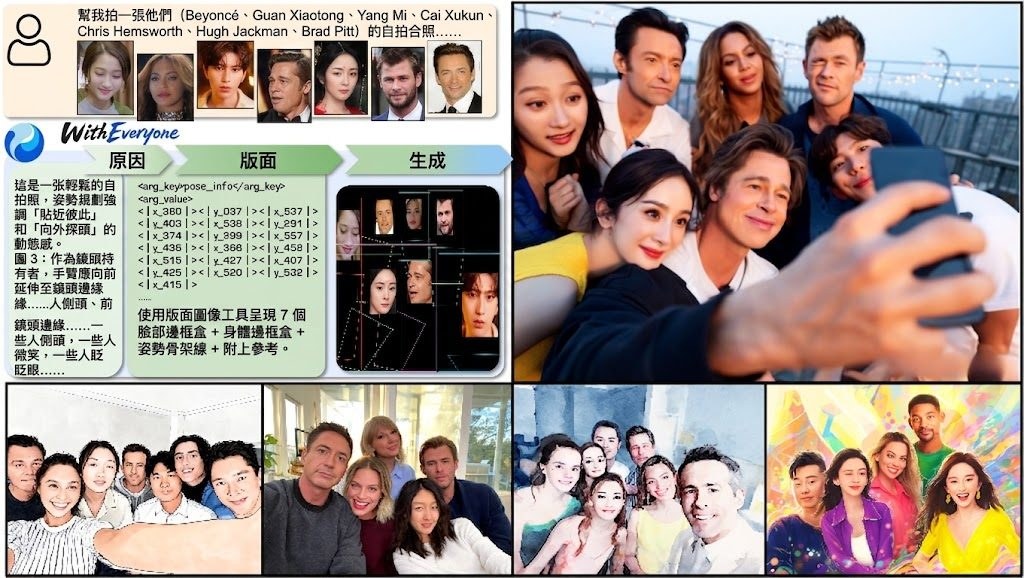
復旦大學、騰訊混元(Hunyuan)及香港大學的研究團隊共同開發 WithEveryone,針對 AI 生成多人合照時人物身份容易混淆的問題,讓五至十個參考身份可以同時出現在連貫場景中。它屬於群組影像生成研究項目,核心價值是維持每個人「誰是誰」的對應關係,而不只是增加畫面人物數量。

系統會把每個參考人物轉換成獨立的 identity token,再透過 Layout CoT 預先推理人物、臉部、身體區域與姿勢的位置,最後交由 renderer 生成視覺條件。Layout-Grounded ID Loss 會在指定臉部區域提供身份監督,ID Representation Forcing 則要求模型在合成前先為每個身份建立預測,減少多人場景中的錯配。

研究展示提供了 63 組生成結果,並在 identity-disjoint benchmark 上比較身份保真度與複製參考圖程度:WithEveryone 的 ArcFace similarity 為 0.614,高於 GPT-Image-2 的 0.566;Copy-paste score 為 0.055,低於 GPT-Image-2 的 0.169。這表示它一方面維持人物特徵,另一方面較少直接照搬參考圖,但目前資料未提供更完整的速度、硬件需求或不同人數下的細分結果。

目前 GitHub 儲存庫尚未提供可下載的研究版 checkpoint,亦沒有完整安裝及測試流程。原因是研究版本依賴的 foundation model 授權不容許公開 checkpoint;團隊正以支援開源發佈的 foundation model 訓練新版本,待程式碼及 checkpoint 準備好後才會分享。

  • 支援五至十個參考身份的群組影像生成
  • 以 identity token 綁定人物,配合身份感知的版面推理
  • 透過 Layout-Grounded ID Loss 監督指定臉部區域
  • 研究結果在 ArcFace similarity 及 Copy-paste score 上勝過 GPT-Image-2
  • 現階段只能閱讀研究展示,未能按儲存庫資料自行安裝重現

對需要製作多人宣傳照、角色群像或指定人物場景的影像研究團隊,這個方法提供了比單純堆疊參考圖更完整的身份與構圖處理思路。一般創作者暫時仍要等待開源版本,因為未公開 checkpoint 令項目現階段更接近研究展示,而不是可即時採用的生成工具。

項目主頁 · GitHub

Categories: 開源, 香港大學, 騰訊, 模型, 多模態模型, Image, 香港, Dataset 數據集

FACET-Terminal:讓終端任務由可執行環境先行生成

FACET 把技能、Docker 環境、解法與驗證器連成同一狀態,產出可真正執行驗證的終端任務。

FACET: Preserving Source Intent and Executable State in Terminal Task Synthesis

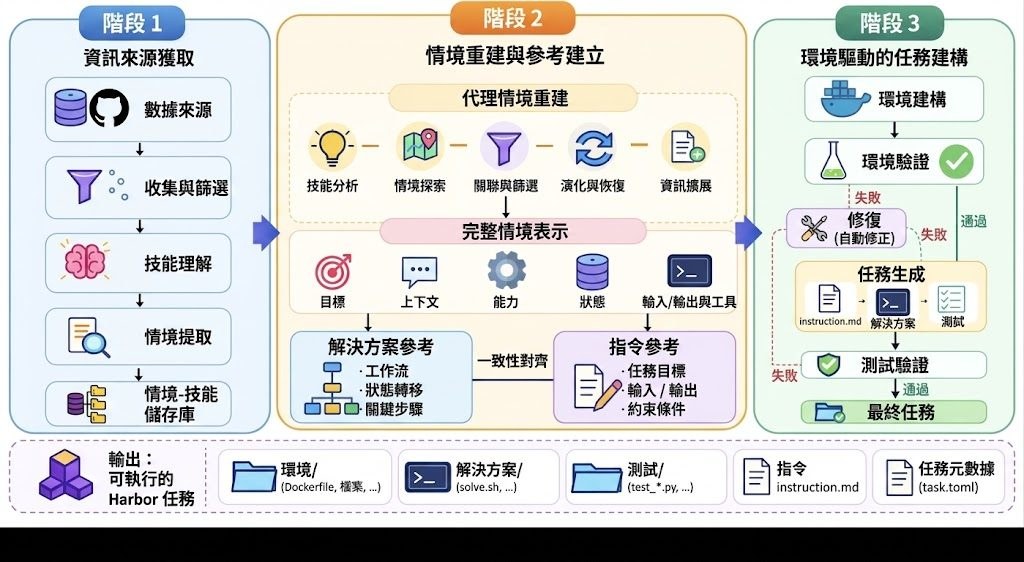
終端 AI Agent 最怕指令寫得合理,環境、解法和驗證器卻互相對不上。FACET(Fine-grained Agentic Construction of Executable Tasks)是一套終端任務合成框架,先建立並修復 Docker 環境,再讓指令、參考解法和驗證器共享同一套執行狀態,處理複雜任務難以穩定測試的問題。

項目由 71,341 個來源技能整理出 7,852 條場景—技能種子,最後取得 6,078 個通過執行驗證的任務,並從成功 rollout 篩選約 1.2K 條完整軌跡,用於監督微調 Qwen3.5 系列模型。環境中的檔案、路徑、套件、連接埠、資料結構和測試資料會沿流程傳遞,減少純文字交接造成的落差。

資源包括 FACET-Terminal-Tasks-6k 數據集,以及 FACET-Terminal-Qwen3.5-4B、9B 和 27B 模型。要重現任務合成流程,需要 Python 3.11–3.13、uv、Docker 和模型 API;配置與 Python 程式集中在 facet/,並提供 FORWARD、REVERSE、JOINT 三種生成策略作比較。

Terminal-Bench 2.1 的三次獨立執行平均結果顯示,4B、9B、27B 模型分別由 17.60、27.34、40.82 提升至 24.72、35.58、47.57;4B 相對提升 40.5%,27B 更接近同設定下 Qwen3.5-397B 的 49.06。這批數據規模仍然有限,任務質素亦依賴 Docker 環境和驗證器是否正確,較適合研究 Agent 訓練、Terminal-Bench 評測及需要可重現終端操作的團隊。

  • 資料基礎:6,078 個通過執行驗證的任務
  • 生成方式:環境先行,指令、解法與驗證器共享狀態
  • 公開模型:Qwen3.5 4B、9B、27B
  • 評測結果:27B 在 Terminal-Bench 2.1 達 47.57
  • 適合場景:終端 Agent 訓練、任務合成及可重現評測

項目主頁 · GitHub · 模型

Categories: 開源, 上海人工智慧實驗室, Agentic, 模型, 模型訓練, API, Python, 中國, Dataset 數據集

RapidLiDAR:單次前向傳播做到 10 Hz 嘅 LiDAR 場景補全

佢將稀疏嘅部分點雲一次性還原成稠密場景,主打即時同可調速度,適合對延遲敏感嘅自動駕駛同機器人開發者。

Repository image for AzharSindhi/RapidLiDAR

對做自動駕駛或機械人感知嘅人嚟講,LiDAR 場景補全最頭痛嘅唔係質素,而係慢——好多現有方法要幾百毫秒先出一幀,根本追唔上車規或即時反應嘅需求。RapidLiDAR 嘅定位就喺呢度:佢設計成一個端到端、單次前向傳播嘅補全模型,目標係跑到接近 10 Hz,同時保留可調速度同可調節輸出密度嘅彈性。

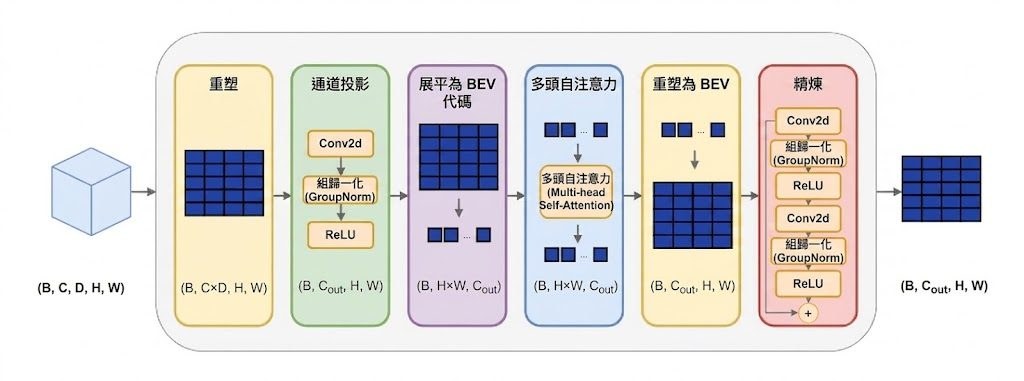
做法上,佢先用體素化抽取多尺度 3D 特徵,再透過一個自注意力 BEV 頭產生密集 2D 特徵圖。Adaptive Initialization Module 會預測一個空間變化嘅位移,把稀疏點雲「撐開」做粗略初始化;之後 Multi-Scale Reconstruction Module 用可變形注意力(deformable attention)將每點特徵同多尺度 BEV 特徵對齊做精修。如果想再稠密仲可以加一個可選嘅 Refinement Network 喺凍結嘅主模型上做上採樣,倍率為 κ。

換句話講,舊方法通常分開做初始化同迭代 refinement,或者用兩階段網絡先粗後細;RapidLiDAR 將呢幾步壓入一次前向,靠 BEV 座標化同可變形注意力同時兼顧效率同幾何一致性。代價係依賴 SemanticKITTI 風格嘅資料 loader,需要 .npy 格式嘅 GT 同 input 配對,唔係 out-of-the-box 處理原始 Velodyne 掃描。

適合做自動駕駛 stack、實時 SLAM、機械人感知原型,或者想喺邊緣裝置上試稠密 LiDAR 預測嘅團隊。原文強調即時性為 10 Hz,具體 mIoU 或 Chamfer distance 等數字未在 README 完整列出,安裝需 CUDA 12.4 同 PyTorch 2.4.1,並要自行 JIT 編譯 Chamfer distance CUDA extension。

GitHub · Paper

Categories: 開源, 模型, 視覺模型, NVIDIA, Robotic, 3D, Python, Dataset 數據集

Page 24 of 55
1 … 22 23 24 25 26 … 55