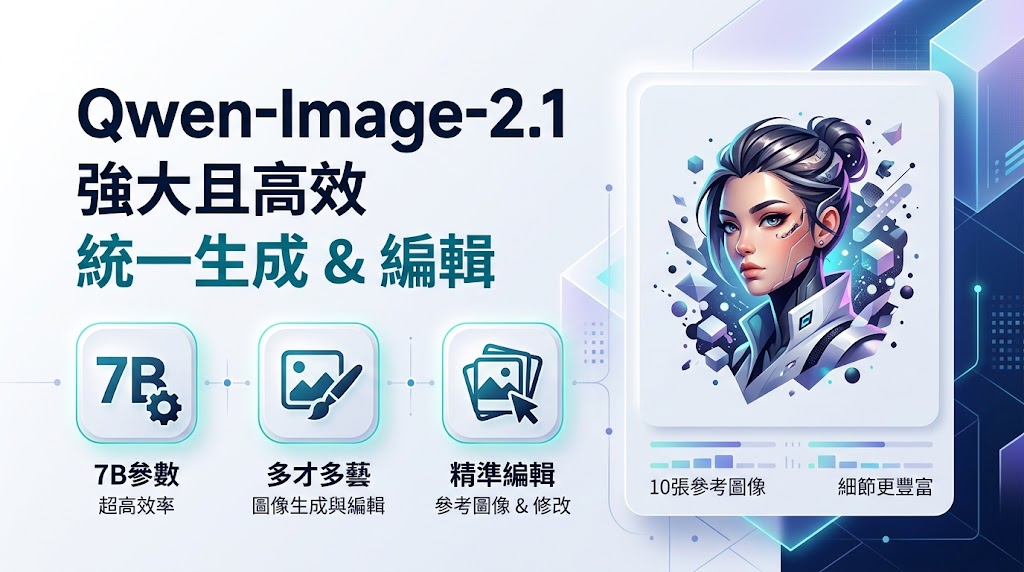
Qwen-Image-2.1 開源:透明圖層生成與多圖編輯

7B 參數的 Qwen-Image-2.1 把文生圖、圖片編輯、透明背景生成整合在同一個模型,一次可參考 10 張圖片,門檻不高但功能更齊全。

在 AI 繪圖的世界裡,能同時處理文生圖、改圖、還能直接輸出透明背景圖的開源模型並不多。Qwen 團隊這次開源的 Qwen-Image-2.1,把這幾件事整合進同一個 7B 參數的視覺生成模型,使用時不需要切換不同模型或額外加工。對做貼圖、做商品圖、做素材整理的人來說,這種「一個模型走到底」的做法很貼合日常工作流。

模型採用 32 層 Single-Stream DiT 結構,配合混合粒度注意力與 prefix KV cache 復用,把運算成本壓低。即使在顯示卡記憶體有限的環境下,仍能輸出品質不錯的圖片;Apple Silicon 用戶也能用 MPS 加速跑得動。

Qwen-Image-2.1 對透明背景(RGBA)的處理是這次的亮點之一。文字描述可以直接生成帶 Alpha 通道的圖,也能把照片裡的主體分離出來變成透明底,省去摳圖步驟。編輯功能同樣豐富:最多可同時參考 10 張圖片,用圓圈、塗鴉或遮罩標記局部修改位置,並在人物、產品場景保留識別特徵,避免改一處卻跑掉整個主體。
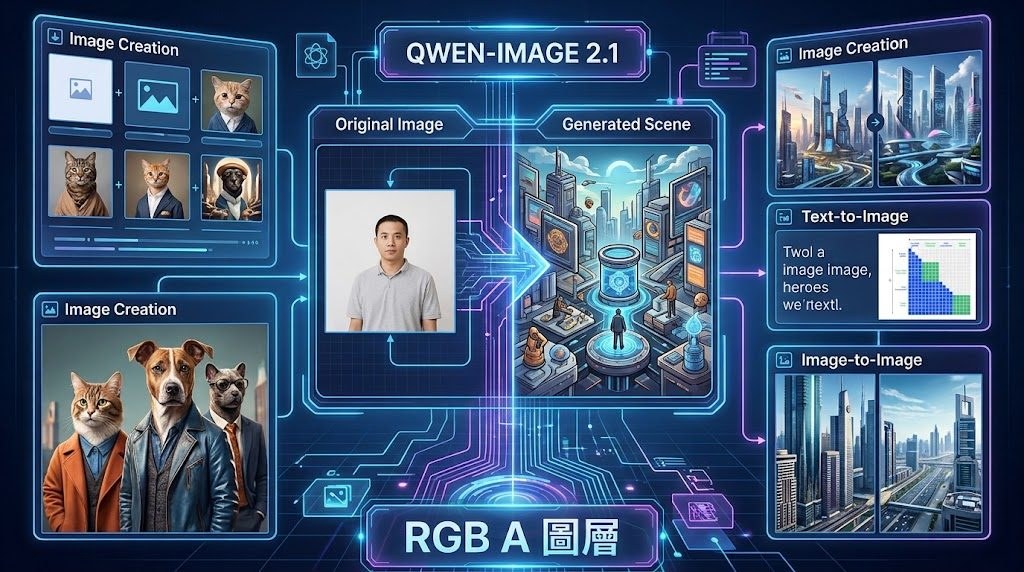
Og image

文字渲染和人像光影也比上一代細緻,招牌、卡片、海報一類需要清晰排字的場景更實用。整體定位偏向「夠用、好用、可商用」的工具型模型,不是衝榜級的影像模型。

重點摘要

  • 統一模型:文生圖、圖片編輯、RGBA 透明圖生成整合在同一個 7B 參數模型
  • 高效率架構:32 層 Single-Strteam DiT,搭配混合粒度注意力與 prefix KV cache 復用
  • 多圖參考編輯:最多支援 10 張參考圖,可用圓圈、塗鴉或遮罩指定修改區域
  • 主體保留:在人物、產品場景保持識別特徵,不會改一處就全跑掉
  • 透明背景原生支援:可文字直出 RGBA,也能從照片分離主體成透明底

模型已在 Hugging Face 開源,並提供 Diffusers 整合程式碼、Google Colab 與 Kaggle Notebook,Apple 用戶亦可透過 Draw Things 或 DiffusionBee 等本地 App 直接試用。
項目主頁 · GitHub · 模型

Categories: 開源, 模型, Qwen, Google, Image, 影像模型, 影像處理, txt2img, 蘋果

Qwen3.8 邊講邊翻譯即時生成字幕

阿里旗下 Qwen 推出 LiveTranslate 模式,用同一個模型一邊聽語音、一邊翻譯、一邊輸出字幕,支援中文、英文等多語言即時對話。

Og image

Qwen 團隊最近公開了 LiveTranslate 模式,主打邊聽邊譯、邊講邊出字幕。它把語音輸入、翻譯與字幕生成壓在同一個模型流程內,使用者開咪講一句,系統幾乎同步輸出另一種語言的文字,毋須額外挂接翻譯 API 或字幕引擎。

對於要做跨語言會議、外語直播、跨國客戶支援或聽打外語影片的團隊,這種一條龍處理可以直接省掉以往語音轉文字、再丟給翻譯模型、再做字幕排版的工序。直播主開英語節目時,中文觀眾可以即時睇到字幕;外語客戶打電話進來,中文客服亦可以一邊聽、一邊睇到對話內容。

LiveTranslate 屬於 Qwen3.8 系列下的語音功能延伸,目前支援普通話、英文等多語言之間互譯,亦可配合即時對話模式使用。Qwen.ai 用戶開啟 LiveTranslate 後揀選輸入與目標語言,便可以對住手機或電腦講話,螢幕同步顯示譯文。

Qwen 由阿里巴巴達摩院推出,屬於多語言、多模態大模型系列。LiveTranslate 的出現令 Qwen 在語音應用層面更貼近日常使用場景,而不限於純文字問答或文件分析。

重點摘要

  • Qwen3.8 新增 LiveTranslate 模式,主打邊聽邊譯、邊講邊出字幕
  • 語音輸入、翻譯、字幕生成整合在同一個模型流程內
  • 支援普通話、英文等多語言之間的即時互譯
  • 可用於跨語言會議、外語直播、客戶支援等場景
  • 透過 Qwen.ai 網站即可開啟試用,毋須額外安裝

項目主頁

Categories: 阿里巴巴, AI productions, 模型, 多模態模型, Qwen, API, Video, 語音

TypeSafe AI 推出 Jev:為軟件自動化而生的全新決策模型類別

你可以把它理解成專為自動化而設計的「函式呼叫模型」:接收未結構化狀態、輸出帶概率的型別安全決策,速度比通用 LLM 快兩個數量級。

Og image

TypeSafe AI 公開了首款 System One Model Jev,走出一條與通用聊天模型完全不同的路線。常見大型語言模型擅長生成自然語言,但要嵌入軟件流程就得花工夫解析、回傳值還可能出錯;Jev 索性放棄字串生成,把所有可能輸出預先定義成型別,模型只負責在這些選項之間做機率決策,因此不可能出現型別錯誤,也不會「講大話」。

這個模型採用平行取樣(parallel sampler),所有輸出分支一次過生成而非逐 token 推播,速度比同類智能水平的 LLM 快大約一百倍。訓練方法稱為 RLCD(Reinforcement Learning for Calibrated Decisions),目標是讓模型給出「知道自己有多肯定」的機率分數。

創辦人 Diogo Almeida 曾在 OpenAI 參與 ChatGPT 背後的研究,他指出 chat 模型爆紅多年,自動化領域卻幾乎沒有同樣突破,因此希望用專門為軟件決策設計的架構填補這個缺口。Jev 目前以早期試用形式開放,介面相當於一個「前沿智能函式呼叫」。

重點摘要:

  • 定位差異:放棄字串生成,只輸出預定義的型別安全結構化值,杜絕型別錯誤與幻覺。
  • 速度優勢:平行取樣設計令推理速度比同級 LLM 快約一百倍。
  • 訓練方法:採用 RLCD,著眼於校準過的機率分數而非人類偏好或可驗證獎勵。
  • 輸出形式:所有答案附帶置信度分數,方便軟件直接消化。
  • 存取方式:早期試用已開放,可透過官方網站加入候補名單。

項目主頁

Categories: 模型, 軟件, 安全, AGI

HyperFlow 自蒸餾影片生成省六成推論成本 – MiniMax-H3 八步出片

Video Rebirth 推出嘅 HyperFlow 係一個針對 MiniMax-H3 嘅 8 步 LoRA 適配器,透過 data-free flow self-distillation 將 50 步推論壓到 8 步,仲行得喺官方 diffusers Modular Pipeline 之上。

Repository image for Video-Rebirth/hyperflow

影片生成模型一直面對一個現實樽頸:想要更高品質,就要更多 sampling steps,亦意味住更長嘅等待同更高嘅運算成本。Video Rebirth 推出嘅 HyperFlow 就直接針對呢個取捨落手,喺 MiniMax-H3 官方權重之上加一個 8 步 LoRA(PEFT,rank/alpha 256,覆蓋 attention、feed-forward 同兩組 time embedder),將官方 50 點 sigma schedule 嘅 49 次前向推論壓到 8 次,而且唔需要額外訓練資料。

你可以把它理解成一個「加速層」:base weights、VAE、conditioner 同 t2va、fl2va、ref2va 三種 workflow(全部對應影片加音訊)都維持官方版本,呢個項目只負責載入 LoRA、兩個 time embedder 同固定嘅 8 步 sigma grid。官方修訂號、權重路徑、適用範圍等資料都收錄喺 hyperflow.json manifest 入面。LoRA 喺 Hugging Face 開源,授權沿用 MiniMax H3 Community License,呢個倉庫就提供 loader 同 example scripts,透過 hyperflow_blocks("fl2va") 等 API 直接接入 diffusers Modular Pipeline。

HyperFlow 嘅特點係 data-free:模型自己產生候選影片、篩走不合格嘅、然後用通過嘅樣本做 self-distillation,屬於佢哋 RSI(Recursive Self-Improvement)訓練範式嘅 self-distillation 部分。對比一般影片生成流程,呢種做法唔需要額外收集標註資料,亦唔需要人手標籤。實際運行時仲可以選擇加裝 NVIDIA Sol-Attn sparse attention(PyTorch ≥ 2.10、CUDA ≥ 12.8、Triton ≥ 3.6,支援 SM80–SM120),官方聲稱喺 H200 上比 dense attention 快約 13%,並可透過 Ulysses context parallel 擴展至最多 4 張 GPU。

對想用 MiniMax-H3 出片、又希望壓低推論時間嘅團隊或獨立開發者嚟講,HyperFlow 提供咗一個直接掛載嘅方案;對研究自蒸餾或自改進路線嘅從業者嚟講,佢亦係一個具體嘅開源參考。需要注意嘅係 num_inference_steps 唔應該手動指定,步數同 sigma grid 都由權重檔案內置決定。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視頻模型, NVIDIA, Video, Audio, Python, 庫, MiniMax

XGEN-JING 世界模型開源:邊走邊生成影片與音效

XGEN Labs 把互動式第一人稱世界模型 JING 開源:輸入動作與參考圖,就能邊走邊生成對應影片與環境音效,等於把世界模型變成可即時體驗的 demo。

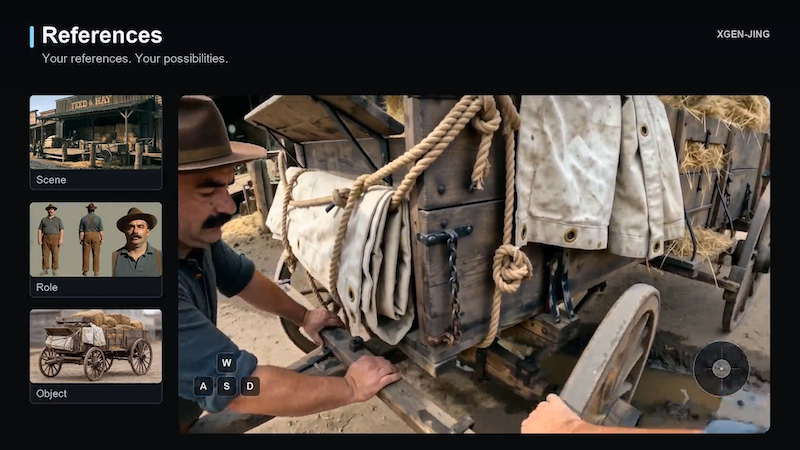
過往的世界模型 demo 多半停留在「按一個鍵播一段片」,XGEN-JING 想把互動感再推一步:鍵盤操作鏡頭、輸入文字引導角色對話,模型即時生成第一人稱影片與配對音訊,並以參考圖約束人物、物件與場景的一致性。這個項目是一個以 MiniMax-H3 為骨幹的 egocentric interactive experience 模型,屬於世界模型 / 互動影片生成一類,目標是讓「在同一個起點做出不同選擇」這件事變得可視聽。

XGEN-JING 的核心差異在「四步雙向推論」與即時性:JING-Flash-v1 用四個步驟完成推論,再把動作、觀察歷史、參考圖同時餵進去生成下一段片段;鏡頭移動、物件互動、人物對話都由文字與按鍵驅動,而畫面與聲音同步輸出,所以更像「邊走邊生成」而不是「先想好再剪片」。

Step Into a World That Responds | XGEN Labs

這版本同時提供 Inference code、examples 與 Prompt skills,後者可以從故事與參考圖自動生成經過驗證的推論案例,降低試錯成本;但因果模型與技術報告尚未釋出,想深入架構細節的人需要再等等。硬件門檻亦偏高:項目方以六張 H100 做驗證,其中一張跑 text encoder、一張跑影音 VAEs、四張跑 DiT 加 sequence parallelism,並指定 FlashAttention-4 為預設後端。

以下幾類人會比較快從中受惠:做世界模型研究、需要互動 demo 的研究者;做遊戲 / VR / 沉浸式敘事、需要快速產出第一人稱體驗的開發者;以及關心 video generation xa in 2026 路徑、想理解「影片 + 音訊 + 動作」三軸如何耦合的團隊。對一般玩家或創作者而言,Hugging Face 上的模型頁與 xgenlabs.ai gallery 已足夠先看 demo,再決定是否投入本地部署。

重點摘要

  • JING 是以 MiniMax-H3 為基礎的第一人稱互動體驗模型,支援鍵盤控鏡、文字對話與參考圖約束。
  • JING-Flash-v1 以四步雙向推論同時生成影片與音效,比單向生成更貼近即時體驗。
  • 官方硬件門檻為六張 H100(1 text encoder + 1 VAEs + 4 DiT),預設 FlashAttention-4,後端依賴 SGLang 特定 commit。
  • Prompt skills 可從故事與參考圖自動產生驗證過的推論案例,方便快速試玩法。

項目主頁 · GitHub · 模型 · 影片集

Categories: 開源, AI productions, 模型, 視頻模型, 世界模型, Google, NVIDIA, Video, Audio, Content Creator, MiniMax, Skill 技能

WeVisDoc 騰訊文件圖片的端到端解析模型

騰訊 WeChat Vision 團隊開源 WeVisDoc 系列文件解析模型,以「先擴廣覆蓋、再針對性補強」的兩階段訓練框架,在 OmniDocBench v1.6 與多個 PureDocBench 軌道同時刷新端到端解析器紀錄。

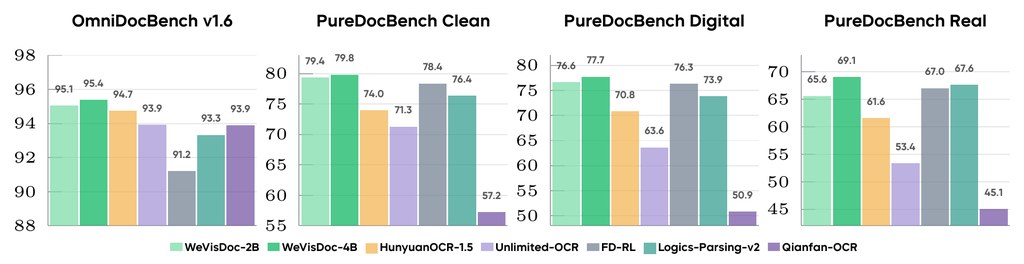
WeVisDoc-4B leads the compared end-to-end parsers across all four reported settings.

當一份文件同時夾雜模糊掃描、手寫註記、複雜表格與數學公式時,多數 OCR + 版面分析的流水線都會在交接處出錯——模型間責任不清,錯誤層層放大。騰訊 WeChat Vision 團隊開源的 WeVisDoc 系列正正針對這個痛點,把「文件頁 → 結構化 Markdown(含 LaTeX 公式、HTML 表格)」收進單一端到端模型,避免不同模組互相推卸責任。

WeVisDoc 推出 2B 與 4B 兩款模型,皆以 Qwen3-VL 為基座微調而成,覆蓋文字、公式、表格與閱讀順序四個維度。訓練方法分兩階段:Stage I 先擴大語義、結構、外觀三方面的數據覆蓋;Stage II 則用殘差診斷找出 Stage I 仍出錯的樣本,針對性地補充與重新分配訓練數據。這套做法與單純堆數據量的路線不同——它把精力集中在模型最容易跌倒的角落。

在 OmniDocBench v1.6 上,WeVisDoc-4B 取得 95.38 的 Overall 分數,三條 PureDocBench 軌道的平均分為 75.54,均為目前端到端解析器的最佳成績。在更貼近真實擷取條件的 PureDocBench Real(模擬四次實體拍攝劣化)上,相對次強基線仍拉開 1.44 分,是四個比較場景中差距最大的一項,正好對應 Stage II「在真實擷取最難看的外觀變化上獲得最大增益」的設計初衷。

對需要把大量歷史紙本文件、學術論文、表格報表轉成結構化內容的研究團隊與企業來說,WeVisDoc 提供了一個開源、可在本地用 GGUF 等格式部署的小模型選項。模型現已上載 Hugging Face,並附技術報告與互動式 Recovery Lab,方便逐頁對比 Stage I 與 Stage II 修復了哪些具體錯誤(例如被漏掉的 9×9 數獨格線)。

  • 騰訊 WeChat Vision 團隊開源的端到端文件解析模型,2B/4B 兩個規模,皆基於 Qwen3-VL 微調
  • 兩階段「數據中心」訓練框架:Stage I 擴大覆蓋、Stage II 以殘差診斷針對性補強
  • 輸出結構化 Markdown,內含 LaTeX 公式與 HTML 表格,涵蓋文字、公式、表格、閱讀順序四維度
  • WeVisDoc-4B 在 OmniDocBench v1.6 與三條 PureDocBench 軌道均居端到端解析器首位
  • 開源釋出模型權重、技術報告與互動式範例頁,方便逐頁審視修復效果

項目主頁 · GitHub

Categories: 開源, 騰訊, 模型, 模型訓練, Qwen, 框架, Dataset 數據集

[技術文章] DeepSeek-V4.1-Flash 百萬上下文 KV Cache 壓到四分之一

百萬 token 上下文背後最大的成本壓力來自 KV cache。DeepSeek-V4.1-Flash 用 CED 架構配合 CSA2,將每個 token 的記憶體用量壓到大約 890 bytes。

Hero image preview

長文 agent 跑得愈久,KV cache 累積得愈快,HBM 容量、頻寬、SSD 傳輸成本幾乎同步飆升;DeepSeek 團隊認為,這才是 scaling down 長上下文部署成本的主要瓶頸,而不單是推論計算本身。

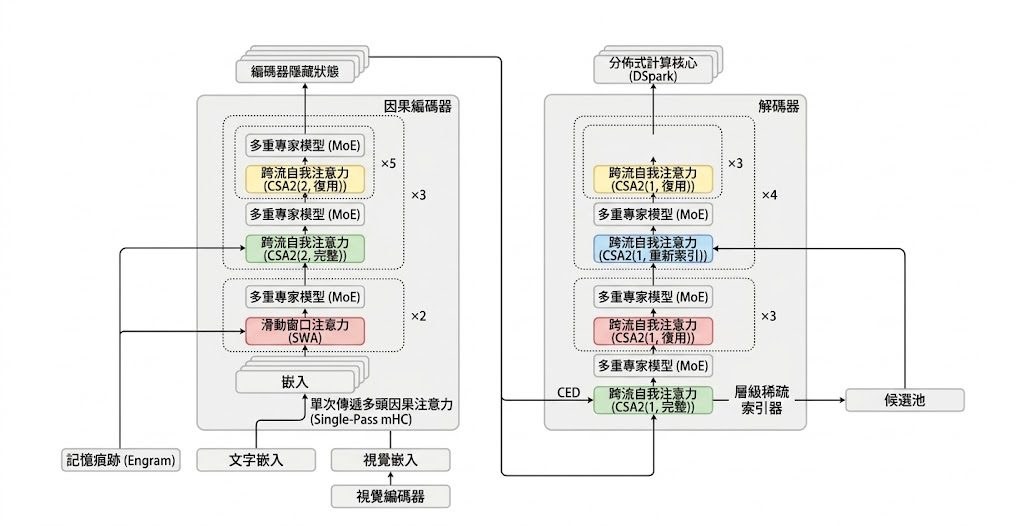
為處理這道難題,DeepSeek-V4.1-Flash 採用 Causal Encoder-Decoder(CED)架構:prefill 階段啟用 8B 參數,decode 階段啟用 16B 參數,讓輸入極長但輸出相對短嘅 agent workload 成本結構更友善。Backbone 規模去到 552B,並支援長達一百萬 token 嘅上下文。

記憶體方面,Compressed Sparse Attention 2(CSA2)加入跨層 KV cache reuse 與分層稀疏 indexer,再搭配 FP4 KV cache,使常駐 HBM 嘅 global KV cache 降到每個 token 約 890 bytes,相對 V4-Flash 縮減約四倍、相比 V1 更達到 437 倍幅度。透過 SWA Bounded Replay 部署優化,落在 SSD 或 host memory 嘅 persistent footprint 更壓到大約 V4-Flash 嘅八分之一。即使 cache 大幅縮減,模型在 agentic 基準上仍比 baseline 表現更好。

預訓練採用 45T token 嘅多模態語料,後訓練亦經過完整流程,使 V4.1-Flash 在文本與多模態 agent 場景都保持穩定輸出。模型 checkpoint 已於 Hugging Face 開源,可供社群自行部署驗證。

  • 552B 參數 MoE 骨幹,支援 100 萬 token 上下文。
  • CED 架構令 prefill 僅啟用 8B 參數、decode 啟用 16B 參數。
  • CSA2 + FP4 KV cache 將 global KV cache 壓至 890 bytes/token。
  • SWA Bounded Replay 進一步將 persistent KV cache 降至 V4-Flash 約 1/8。
  • 45T token 多模態預訓練 + 完整後訓練,agentic 表現優於前代。

Paper

Categories: 開源, 模型, DeepSeek

GPT-Policy 把 VLM 變現場教練

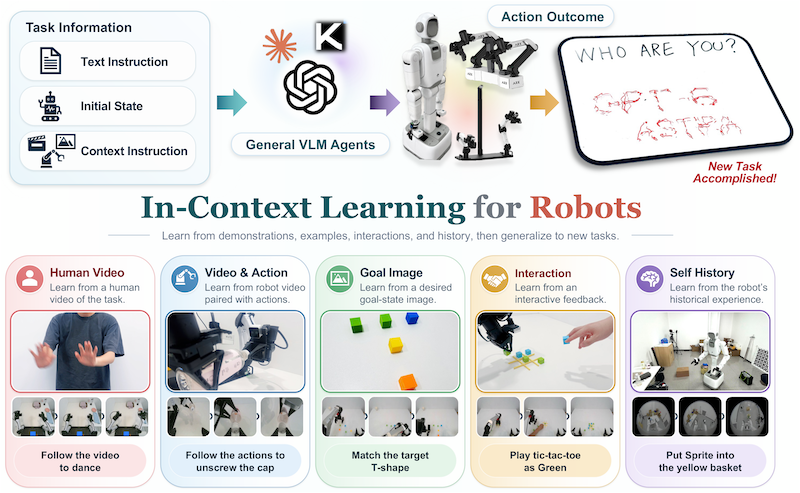
GPT-Policy 讓固定的視覺語言模型在現場讀懂示範影片、目標圖與互動回饋,直接輸出可執行的機械臂動作,省去微調與重訓成本。

GPT-Policy wordmark

機械臂要適應新任務,傳統做法往往是收集大量數據再微調模型,成本高且迭代慢。GPT-Policy 走另一條路:保留一個固定的視覺語言模型(VLM)作為決策核心,現場把任務指令、示範影片、目標圖像、過往觀察與執行回饋打包成單一輸入,讓模型一次輸出一個結構化動作請求,再交給專屬的硬件適配器(adapter)驗證並執行。

的關鍵在於「context compiler」與「constrained controller」的分工。前者負責保留示範中與任務相關的視覺轉折,後者則檢查動作是否安全、可執行,並回報結果給 VLM 進入下一輪決策,整個過程沒有梯度更新,也不需要為新任務調整參數。對於 ARX X5 與 I2RT/YAM 兩款機械臂平台,項目已提供對應的適配器,支援笛卡兒目標、waypoint 序列、順序 IK 檢查、夾爪控制,以及 append-only 的運行記錄,方便日後追溯。

從結果來看,團隊在真實機械臂試驗中發現,即使只有人類影片而無機械臂動作標記,GPT-Policy 仍能改善任務完成率;若加上對齊的動作參考,表現會進一步提升,尤其在接觸敏感的任務上更明顯。對比同類做法,GPT-Policy 沒有走端到端策略網絡的路線,而是把通用 VLM 的推理能力當作即插即用的策略模組,取捨是更依賴適配器與閉環回饋的工程品質。

適合使用的場景包括:研究 VLM 與機器人結合的團隊、需要快速讓機械臂適應新任務示範的實驗室,以及想評估「不重訓」路線可行性的工程團隊。目前的限制在於硬件覆蓋仍集中在兩款臂,且效能高度取決於上下文編譯器能否保留關鍵視覺資訊。

重點摘要:

  • 固定 VLM 即決策核心:不微調、不重訓,靠現場上下文即時生成動作
  • context compiler + controller 雙層架構:前者保留任務相關視覺轉折,後者驗證並執行
  • 支援 ARX X5 與 I2RT/YAM:提供笛卡兒目標、IK 檢查、夾爪控制等適配器
  • 人類影片已能改善任務成功率:對齊動作參考後表現更穩,尤其接觸敏感任務
  • 定位為研究框架:適合探索通用模型在實體機器人上的即時學習能力

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, Video, Image, 影像處理, Robotic, 框架, 安全

PANORAMA 把場景描述逐個詞對應到像素

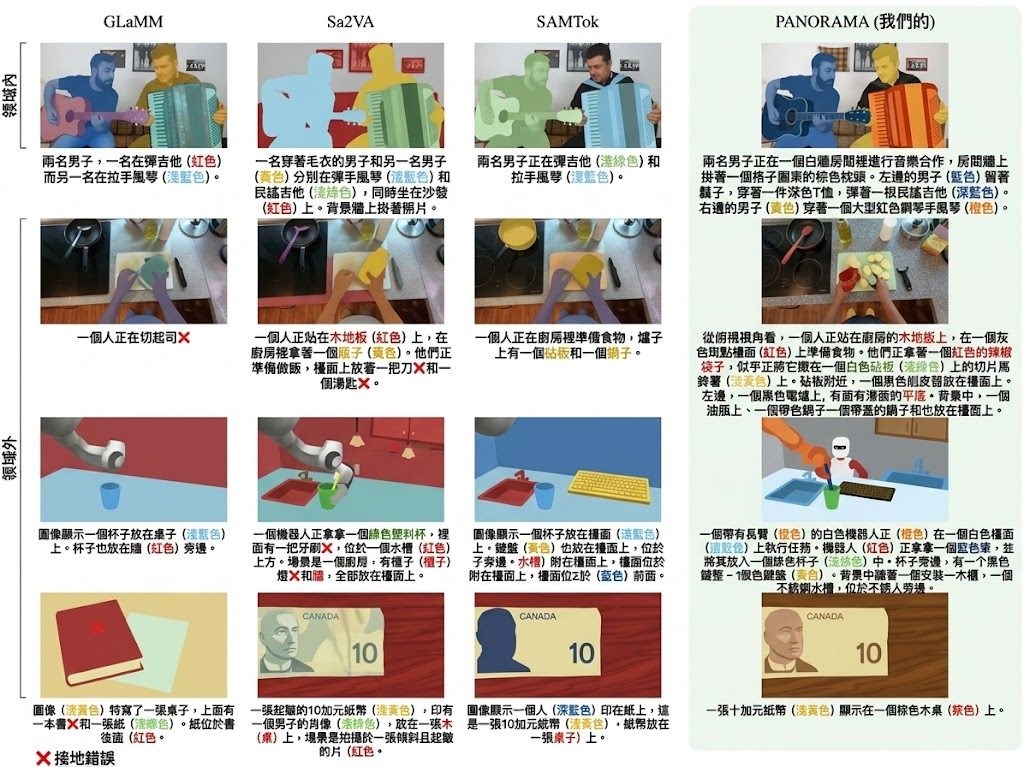
Inria 與捷克理工合作開源的 PANORAMA,能為整個場景生成描述並把每個實體精確對應到像素遮罩,並同步釋出近全幅覆蓋的人工標註基準 PanoCaps。

PANORAMA compared with prior grounded captioning models, in and out of domain

現時的視覺語言模型(VLM)寫得出漂亮描述,卻往往無法把句子裡的物件真正對到像素,導致「說的是一回事、畫出來又是另一回事」。PANORAMA 想處理的是 panoptic grounded captioning:模型要不只描述前景物件,還要連背景區域都講清楚,並為每個提到的實體給出像素級遮罩。

做法上,它把短語定位(phrase grounding)重新定義成「從短語條件化的遮罩提案池中挑選」。預訓練分割器根據每個短語的上下文表徵生成候選遮罩,模型再從中選出真正對應的那一塊,無論是單一區域、多個實例,或根本沒有對應都涵蓋在內。這樣把分割與語言生成用同一介面聯合訓練,文字與遮罩就不再各說各話。

配套資源同樣在 Hugging Face 公開:PanoCaps 約有 3.5K 張圖片、34K 個遮罩和 17.9K 條獨立短語,參照區域覆蓋近 99% 像素;COCONut-PanCap-Recaptioned 提供 118K 張訓練圖的重新標註;MRSeg-Referring-Expressions 則帶來約 101K 條改編自 SegLLM 的單輪指代表達。評估端還提出 generalized Panoptic Quality(gPQ),把文字與遮罩的一致性納入單一指標。實驗結果顯示,PANORAMA 在 PanoCaps 上整體定位表現最佳,並在多個像素級任務上與專門模型持平或更強。

這個項目適合以下情境:

  • 做機器人感知或場景理解的研究團隊:需要模型同時提供自然語言描述與實例級遮罩,減少對接多個模型的成本
  • 訓練數據匱乏的多模態團隊:PanoCaps 與兩份重新標註集合計逾十萬張圖,可直接用作訓練或微調
  • 需要精細指代(referring expression)任務的工作:MRSeg-Referring-Expressions 提供多粒度指代表達,比單一句式更有助泛化
  • 對 VLM 評測有疑慮的研究者:gPQ 指標把文字與遮罩綁定,避免「描述漂亮但對錯位置」的高分陷阱

對想直接跑實驗的人,訓練、微調與評估程式碼已隨倉庫釋出;模型權重則透過 Hugging Face 取得。如果你關心的是 VLM 能否真正「看懂」場景而不只是寫句子,這套統一框架比多數把描述與分割拆開處理的方案更接近落地需求。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Image, 框架, 庫, Dataset 數據集

ActionPiece:設計動作分詞器,幫機械人學得更穩

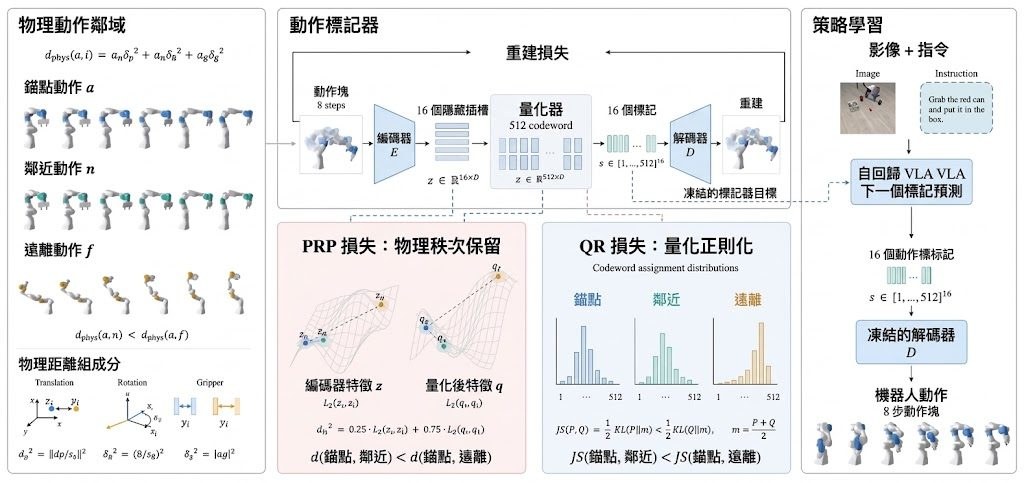
可以把 ActionPiece 理解為一個專給視覺語言動作模型用的動作編碼器,特別針對自回歸生成時動作細節流失的問題,強調保留物理距離的先後關係。

DeepCybo, Zhongguancun Academy, and Zhongguancun Institute of Artificial Intelligence

當自回歸視覺語言動作模型(VLA)把機械人動作切成離散 token 再一個個吐出來,最大的隱性成本往往不是單一動作的誤差,而是相鄰動作之間的物理距離被打亂。ActionPiece 正是針對這個卡位設計:它把動作切成一塊八步的短序列,每塊壓成 16 個離散 token,並要求 tokenizer 不只重建動作,還要保留「物理排序一致性」(physical rank consistency, PRC)。換句話,兩個本來很接近的動作,編碼後的距離也要維持接近;兩個本來很遠的動作,編碼後也要維持較遠。這種監督讓 token 表徵本身帶有物理結構,而不是純粹的重建損失。

在 Libero、Libero-Plus、SimplerEnv 與 VLA-Arena 四組基準上,ActionPiece 配合 Qwen3-VL-4B 作為策略骨幹,跑出 94.8%、68.8%、71.9%,以及 VLA-Arena L0 至 L2 平均 51.5% 的成功率。Libero-Plus 的訓練刻意排除其示範數據,因此這項成績更能反映遷移表現,而不是單純記住示範。從結果可以看到,重建保真度與 PRC 之間並非完全等價:有些 tokenizer 重建得很好,但鄰近關係一塌糊塗,部署成功率也跟著掉。ActionPiece 把「物理排序保留」與「碼字分配的量化正則化」綁在一起訓練,正好同時壓住這兩個問題。

這個項目的實際意義,是給正在做 VLA 研究的團隊一個可直接替換的動作 tokenizer,無需重寫策略架構。對關注 SimplerEnv 真實遙操作或 VLA-Arena 跨平台泛化的工程師來說,這類保留物理關係的分詞方式,會比純重建式 tokenizer 更貼近控制任務的需求。PhysBrain 1.5 也採用了 ActionPiece 作為動作 tokenizer,顯示它已不只在論文層面,而是走進實際模型發佈。

要真正評估它,比較合理的做法是把它接進自己的 VLA 流程,比對換 tokenizer 前後的策略成功率與 PRC;單看 Libero 94.8% 容易被低估,因為重建誤差小的 tokenizer 不一定保留鄰近結構。原始程式碼與 PhysBrain 1.5 的權重將在官方頁面釋出,想搶先試的人可以先讀論文並鎖定後續更新。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, VLA, Robotic, Dataset 數據集

Page 18 of 55
1 … 16 17 18 19 20 … 55