Confucius4-T3PO:14B 即時翻譯模型,邊聽邊譯並兼顧延遲

逐段輸入文字後,模型以 AI 判斷何時繼續等候、何時輸出譯文,減少即時翻譯必須在速度與語境之間二選一的情況。

Confucius4-T3PO

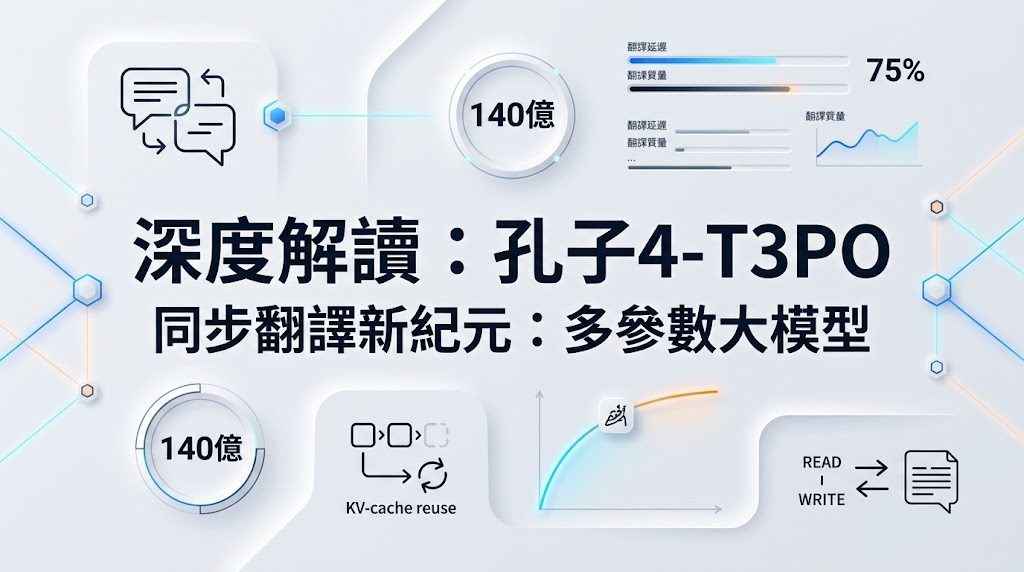
會議口譯或直播字幕需要盡快顯示譯文,但太早翻譯又可能欠缺上下文。Confucius4-T3PO 是一款 140 億參數的文字即時翻譯模型,接收細粒度文字片段後,會決定繼續等候還是輸出部分譯文,支援中英互譯。

它以 READ/WRITE 決策控制等待與輸出,並提供不同延遲模式,讓使用者按即時性需要調整速度與翻譯質素的取捨。已提交的譯文只會逐段追加,不會回頭改寫;交錯式歷史紀錄亦可重用 KV cache,減少重複計算。模型以 Qwen2.5-14B 為基礎,經串流翻譯冷啟動及 Pareto-aware 強化學習,兼顧翻譯質素與延遲。

模型本身只處理文字,並不原生接收語音。語音翻譯需要串接串流自動語音辨識(ASR);項目另有 R2T2 ASR 模型,可組成語音轉文字翻譯流程。推理介面包括逐段文字翻譯 API,以及接收 16 kHz 單聲道 PCM16LE 音訊的 WebSocket 串流示範。

  • 適合需要逐步顯示字幕或翻譯結果的串流應用及口譯流程。
  • 可按低、原生或高延遲模式調整輸出節奏;延遲與翻譯質素需要取捨。
  • API 可查詢分段統計及 WAIT/TRANS 統計,方便觀察單次工作階段的決策情況。
  • 儲存庫提供推理程式碼,並連結模型頁及線上示範;所列資訊未提供硬件需求或效能基準,正式部署前宜先測試目標語言、音訊流程及延遲。

對字幕平台、遠端會議及串流口譯團隊而言,逐段輸出有助減少等待完整句子才見到譯文的落差;但語音流程仍依賴外部 ASR,部署成本亦會受 14B 模型及推理環境影響。
GitHub · 模型

Categories: 開源, 模型, Qwen, API, Audio, 語音

Meridian 讓 MiniMax H3 將時間與鏡頭重新編排 – Bullet time

Meridian 可從影片或單張圖片重新設計鏡頭路徑,重訪同一事件的不同視角。

Og image

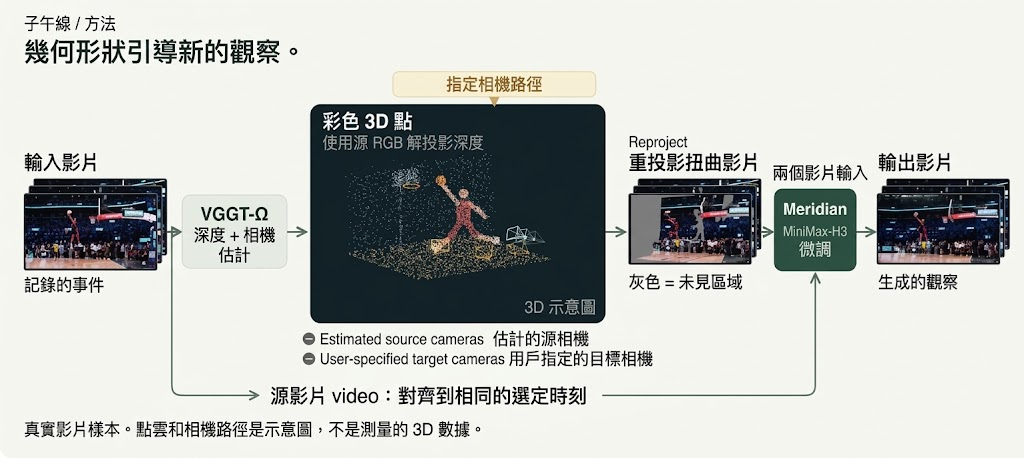
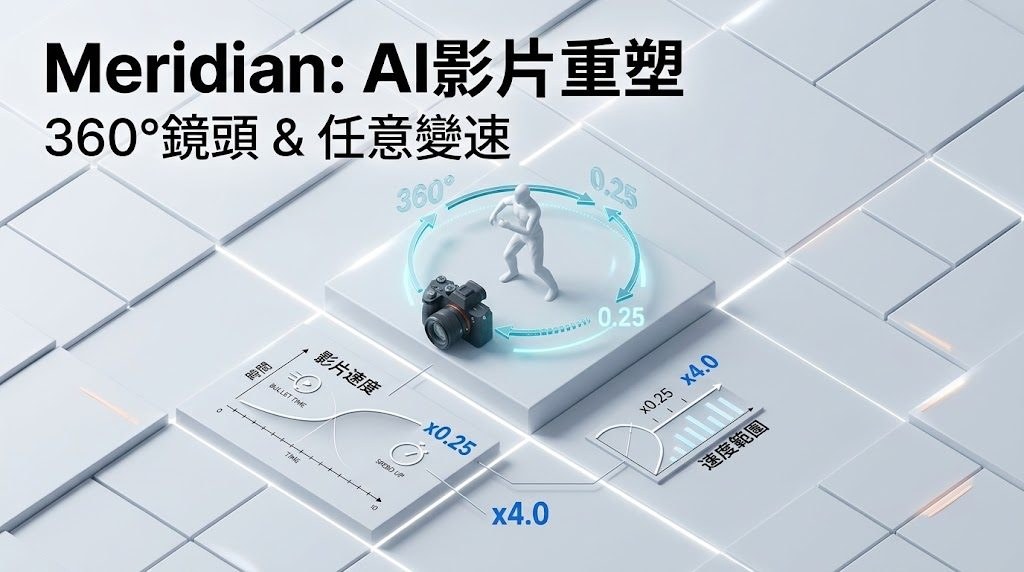
想將一段已拍攝的動作改成全新鏡頭,甚至暫停某個瞬間再繞行拍攝,Meridian提供了影片到影片(video-to-video)的處理方式。它基於 MiniMaxAI/MiniMax-H3,以 adapter 形式加入幾何控制能力,並結合 VGGT-Omega 幾何資訊,亦支援由單張圖片建立鏡頭移動。

Meridian 處理的是空間與時間的共同編排:鏡頭可沿指定路徑移動,原有動作則可繼續、放慢或暫停。Bullet time 只是其中一種時間與鏡頭組合,並非模型的邊界;要加快或放慢動作,應先重新調整輸入影片的時間,再按該時間軸設計 camera path。

頁面提供的例子包括以原片重新觀看 NBA 灌籃、在草莓片段中暫停動作並移動鏡頭,以及以芭蕾單張相片產生鏡頭運動。這種做法適合重構已有事件的觀察角度,但生成畫面與原片如何銜接、遮擋區域能否保持一致,仍取決於輸入內容與指定路徑。

  • 基礎模型:MiniMaxAI/MiniMax-H3;模型關係標示為 adapter
  • 幾何元件:VGGT-Omega
  • 任務標籤:video-to-video、novel-view-synthesis、camera-control、re-camera
  • 提供 installation.md 連結

項目主頁 · 模型

Categories: 開源, AI productions, 模型, 視頻模型, Google, NVIDIA, Video, Image, 框架, 教學, Discord, LLaMa, Ollama, Python, 蘋果, MiniMax

Segment-Snap:讓 AI 看懂3D 場景怎樣開門

由室內3D掃描推斷可動部件、運動方式和把手位置,Segment–Snap把幾何線索與語義判斷接在同一條流程內。

Paper on arXiv

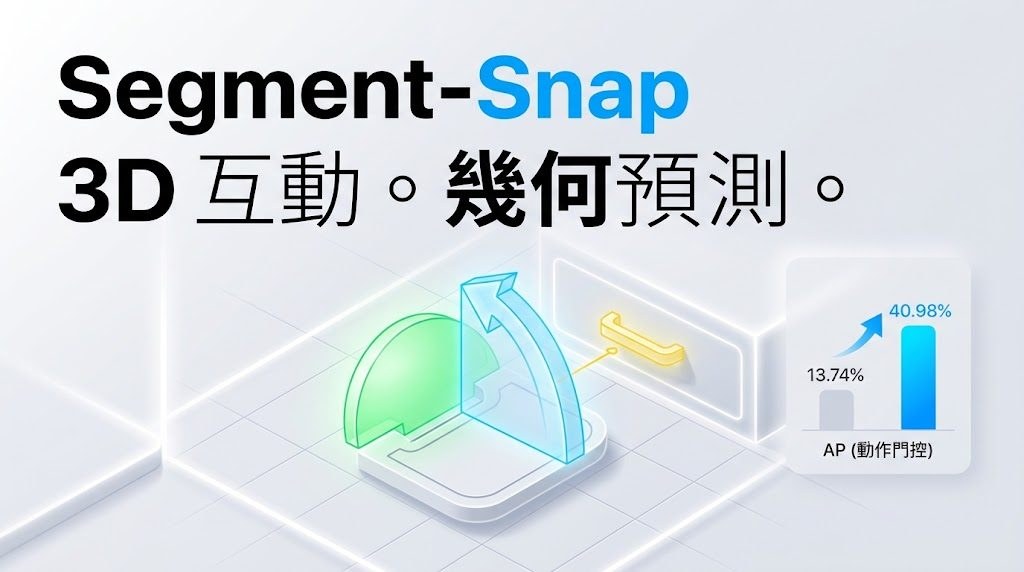
一張室內3D掃描不應只告訴你有門櫃,還要指出哪個部件會動、沿甚麼方向移動,以及人應在哪裏操作。Segment–Snap 屬於3D場景互動理解模型,處理的正是可動部件、運動類別、鉸鏈位置和把手之間的關係。

項目採用三個獨立訓練的 predictor 讀取同一個 RGB point cloud:Movable-part predictor 負責部件分割及旋轉、平移類別;Dense handle predictor 尋找細小把手;Joint part-handle predictor 再提出與部件相關的把手候選。把手位置會協助判斷旋轉部件的鉸鏈線,部件的幾何和類別則反過來改善把手標籤,兩個方向各行一次,沒有迭代式 feedback。

固定的 training-free decoder 會為可靠部件支援擬合方盒,利用垂直軸先驗推斷旋轉,並以表面法線處理平移;這令模型毋須另行訓練 motion regression。Joint predictor 的 parent parts 只作內部脈絡,最終輸出仍以獨立 Movable-part predictor 的部件結果為準,取捨相當清楚。

• Handles → part motion +27.25 個百分點,主要改善 hinge placement
• Parts → extra handles +5.01 個百分點,補充把手 proposals
• Part classes → handle labels +0.98 個百分點,修正部分 motion-class 判斷
• 三項結果來自 Articulate3D validation,指標為 motion AP 或 handle AP,增幅不可直接相加

測試時可按資料準備文件處理場景,再使用 Hugging Face 提供的 pretrained checkpoints 和 repository 內的 training configurations,重現公開 Articulate3D validation 實驗。項目較適合研究3D視覺、機械人感知、具身互動或需要分析門櫃等室內物件操作方式的團隊;它提供的是研究參考實作,並非可直接接駁家居控制系統的完整產品。

項目主頁 · GitHub · 模型

Categories: 開源, 香港理工大學, 模型, 模型訓練, 香港, 3D

Mira-Scene 單張圖片重建可編輯 3D 場景,讓畫面變成可拆解空間

Mira-Scene 將單張圖片拆成物件、深度與環境,再組合成可編輯 3D 場景,降低由 2D 畫面建立空間內容的門檻。

Mira-Scene teaser

由一張圖片開始,Mira-Scene 能分辨場景內的物件、估算深度,再為各物件建立網格並組合成可編輯 3D 場景。它屬於單圖 3D 場景重建模型與推理項目,處理的是影像缺乏空間結構、物件難以獨立編輯的問題,適合概念設計、虛擬場景和後續模擬工作。

完整流程包括互動式 instance segmentation、monocular depth estimation、canonical coordinate map(CCM)、voxel prediction、逐物件 mesh generation、支援物件接觸關係的 scene assembly,以及 environment-map generation。Hugging Face 提供的 CCM diffusion checkpoint 只負責其中一個階段,並不是可直接輸出 GLB 的獨立 image-to-3D 模型;分割遮罩、mesh backend 和場景組裝階段仍要配合使用。

Mira-Scene 採用分階段推理,支援中斷後繼續執行、多個深度及網格後端,亦可按個案分配多張 GPU。使用者可依照中文 inference、visualization 和 evaluation 指南準備輸入圖片及遮罩,再檢視各階段產物;訓練程式碼和示例訓練數據仍列在待辦事項,研究用途以外需要自行處理環境和模型資源。

• 單張圖片重建可拆解的 3D 場景
• 以 CCM 和稀疏 voxel 表示物件空間結構
• 對比 SAM3D,3D-IoU 為 0.727,較 0.520 高
• 部分指標領先,但 EMD 略遜於 SAM3D
• 開源推理流程完整,訓練部分尚未公開

評測表中,Mira-Scene 使用 80k 規模、全自動流程的數據,CD、FS@0.1、3D-IoU、ICP-Rot、2D-IoU 和 ADD-S 均優於 SAM3D;EMD 則為 0.169,稍高於對方的 0.163。這反映它在整體形狀、投影對齊和姿態誤差上具競爭力,但不能把單一圖片重建視為完整真實世界掃描,遮擋、不可見背面和網格後端仍會影響結果。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 模型, 視覺模型, 模型訓練, NVIDIA, Image, 影像處理, 3D, 蘋果

OmniEdu 把課程理解帶進 AI

OmniEdu 不只回答題目,還會對照課程、診斷學習缺口,再決定下一步應給提示、提問或講解。

Repository image for haolpku/Omni-Edu

學生卡在一道題目時,答案本身未必足夠,真正需要的是知道漏了哪個前置概念,以及下一步應怎樣學。OmniEdu 屬於開源多模態模型家族,處理 K–12 學習與教學流程,將課程對應、解題、學習診斷和教學支援放在同一套模型內。

模型以 Qwen3.5-4B-Base、Qwen3.5-9B-Base 和 Qwen3.8-27B 為基礎,推出 4B、9B、27B 三個 checkpoint。訓練資料包括 69,999 個 instruction examples、15.96M supervised response tokens,當中 60,951 個屬教育專用資料,涵蓋超過 100 個來源;模型亦支援圖片等多模態輸入,能把問題、知識點、年級、先修關係和課程證據連繫起來。

可下載的權重和資料集適合教育研究團隊、教材平台,以及需要本地模型作學習分析的開發者;4B 較適合本地試驗,9B 和 27B 則提供更高能力但需要更多硬件資源。模型可透過 Transformers 或 vLLM 執行,公開配置使用 Qwen3_5ForConditionalGeneration,訓練序列長度為 32,768 tokens。

  • OmniEdu-27B 在 16 個模型比較中,取得 K12-Bench EM 63.12% 和 F1 76.69%,兩項均列第一。
  • OmniEdu-27B 在 MathFish 達 85.89% 準確率,並取得 LongTutor 3.02 教學分數。
  • EDUMATH MaC 為 86.95%,MathTutorBench Scaffold win rate 為 78.74%,兩項均列第二。
  • 模型的差異不只在答對題目,而是嘗試判斷誤解、缺失的先修知識,再選擇提示、引導問題、複習或解釋。

OmniEdu 的取捨也很直接:全參數 supervised fine-tuning 和長序列訓練有助整合教育情境,但 27B checkpoint 對硬件要求較高,模型的教學判斷亦應配合教師審核。對只需要一般問答的工作流程,它可能過於專門;對重視課程對齊和個別學習支援的團隊,公開權重與資料集則提供了可檢查、可延伸的起點。

項目主頁 · GitHub

Categories: 開源, 北京大學, 模型, 多模態模型, 模型訓練, Image, 教學, Dataset 數據集

YuE2 補上真實音訊 Tokenizer,支援歌曲翻唱微調

YuE2取得音訊編碼與真實錄音適配能力,可將自家錄音轉成語義碼,再微調歌手風格。

Og image

當你餵給 YuE 一段參考音訊(例如某歌手的演唱片段或特定樂器風格,要求接續生成)時:必須先用 Tokenizer 將參考音訊「壓成代碼」傳入模型。若 Tokenizer 品質不佳,音色在第一步壓縮時就失真了。

這個 v4 工具能更高保真地將輸入聲音轉為 Token,讓後續模型捕捉到的音色特徵更貼近原音。

錄音轉換、歌手風格微調和歌曲翻唱,原本受限於 YuE2 沒有隨附的 audio → semantic-token encoder。這個項目基於 m-a-p/YuE2-3B 及 m-a-p/MERT-v2-FullSong,加入音訊 Tokenizer 與 NAR-branch LoRA,讓 YuE2-3B 可以處理自家錄音,並以真實製作音訊調整解碼效果。

Tokenizer 取用 MERT-v2-FullSong 第 20 層特徵,先按音軌作 instance normalization,再以 8 層、d=512 的 Transformer,在 512-frame 視窗內轉換成 32,768 種 YuE2 semantic codes,特徵率為 25 Hz。留出歌曲測試的 top-1 exact match 為 16.1%,但近似 code 產生的聲音接近,NAR round-trip 聽感測試約達 95%。

  • tokenizer_head_joint_v4.pt、.safetensors、.bf16.safetensors:音訊編碼 head
  • nar_lora_joint_v4.pt、.safetensors、.bf16.safetensors:NAR 解碼分支 LoRA
  • _comfyui.safetensors:配合 ComfyUI 的 YuE2 權重布局
  • LoRA rank 為 32,覆蓋 28 層 NAR attention、MLP,以及完整替換的 vae2llm 和 llm2vae

.bf16 版本約為完整精度檔案的一半,head 與 fp32 的輸出一致率為 98.6%。項目附有 scripts/ckpt_io.py、訓練迴圈和推論腳本;ComfyUI 可把 LoRA 載入 YuE2 checkpoint 的 MODEL 輸出,強度設為 1.0,CLIP 輸入不受影響。頁面沒有提供 GGUF 檔案、檔案大小、上下文長度、Ollama、LM Studio、llama.cpp 或 MTP draft speculation 支援資料,亦沒有列出可供選擇的量化級別。

模型先以 4,765 首 YuE2 自行生成歌曲訓練,再適配真實音訊;因此它的價值集中於提升真實錄音的編碼與 NAR 解碼,而非取代 YuE2-3B 的完整生成能力。授權為 CC-BY-NC-4.0,商業用途需要另行確認授權條件。

模型

Categories: 開源, ComfyUI, 模型, 模型訓練, Audio, 工具, 廣東話, Tokenize

Grounded-Action-Model:讓機械人先理解物件位置,再決定如何動作

Grounded Action Model 把語言、點和框選提示轉成同一套 3D 物件表示,提升機械臂面對場景變化時的穩定性。

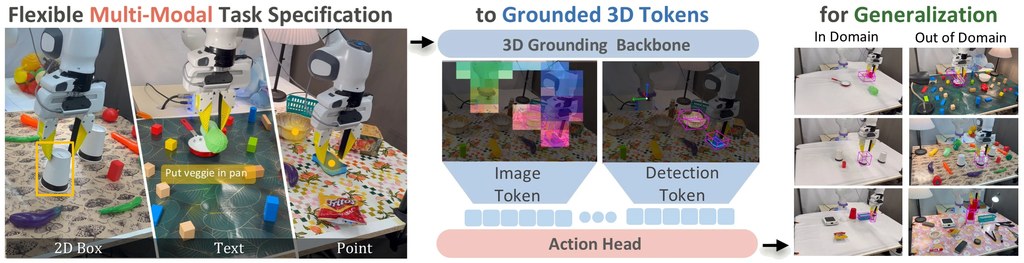
A language instruction, a 2D point or a 2D box is resolved by a pretrained 3D grounding model into image tokens and dete

面對物件被移位、場景重新排列,機械臂未必只需要更長的指令,而是要準確知道目標在哪裏。Grounded Action Model(GAM)屬於機械人基礎模型,透過 3D grounding 將語言、2D 點或 2D 框選轉成同一套以物件為中心的觀察,再預測連續動作。

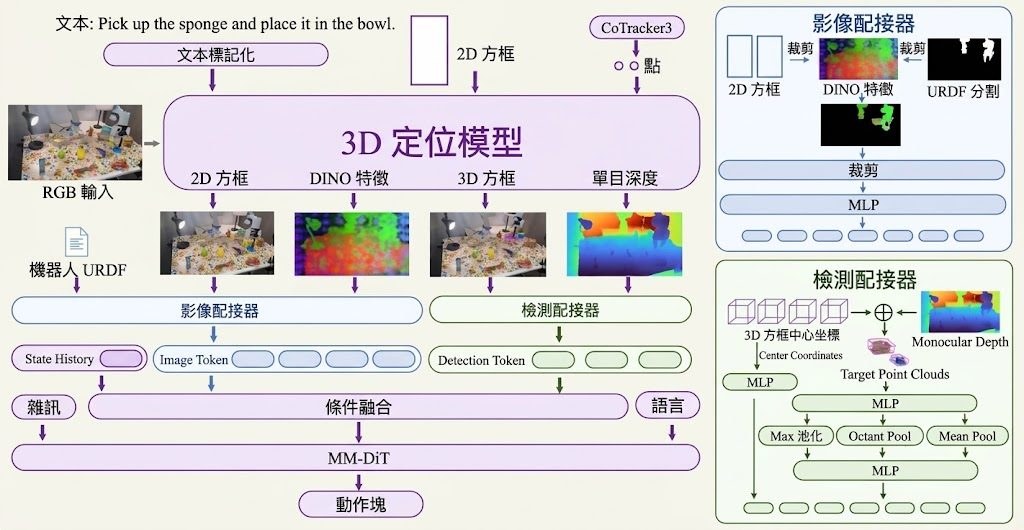
GAM 使用凍結的 promptable 3D detector,提取目標物件的視覺特徵和 metric geometry,並與機械人狀態歷史交給 multi-stream transformer,輸出 action chunks。相較於由 Vision-Language-Action Models(VLAs)或 World-Action Models(WAMs)從示範中隱性學習位置關係,GAM 把 3D 位置直接放進控制流程,也可由高層 planner 透過不同提示方式控制,支援較長流程和需要記憶的操作。

A language instruction, a 2D point or a 2D box is resolved by a pretrained 3D grounding model into image tokens and dete

目前可參考的結果包括:
– RoboTwin 2.0 的 50 項任務平均成功率為 55.3%,場景隨機化時為 47.6%。
– LIBERO-PRO 的 16 種擾動設定平均成功率為 61%,目標重新放置時改善較明顯。
– 雙臂 YAM 面對視覺變化仍成功 17/20 次;Franka 配合 Molmo2 planner,長流程任務的 OOD step completion 為 49.8%。

Grounded-Action-Model 適合研究機械人操作、視覺變化和高低層控制協作的團隊,但目前 GitHub 仍只有論文與項目頁面,training and inference code、pretrained checkpoints 及 real-robot setup 尚待公開,因此暫時不能按儲存庫直接安裝或重現結果。數據主要來自指定基準和兩款機械人,能否延伸到其他硬件與未見過的操作,仍要等待程式碼及更多測試。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, 微軟, VLA, World-Action Model, Robotic, 3D, 庫

physics:拆解 Wan2.1 的物理失誤

籃球彈跳變成半空漂浮,問題可能早在去噪頭幾步由注意力決定。這個研究以 RoPE 調整改善影片動態。

teaser

一個籃球由半空跌落後,理應撞地再彈起,Wan2.1-T2V 卻可能生成漂浮、突然停頓或半空反彈。這個 GitHub 項目屬於影片生成模型的可解釋性研究,實際處理的是 text-to-video diffusion models 如何在早期去噪階段規劃物件軌跡,以及錯誤位置為何會一路鎖定。

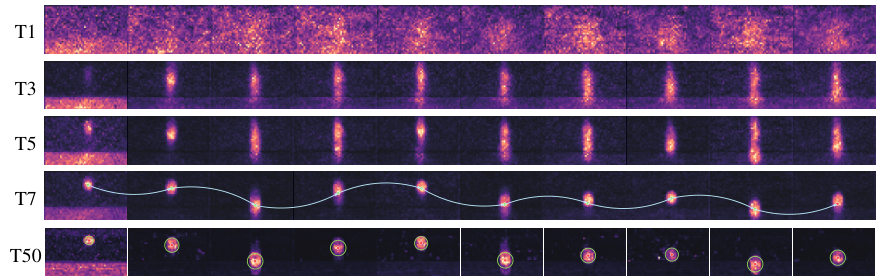
研究把視線集中在 Wan2.1-T2V-1.3B 的最初五個去噪步驟,透過 video-to-object-token cross-attention 追蹤物件位置,再配合 convergence speed 和 causal contribution 找出負責形成軌跡的 attention heads。分析指出,Self-attention 中的 Rotary Position Embedding (RoPE) 會令空間注意力衰減過快,早期錯誤候選位置因此壓過鄰近影格較合理的路徑。

修正方法不依賴外部物理模擬器或額外 foundation-model teacher,而是在早期步驟降低 height/width RoPE frequency,測試時前五步使用 λ^{h/w}=0.70;需要訓練時則以只作用於 self-attention 和 cross-attention 的 Low-Rank Adaptation (LoRA) 配合 λ^{h/w}=0.75。LoRA 設定為 r=64、alpha=32,並以首 10% 去噪步驟佔 0.9 機率的混合 timestep sampler 加強早期學習。

測試這個項目時可沿用 Wan 官方模型與提示詞,以不同 random seeds 比較原模型、training-free 頻率調整及 LoRA 版本的籃球跌落等片段;程式透過 runtime monkey patches 修改行為,不需要改動官方 Wan source。提供的資訊確認有 training-free 和 training-based 實驗,但未列出完整數值指標,因此更適合視為機制分析與可重現的研究原型,而非已證明能處理所有物理場景的通用修補方案。

  • 物件軌跡主要在最初五個去噪步驟形成
  • Cross-attention 負責引入物件語義,self-attention 協助選擇候選區域
  • RoPE 空間衰減過強,會令錯誤位置過早固定
  • 可用早期頻率縮放,或加入只改注意力層的 LoRA
  • 適合研究影片生成、模型可解釋性及物理一致性的團隊

項目主頁 · GitHub

Categories: 開源, AI productions, Embedding, 模型, 視頻模型, 模型訓練, Video, 提示詞

WorldCrafter 記住你走過的世界

WorldCrafter把單張圖片或文字提示變成可操控鏡頭的連續場景,改善長時間探索時畫面失憶與視角不一致的問題。

鏡頭移開再回望時,生成場景仍能維持空間關係,正是 WorldCrafter 要處理的核心卡位。它屬於影片世界模型,能從單張圖片或文字提示建立可探索場景,並按照鏡頭控制生成後續畫面,減少長時間移動、回訪視角時的內容漂移。

WorldCrafter以可由鏡頭查詢的隱式 3D-aware memory 保存過往觀察,讓指定視角決定哪些歷史資訊交給影片生成器;記憶編碼器與姿態條件讀取模組會把不同視角的資料整理成目標視角適用的 memory tokens。它不依賴顯式深度估計或幾何 warping,近期 temporal context則負責維持動態物件和連續動作。

WorldCrafter Video Demo

提供 WorldCrafter-Base,以及經蒸餾、面向較快推理的 WorldCrafter-Fast。兩者可在 Linux、Python 3.11、NVIDIA GPU 和相容 CUDA 驅動環境運行,模型權重放在 Hugging Face;Fast 版本較適合互動式串流,但硬件要求和生成速度仍取決於本地配置。

  • 支援圖片轉可探索世界,也支援文字轉可探索世界
  • 可控制鏡頭、揭示未見區域,並回到曾經觀察的視角
  • 設計同時兼顧靜態場景、動態場景和長時間探索
  • 評測涵蓋145個場景及725條鏡頭軌跡

評測中,WorldCrafter在長時間回訪一致性和鏡頭控制準確度上優於參與比較的基線,整體 VBench 分數亦最高;項目展示的點雲與鏡頭軌跡重建,則用來檢查生成影片的幾何連貫性。研究團隊來自 Tencent ARC Lab 與北京大學,較適合研究生成式世界模型、可控影片、虛擬場景探索及互動內容的團隊測試。

項目主頁 · GitHub · 模型

Categories: 開源, 北京大學, 騰訊, AI productions, 模型, 世界模型, NVIDIA, Video, Image, 3D, Linux, Dataset 數據集

TeleAntiFraud 開放反詐數據與模型,建立可重現研究基礎

TeleAntiFraud 將數據集、模型、評測和程式碼集中開放,讓電信反詐研究更容易驗證與延伸。

Hero image preview

面對電信詐騙檢測需要數據、模型和一致評測標準的問題,TeleAntiFraud 以開源研究社區形式,集中提供相關資源,涵蓋數據集、模型、論文及可重現的研究基礎設施。項目由中國人民公安大學聯合發起,適合研究人員、反詐技術團隊及需要測試檢測方法的開發者使用。

社區目前公開 TeleAntiFraud 數據集、AntiFraud-SFT 模型,以及論文與程式碼倉庫,並提供 Hugging Face 模型與數據入口。相比只發布單一模型或個別研究結果,這種整合方式讓使用者可以由數據、訓練資源一路追到論文和程式碼,較方便重現實驗及比較不同方法。

可直接關注的資源包括:
– TeleAntiFraud 數據集及相關論文入口
– AntiFraud-SFT 模型發布與研究資料
– 已錄用論文及對應的公開程式碼、模型和數據
– 面向音頻文本反詐檢測的 SAFE-QAQ 研究

社區列出的最新進展包括 TeleAntiFraud-28k 獲 ACM MM 2025 接收,以及 SAFE-QAQ 獲 ACL 2026 主會接收;後者聚焦慢思考強化學習框架。網站目前未提供統一的性能數字或詳細測試結果,讀者仍需按各論文及資源頁面的評測設定理解模型能力和限制。

項目主頁

Categories: 開源, 模型, 模型訓練, 框架, 庫, 中國, Dataset 數據集

Page 17 of 55
1 … 15 16 17 18 19 … 55