ThinkV2V 讓影片編輯先思考再生成

ThinkV2V讓多模態模型先理解影片中的因果與隱含意圖,再交由DiT完成較複雜的指令式影片編輯。

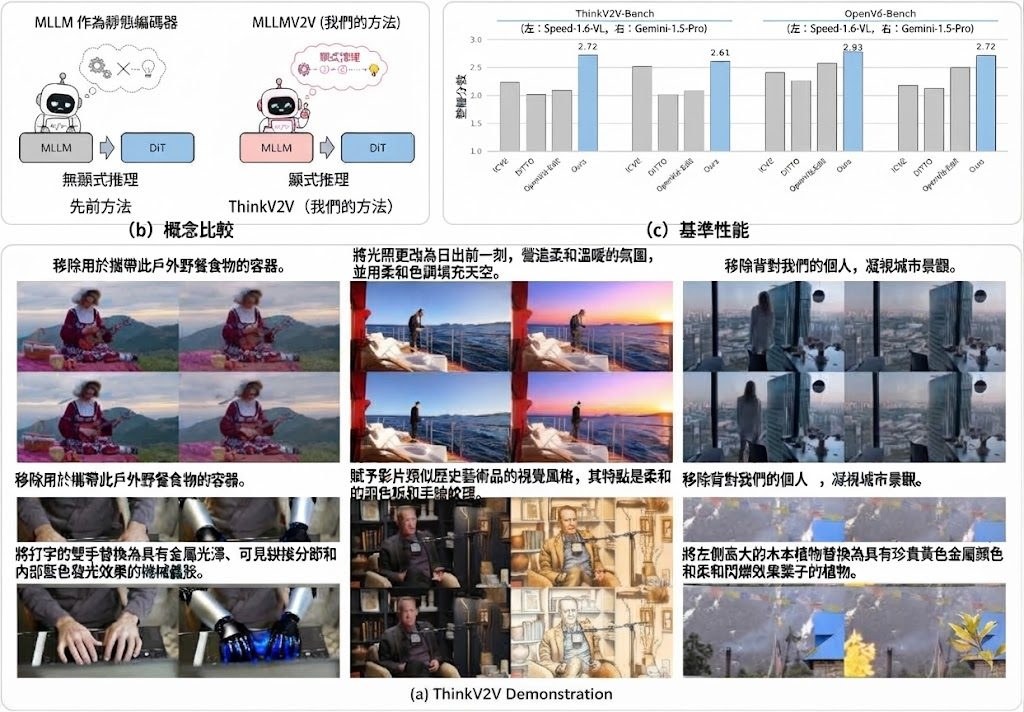
ThinkV2V Overview

面對「按場景關係修改影片」這類指令,單靠文字語意對齊往往不足。ThinkV2V屬於推理導向的影片編輯框架,讓Multimodal Large Language Model(MLLM)先分析來源影片與指令,再把推理結果轉成DiT影片生成器可用的條件訊號,處理物件關係、時間變化及隱含意圖。

MLLM並非只擔任靜態語意編碼器,Qwen3-VL-8B-Thinking負責理解和推理,connector則把相關特徵對齊至DiT條件空間;原始文字嵌入、MLLM隱藏狀態及來源影片的VAE特徵會一同交由ThinkV2V-5B執行編輯。訓練由穩定的基本編輯逐步過渡至高解像度及推理密集案例,推理階段亦會生成多個候選計劃,再由MLLM篩選較可靠的一個。

  • 適合場景:需要根據時間脈絡、物件互動或因果關係修改影片的工作流程。
  • 評估資源:提供ThinkV2V-150K訓練數據集及ThinkV2V-Bench,後者包含308個樣本和5類推理密集編輯,預設支援720p。
  • 執行條件:Python 3.10、CUDA 12.x、PyTorch 2.6.0,並以torchrun或accelerate進行多GPU運算。
  • 資料限制:OpenVE-HQ-1M與ThinkV2V-150K主要是metadata釋出,下載腳本不會一併取得OpenVE-3M影片資料。

項目需要同時準備ThinkV2V、Qwen3-VL-8B-Thinking、Wan2.2-TI2V-5B及Lucy-Edit-Dev等權重,並按儲存庫指定的data與weights結構放置,較適合有CUDA多GPU環境及影片生成經驗的研究團隊。它相較只把MLLM當編碼器的做法,換取更深入的指令理解,但推理、多候選篩選及多模型權重亦會增加顯存、時間和安裝成本;儲存庫提供模型、資料集與基準測試,卻未在提供內容中列出可直接引用的量化領先幅度,不能只憑架構宣稱全面勝過其他影片編輯器。
項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 字節跳動, AI productions, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, 框架, 香港, Python, 庫, Dataset 數據集

EngiWorld 把工程代理接入真實軟件工作流

EngiWorld 不只測試代理人能否操作介面,更檢查它能否交付合乎工程規範的成果。

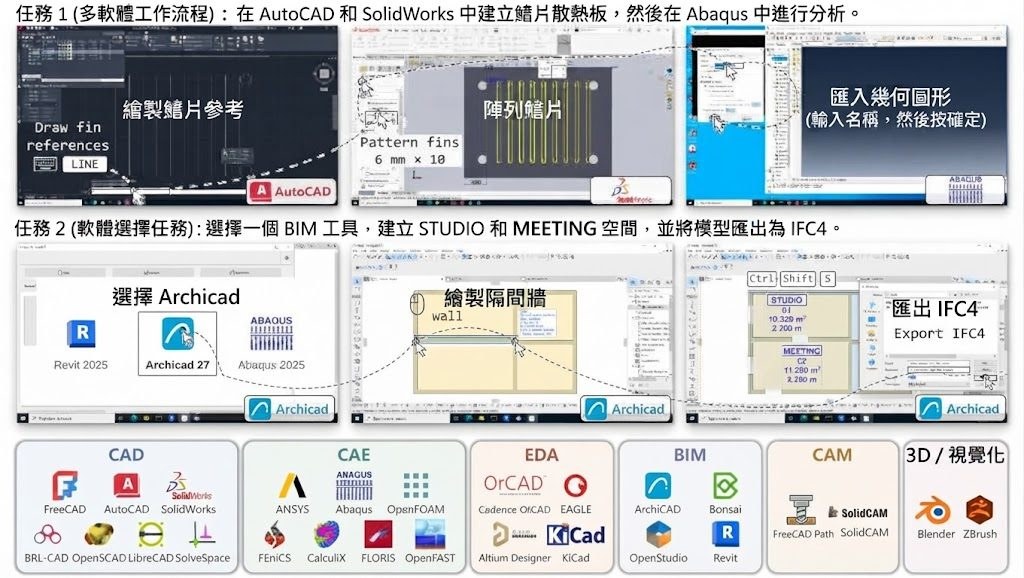
EngiWorld task examples and engineering software coverage

代理人要在 CAD、CAE、CAM、BIM、EDA 和 3D 視覺化軟件中完成工作,難點不只是點擊按鈕,而是要維持幾何、物理條件及跨軟件流程的正確性。EngiWorld 屬於工程代理人評測基準,實際處理的是「能否由指令一路產出可驗證工程成果」這個問題。

項目收錄 1,301 個專家編寫任務,涵蓋 26 個軟件平台、6 個工程領域及 6 類任務,支援 GUI 和 CLI。評測會檢查最終及中間工程文件的幾何有效性、物理可行性和規則符合度,數值設計任務亦會按規格達成程度連續計分,而非只分成功或失敗。

  • 提供完整任務、驗證器及 GUI/CLI 評測執行環境
  • 主實驗採用 300 個任務,清單位於 task/splits/main-300.txt
  • 本地環境以 Linux、Docker 及虛擬機器執行,預設每個環境使用 4 個 CPU 和 16 GB RAM
  • 七個前沿模型中,最高 EngiScore 只有 44.3;多軟件嘗試成功率為 3.6%

同類 Computer-use agents 評測多集中於一般桌面操作,EngiWorld 把判斷標準推到可交付的工程 artifact,因此更能揭示模型在長流程、跨軟件依賴及專業規範上的不足。代價是執行門檻較高:需要 x86_64 Linux、Python 3.10、Docker Engine 和環境映像,沒有 /dev/kvm 時亦可運行,但軟件模擬會較慢。

研究團隊、工程軟件開發商,以及想比較 GUI agent、CLI agent 或多模態模型能力的團隊,都可以用它重現測試並保存評測結果。它目前更適合作為嚴格的研究及模型比較工具,而非即插即用的生產自動化方案;最高分數與多軟件成功率反映,代理人距離穩定完成專業工程流程仍有明顯距離。

項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, Agentic, 模型, 多模態模型, 軟件, 工具, 3D, Python, Dataset 數據集

VoxMem 測試音訊模型的記憶盲點

VoxMem 不只測模型記得講過甚麼,還檢查能否辨認說話者、語氣與背景聲音,直面多輪語音記憶的缺口。

VoxMem logo

當語音助手要回想幾次對話之前的內容,答案未必藏在文字轉錄稿內:誰說過一句話、當時的語氣,以及背景傳來甚麼聲音,同樣可能決定答案。VoxMem 屬於語音記憶評測基準,透過多次會話測試 Large Audio Language Models(LALMs)能否保留及運用這些非文字資訊。

項目把測試拆成兩條軸線:需要找回的聲音證據包括 speech semantics、speaker identity、paralinguistic cues 和 environmental sound;記憶操作則涵蓋 information extraction(IE)、multi-session reasoning(MSR)、temporal evolution tracking(TET)及 answer refusal(AR)。這個安排比只問模型能否找回一句原話更接近長期語音助手的工作情境。

VoxMem 提供 3,196 個評測實例,涵蓋 34,743 段、共 177小時的語音會話,並固定問題及證據,只改變8K、16K、32K 和 64K tokens的上下文長度。測試者可從 GitHub 項目取得程式碼,再配合 Hugging Face上的資料集重現評測;Python 3.9 或以上是已列出的基本環境,但不同 LALM仍可能需要各自的模型存取設定。

結果指出,15個 LALMs 在 32K 上下文下沒有模型達到 40% 整體準確率;模型記住文字內容的能力明顯高於辨認說話者、語氣及環境聲音,而且歷史越長,差距越大。這令VoxMem 更適合用來找出語音記憶系統的失效位置,而非單純作為模型排名工具。

• 同時測試聲音證據與記憶操作,涵蓋15個有效組合
• 以多會話歷史取代單一錄音,檢查跨場景整合能力
• 包含證據不足時拒絕回答,能檢視模型是否過度猜測
• 非文字聲音資訊在長上下文下明顯較難保留

研究語音代理、會話記憶、音訊模型或長上下文系統的團隊,能用這套基準分辨問題究竟出在聲音理解、跨會話推理、狀態追蹤,還是拒答判斷。資料採用 CC BY-NC 4.0,程式碼則使用MIT授權,商業產品整合前仍要獨立檢查資料使用條件。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型, Audio, 工具, Python, 語音, Dataset 數據集

NVIDIA LongLive 把長片生成推向即時互動

NVIDIA 將三階段長片生成研究整合到同一個項目,涵蓋即時互動、量化推理及可重用蒸餾能力。

LongLive logo

NVIDIA 開發團隊把長片生成帶入即時互動、低精度推理和跨模型重用場景。LongLive 屬於開源影片生成研究項目,處理長時間生成容易變慢、下游模型需要重複蒸餾,以及互動控制成本偏高等問題。

項目分成三代,並各自放在獨立目錄,附有程式碼、文件和模型權重。LongLive 1.0 聚焦即時互動長片生成;LongLive 2.0 以 NVFP4 量化和 sequence parallelism 加速訓練及服務;LongLive-Plug 則把 few-step、CFG 和 long-context 能力蒸餾成可重用 LoRA,讓同一模型家族的下游模型減少重新訓練。

LongLive 2.0 支援 T2V/I2V AR training、multi-shot 或 single-shot videos,以及 NVFP4 inference、NVFP4 KV Cache 和 TorchAO FP8 PTQ inference,取捨是需要配合量化及平行化基礎設施。

  • LongLive-Plug:一次蒸餾能力,再在同一 backbone family 的下游模型重用
  • LongLive 2.0:以 NVFP4、BF16 和 sequence parallelism 支援長片訓練及推理
  • LongLive 1.0:讓使用者輸入提示詞後即時觀看並逐步控制長片生成
  • DreamForge-World 0.1:加入 residual action pathway,面向低算力、即時可控 world modeling

研究展示包括互動示範、長片 rollout 和不同 backbone family 的配對例子,但提供資料未載有可直接比較的統一 benchmark 分數。具備 NVIDIA GPU、需要研究影片生成系統,或希望在 Wan2.1、Wan2.2、MiniMax-H3 等模型家族上重用蒸餾能力的團隊,較容易找到合適切入點;一般使用者則要先接受它偏研究項目,操作細節仍取決於所選目錄。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, NVIDIA, Video, 提示詞, 語音, Dataset 數據集, MiniMax, LoRA

WorldLine 讓機械人先看見動作後果

WorldLine 把機械人動作轉成影像及空間訊號,預測場景如何變化,再協助評估策略及規劃操作。

Repository image for Zhengsh123/WorldLine

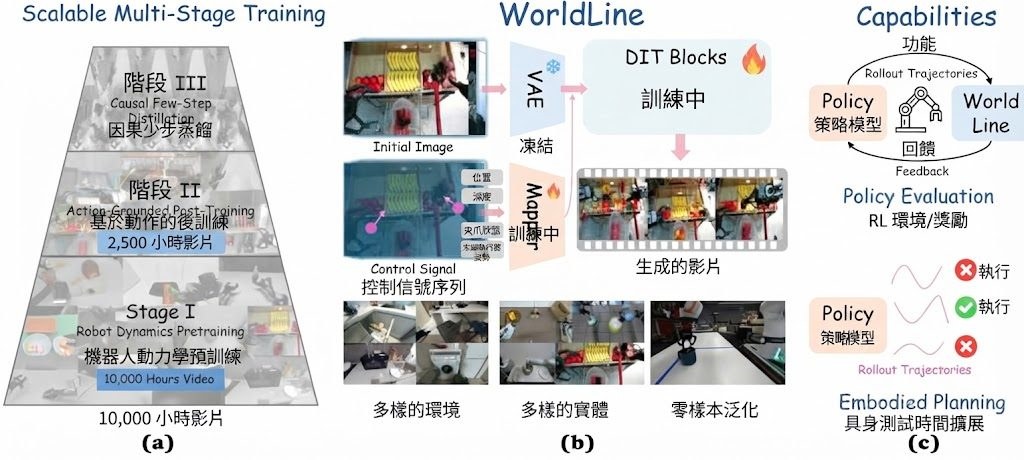
機械人要搬動物件前,WorldLine 可以先在視覺模擬中預測動作會如何改變場景,減少每次都依賴實體試錯。它屬於面向機械人操作的世界模型及視覺模擬器,處理的是「控制指令如何造成可觀察結果」這個核心問題,而不是按照任務文字生成畫面。

WorldLine 先用超過10,000小時的無動作標註機械人影片學習機械人與物件的互動,再把末端執行器的位置、深度、方向及夾爪狀態投影到經校準的相機視角。這些 image-space actions 成為不同機械人之間的共同介面;另外超過2,000小時、涵蓋10多種 embodiments 的動作軌跡,負責把通用 dynamics 對應到個別控制方式。

WorldLine 把 action grounding 分開處理,較有利於跨機械人及跨鏡頭遷移,代價是需要校準相機、動作軌跡及失敗案例。模型以 block-autoregressive 方式因果 rollout,每個區塊用四步 denoising 生成,兼顧互動速度與預測細節,但不代表能取代真實環境驗證。

  • 用於 policy evaluation、embodied planning 及實體操作前的預測
  • 以 image-space action 統一不同機械人的視覺控制介面
  • 透過 multi-view、failure-enriched training 及 relational regularization 強化互動敏感度
  • 以 few-step distillation 減少 rollout 所需計算

研究團隊包括香港科技大學、Joy Future Academy、北京大學及香港中文大學。較適合研究機械人學習、視覺規劃及模擬器的團隊先按程式碼建立推理環境,再以不同 camera view、embodiment 和失敗動作測試預測穩定性;需要即時控制的人員則應同時量度延遲、動作偏差及真實機械人的遷移落差。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港科技大學, 北京大學, AI productions, 模型, 視覺模型, 世界模型, 模型訓練, Video, Image, 香港, Dataset 數據集

MiniMax-H3 Orbit LoRA 360° Bullet Time 環繞鏡頭

一張相片配合同一張首尾關鍵幀,鏡頭可繞主體 360°移動,場景保持凝固並回到原始畫面。

Og image

想把靜態相片製成可循環播放的環繞鏡頭(Bullet Time),MiniMax-H3 360° Orbit LoRA 針對的正是首尾畫面難以對齊、場景容易變形的問題。它是基於 MiniMaxAI/MiniMax-H3、FL2VA variant 的 LoRA adapter,配合同一張圖片作為 first frame 與 last frame,令鏡頭完成連續 360°orbit,而人物和物件維持原本位置、姿勢及形狀。

模型的 instance prompt 明確要求只移動相機,利用 camera parallax 產生視覺變化;模型不應加入縮放、切鏡、變形或新物件。影片末端回到開始畫面,因此多段 orbit 可以串接,減少循環接點出現跳變。

  • 適合產品展示、人物定格、場景掃視,以及需要無縫循環的短片項目。
  • LoRA 屬於附加權重,不能單獨取代 MiniMax-H3;頁面未提供參數規模、上下文長度或訓練細節。
  • MTP draft speculation、v2 更新、檔名變更及 chat template 注意事項亦未有資料,不能據此推斷推論效能或資源需求。

結果比較採用相同 seed、prompt、解析度和 step count,但展示內容仍屬範例,未有量化的畫質、穩定性或速度指標。對需要精確幾何還原、長片一致性或非環繞運鏡的項目,頁面資料不足以證明效果。

模型

Categories: AI productions, 模型, 視頻模型, 模型訓練, Video, Image, 3D, MiniMax, LoRA

WorldPlay2 即時控制互動世界模型

WorldPlay2嘗試令世界模型在多樣場景中持續演化,同時保留即時反應與細緻控制,代價是系統仍未準備好供外部重現。

Repository image for WorldPlay2/WorldPlay2

想令場景隨鏡頭、角色動作和語意事件持續發展,世界模型往往要在即時反應、控制彈性與長時段一致性之間取捨。WorldPlay2 屬於互動世界模型,處理的正是這個矛盾:它可以跨越不同場景與角色生成連貫內容,並回應多種控制訊號。

模型把控制拆成兩層:一層是與影格對齊的連續動作,例如相機俯仰;另一層是結構化語意控制,分開處理場景外觀、角色身份和動態語意事件。這樣做比只依賴單一動作介面更容易表達複合指令,但亦令控制學習和資料整理更複雜。

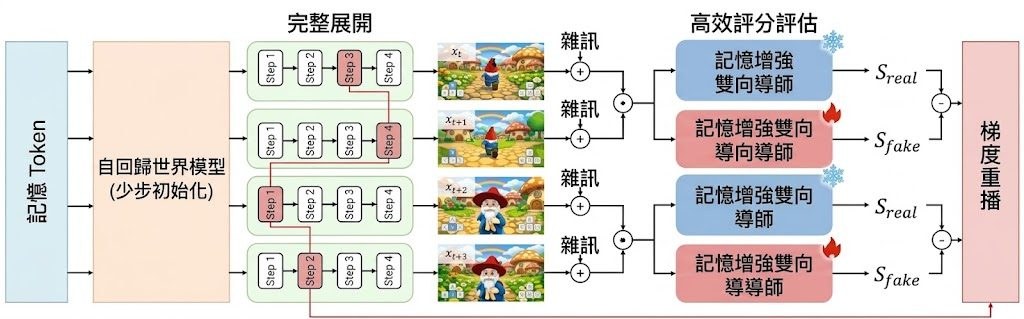
長時段生成由壓縮記憶和 Stable Forcing 支撐。歷史影格會被壓成緊湊的 memory tokens,供自回歸 student 與雙向 teacher 共用,蒸餾時改以分片、受記憶條件約束的分數評估,避免每次都處理整段 rollout;Stable Forcing 則先以少步策略初始化 student,再透過完整 rollout replay 維持長序列品質。

  • 可跨多樣場景與角色保持較長時間的一致性
  • 同時支援影格對齊動作與結構化語意控制
  • 以壓縮記憶降低長時段蒸餾開銷
  • 實驗聲稱整體表現優於既有方法,但未提供可核對的詳細指標

研究者、互動遊戲原型團隊和需要可控視頻生成的開發者較容易從中受益,尤其適合研究鏡頭控制、角色持續性及長期世界演化。儲存庫仍在整理程式碼與權重,README 沒有提供安裝、下載或測試流程,現階段較適合先觀看展示影片和研究方法;正式重現仍要等待相關檔案公開。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, Video, 庫

Audio8 ASR Infinite:持續運行語音轉錄

Audio8 ASR Infinite 以可調音訊時鐘和延遲,處理長時間串流轉錄的反應速度與記憶體增長問題。

Repository image for Edge0-AI/Audio8-ASR-Infinite

長時間錄音、直播字幕或語音助理最怕轉錄愈跑愈慢,甚至因上下文累積而出現漂移。Audio8 ASR Infinite 屬於原生串流語音識別模型,透過 rolling KV cache 將記憶體和延遲維持在有界範圍,支援 24/7 連續轉錄;目前支援中文及英文。

模型可在 80、120、160 ms 音訊時鐘之間選擇,每秒作出 12.5、8.3 或 6.25 次決策,並可將 transcription delay 設於 240 至 560 ms。延遲愈低,回應愈快;較長延遲則有較多時間累積語境。Semantic VAD 亦會分辨思考停頓、口吃和真正句末,減少傳統 acoustic VAD 過早截斷語句的問題。

架構承接 Voxtral realtime audio architecture 和 DSM-style streaming:Causal Audio Tower 以 Voxtral Realtime 4B 為初始權重,Audio Projector 及 Frame Length Embedding 由隨機初始化訓練,Decoder 和 LM Head 則採用 Qwen2.5-3B-Instruct。項目仍屬 preview release,後續會在同一 frame grid 加入即時語義感知。

  • 適合直播字幕、長時間會議紀錄及持續運行的語音介面
  • 可按硬件資源和回應要求調整音訊時鐘及延遲
  • 目前資料未提供完整安裝流程、硬件需求或公開 benchmark 數據
  • 使用 adapted vLLM build 才能對應無限長度串流運行

對需要低延遲、不中斷轉錄的團隊,這個模型的價值在於把速度、延遲可調性和長時間穩定運行放在同一個架構內,但正式採用前仍要自行測量廣東話支援、GPU 佔用及不同時鐘組合的辨識準確度。

項目主頁 · GitHub · 模型

Categories: 開源, Embedding, 模型, 模型訓練, Audio, 語音, Dataset 數據集, 廣東話

LightMIS 以輕量化架構推進醫學影像分割

LightMIS以精簡多尺度編碼器取代傳統逐階解碼器,嘗試在減少模型參數與運算量的同時,維持醫學影像分割表現。

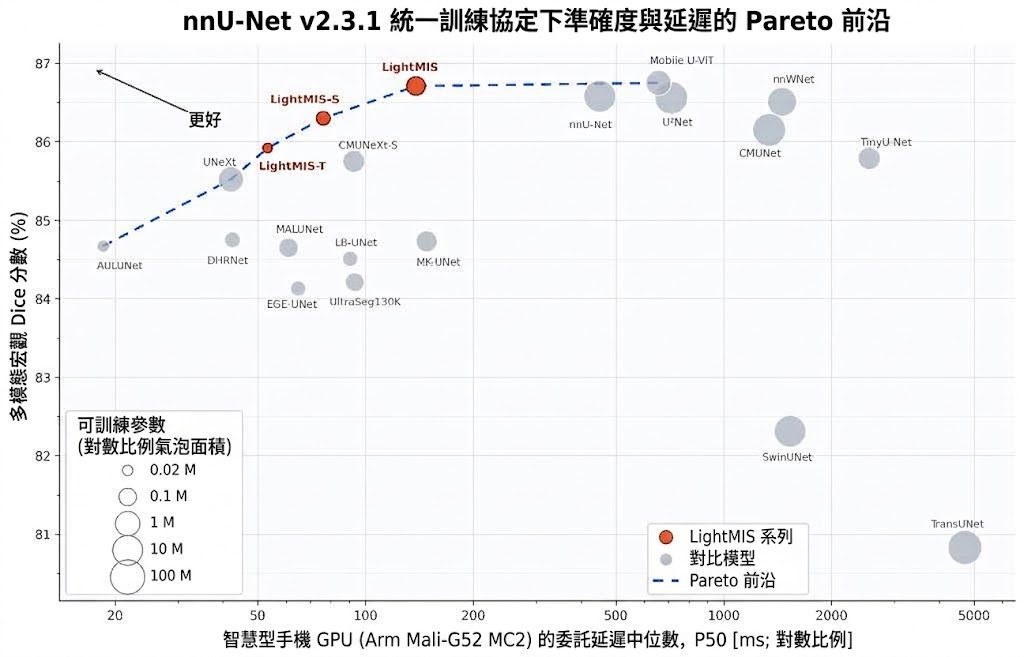
LightMIS accuracy–latency Pareto front

在手機 GPU 上執行醫學影像分割,模型大小與處理速度都會影響部署選擇。LightMIS 是一款面向 2D 二元醫學影像分割的輕量模型,透過精簡多尺度編碼器和聚合式輸出頭,減少傳統逐階解碼器帶來的重複上採樣及特徵融合運算。

模型在每個空間尺度使用 Adaptive Fusion Cascade(AFC)處理特徵;其中的 Progressive Receptive Fusion(PRF)會暫時擴展通道,配合不同深度卷積感受野及分支間逐步傳遞資訊,補足窄通道特徵的表達能力。編碼器各層輸出再由 Scale-Aligned Projection(SAP)對齊至相同解析度與通道寬度,融合後交由最後一個 AFC refinement,毋須沿用逐層上採樣的解碼結構。

在 nnU-Net v2.3.1 的共同測試流程下,研究以六個資料集、五個影像領域及五折交叉驗證評估模型。LightMIS 的區域重疊指標與明顯更大的 Mobile U-ViT、nnWNet 和 nnU-Net 接近,邊界距離結果亦具競爭力;參數量少 90.58% 至 99.61%,GFLOPs 少 82.54% 至 96.14%。

在配備 Arm Mali-G52 MC2 GPU 的手機上,各版本都達到 100% GPU 算子覆蓋率;LightMIS-T 的委派中位延遲為 53.31 毫秒,LightMIS 為 138.31 毫秒。這些結果適合參考於需要控制模型體積、運算量或手機端推理的研究與開發工作,但不代表所有裝置和醫療場景都會有相同速度或準確度。

要重現測試,需配置 nnU-Net v2.3.1,將 DRIVE、Kvasir-SEG、DSB18、BUSI、ISIC-2017 或 ISIC-2018 等資料集轉成 nnU-Net 格式,再執行 2D 規劃、預處理及五折訓練。儲存庫提供資料轉換腳本和訓練器檔案;文章草稿所據內容未包含完整命令及硬件部署流程,不能據此推斷安裝後即可直接在手機執行。

  • 適用任務: 2D 二元醫學影像分割。
  • 核心做法: AFC 與 PRF強化多尺度特徵,SAP 對齊並聚合編碼器輸出。
  • 主要取捨: 減少參數量與 GFLOPs,並省去傳統逐階解碼器。
  • 評估範圍: 六個資料集、五個影像領域,採用五折交叉驗證。
  • 部署參考: 手機 Arm Mali-G52 MC2 上各版本達到完整 GPU 算子覆蓋,但延遲因版本而異。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Image, Medical醫學, 庫

tactile:讓電子皮膚學懂接觸位置的拓撲感知模型

Tactile-JEPA 把分散式觸覺感測器的連接關係納入預訓練,令同一套表徵可支援力量、姿態及動作判斷。

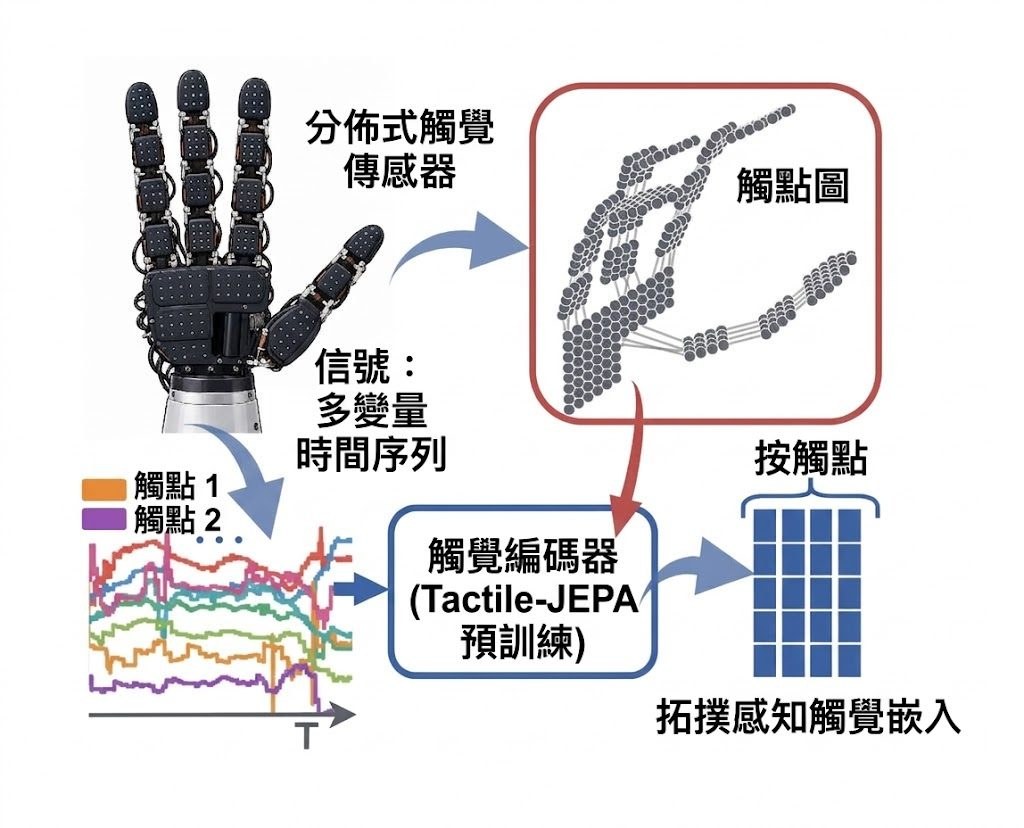
Tactile-JEPA maps distributed tactile signals to topology-aware per-taxel embeddings using the taxel graph during pretra

電子皮膚面對的難題,不只是讀取感測數值,而是要理解哪些 taxel 彼此相鄰、接觸訊號如何在感測表面分布。Tactile-JEPA 屬於觸覺表徵學習模型,透過感測器拓撲預測被遮蔽的 taxel embedding,將原本分散的時間序列轉成可供下游任務重用的表示。

它沒有把感測面硬套成規則影像網格,而是沿着 sensor connectivity graph 抽取局部及全局遮罩;預設組合包含兩個 local masks 和兩個 global masks,兼顧局部接觸細節與整個表面的狀態。模型由 context encoder、exponential-moving-average (EMA) target encoder 和 predictor 組成,predictor 預測隱藏 embedding,再以 mean squared error 對齊 target encoder 輸出;預訓練完成後,凍結的 target encoder 可配合 task-specific heads 使用,而下游編碼不再需要圖結構。

項目涵蓋 Xela magnetic hand skins、piezoresistive tactile socks,以及雙手 DECO-50 等不同感測器形態,支援 force estimation、in-hand 及 full-body pose estimation、object/action classification 和 visuo-tactile policy learning。首頁報告指,模型相對各任務最強基線,in-hand orientation error 減少 20.8%,force estimation error 減少 6.3%,但預訓練模型及論文連結仍標示為 TBD,結果重現程度要視乎後續資源是否補齊。

測試需要 Linux、Conda 及具 CUDA-compatible driver 的 NVIDIA GPU,並由儲存庫建立環境、以 editable package 方式安裝。三個資料集合共涉及數百個 taxels,下載及整理成本不低,較適合研究觸覺感知、機械人操作或 visuo-tactile learning 的團隊;只需要單一感測器分類器的工作,未必能抵銷圖結構整理及 GPU 預訓練成本。

  • 以拓撲遮罩取代影像式規則遮罩,貼近不規則電子皮膚的實際排列。
  • Local 與 global targets 同時捕捉接觸細節及整體感測狀態。
  • 預訓練 encoder 可服務力量、姿態、物件及動作等多種下游任務。
  • 圖結構只參與預訓練,之後的編碼流程較容易接入不同任務。

項目主頁 · GitHub · 模型

Categories: 開源, Embedding, 模型, 模型訓練, Robotic, 庫, Dataset 數據集

Page 15 of 55
1 … 13 14 15 16 17 … 55