PanoWorld 把 360 影片生成拉回真實場景

想做會記得路徑同方位的全景生成,PanoWorld比一般短片模型更有方向感。它瞄準長距離一致性,重點不只係畫面靚,仲要前後場景講得通。

PanoWorld logo

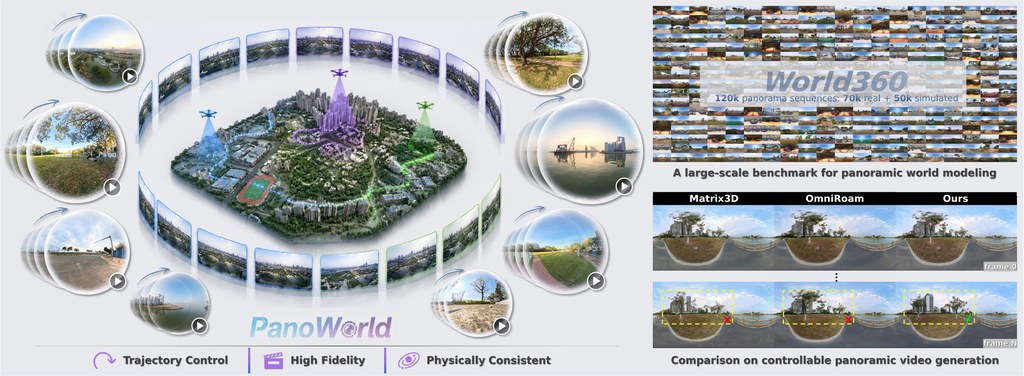
做 360° 影片生成,最易穿崩的往往不是單幀畫質,而是鏡頭轉了一大圈之後,場景記憶是否仍然連貫。PanoWorld屬於世界模型兼影片生成模型,針對全景 world model 的 long-range memory 問題,目標是生成更符合空間幾何與物理一致性的 panoramic video。

這個項目的取向幾明確:不是單純追求更短時間出片,而是利用 omnidirectional representations 的 rotation-equivariant 特性,將旋轉視為隱含幾何變換,再把相機軌跡簡化成固定朝向下的平移。核心做法包括 Dense Panoramic Ray-Conditioning (DPRC)Geometry-aware Memory Augmentation (GMA),並建基於 Wan2.2 backbone 的 triple-stream DiT,處理當前動作建模與長程記憶。

現階段公開資訊較適合做推理測試與結果驗證,訓練代碼仍未釋出。環境要求也不算輕:Linux(已測 Ubuntu 22.04)、CUDA 12.8 以上、Python 3.10,並需要至少 20GB VRAM 的 CUDA GPU;README 亦提供 demo assets,可先用來跑 inference,觀察 81-frame 與 161-frame panoramic video 的生成表現。

  • 重點放在 long-range memory,而非只提升單段片段觀感
  • 可生成 81-frame、161-frame 的 panoramic video
  • 評測依託 World360,涵蓋真實全景無人機片段與 AirSim360 模擬資料
  • 官方表示在 World360 上明顯勝過其他方法,但目前公開細節以展示頁與推理資源為主

受益最明顯的,會是做 360 內容生成、沉浸式視覺、無人機視角模擬,或研究世界模型長時序一致性的團隊。它未必是最容易部署的項目,但定位很清楚:當一般 video model 在大範圍空間變化與光照變化下容易失憶,PanoWorld正面處理這個痛點,並且連同 World360 一起把評測場景拉近真實世界。
項目主頁 · GitHub

Categories: 開源, 清華大學, 視頻模型, 世界模型, NVIDIA, Video, 影像處理, 3D, Linux, Python, Dataset 數據集

Canvas360 把全景生成拉回可用水平

全景圖最易穿崩嘅位置,往往唔係畫質,而係左右接縫同空間感。Canvas360 針對呢個痛點落手,想令文字生成同後續修補都更連貫。

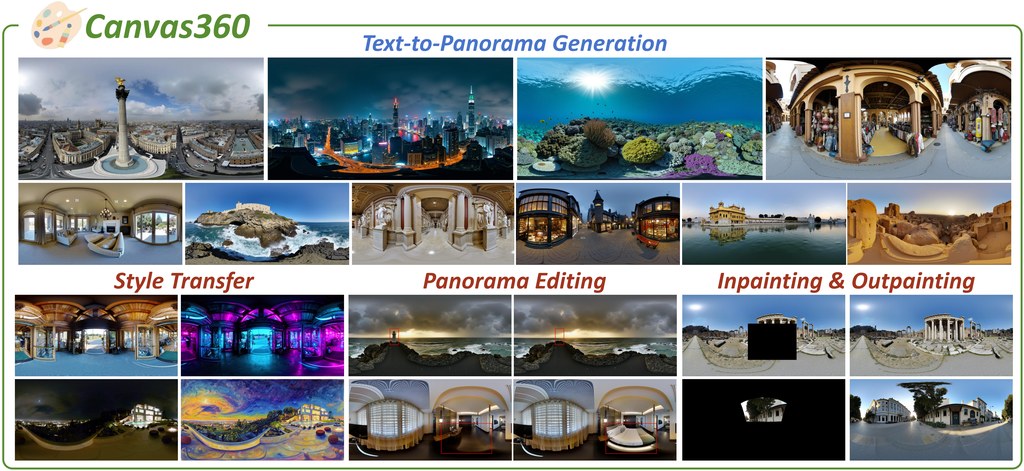
teaser

最值得留意嘅地方,在於佢唔只想生成一張闊圖,而係想處理 360 度全景最常見嘅破綻:左右邊界接唔上、透視變形唔自然、補圖後空間結構散開。Canvas360 屬於影像生成框架,建基於 FLUX,處理嘅係 text-to-panorama image generation,同時延伸到 inpainting、outpainting、editing 同 style transfer 呢類全景工作流。

現有做法多數先把全景當成一般平面圖片生成,再靠後處理減少接縫;作者認為呢種範式忽略咗 panoramic projection 本身嘅幾何特性,所以容易喺邊界、深度關係同局部結構出現錯位。Canvas360 用 two-stage framework 重組呢件事:先做 geometry-aware pretraining,引入 parallel RGB-depth pretraining,再配合 continuous position encoding、circular latent padding 同 per-block feature synchronization,將 360 度連續性直接放入模型學習過程。

同類項目相比,Canvas360 嘅取向唔係單純追求更華麗嘅畫面,而係優先修正全景生成最影響可用性嘅一致性問題。項目亦補上 Canvas360Dataset,提供 1M paired panoramic samples,支援 style transfer、inpainting、outpainting 同 editing,反映作者唔止做單一模型改良,仲想連訓練資料結構一併補強。

  • 核心定位係 FLUX-based framework,主打 text-to-panorama image generation 同全景補全
  • 關鍵方法包括 geometry-aware pretraining、continuous position encoding、circular latent padding
  • 已公開 inference code 同 training code,但 model weights 與 online demo 仍然未釋出
  • 需要 base model black-forest-labs/FLUX.1-dev,並可配合自備 LoRA 跑生成或下游任務
  • 相關比較對象包括 PanFusion、SMGD、PAR、WorldGen、HunyuanWorld、DiT360,以及 FLUX.1-Kontext-dev、FLUX.2-dev、Qwen-Image-Edit

測試同現階段較接近研究型項目而唔係即開即用服務。儲存庫已提供 inference.py 同 inference_downstream.py,代表你可以在本地環境配好 PyTorch、依賴套件、FLUX.1-dev 存取權同 LoRA 後,直接驗證文字生成全景,或者試全景補圖與延展;不過權重未公開,所以現時更適合研究團隊、全景影像工具開發者,或者想研究 360 度生成方法嘅人先行閱讀同跟進。現有介紹強調結果比多個舊方法更少接縫瑕疵、結構更清晰,但儲存庫內容未見完整量化指標表,判斷性能仍要等論文與權重進一步公開後先更穩陣。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 字節跳動, 模型, 視覺模型, 模型訓練, Stable Diffusion, Image, 影像模型, 框架, Python, Dataset 數據集

PhyMRI-SR:MRI 超解像唔只靠放大

PhyMRI-SR 針對 MRI 超解像入面常見的取捨:解析度愈高,訊噪比未必愈好。它唔係單純補像,而係把 MRI 成像物理一併放入重建流程。

Repository image for weilihua0205/PhyMRI-SR

做 MRI 超解像時,問題往往唔係「放大得夠唔夠」,而係高解析度同 SNR 會互相拉扯。PhyMRI-SR 把這個矛盾放到核心處理;它屬於一個醫學影像超解像模型/研究項目,目標不是盲目追求最高輸入解析度,而是找出更有結構資訊的重建位置。

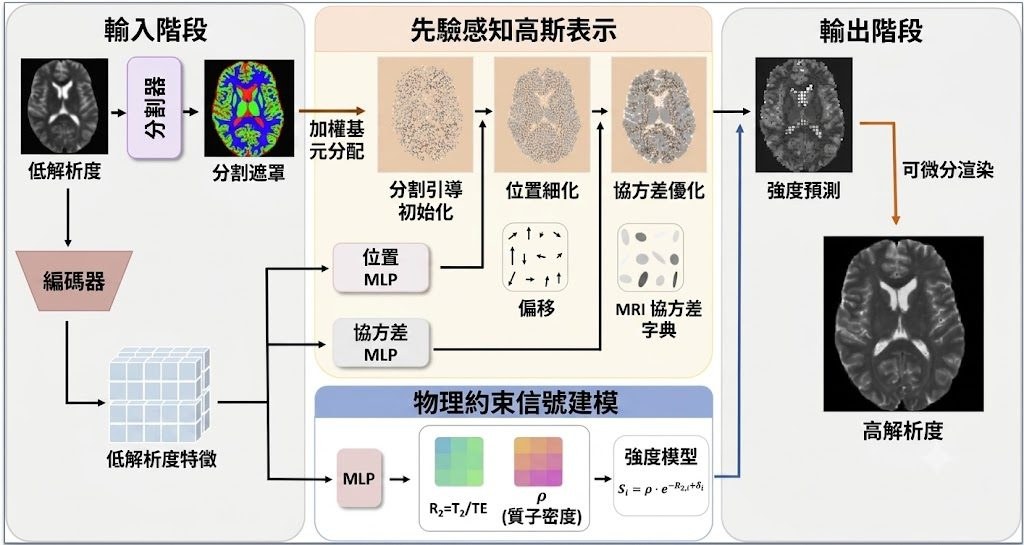
現有做法多數把低解析度 MRI 當成一般影像放大;作者認為這種 fixed paradigm 忽略 MRI acquisition physics,亦未必對應最有資訊量的輸入條件。PhyMRI-SR 因而改用 physics-aware Gaussian splatting,把組織先驗、MR signal equations 同 continuous-scale super-resolution 合併,嘗試沿住 resolution-SNR spectrum 找到更合理的平衡點。

它不是直接生成高解像圖,而是先經 segmentation-guided primitive allocation 分配 Gaussian primitives,再由 prior-aware representation 預測位置偏移與協方差,之後用 physics-constrained signal modeling 根據 tissue properties(例如 alpha、R2)計算訊號強度,最後經 differentiable splatting 合成影像。另加 meta-learning-based adaptation,用來縮窄 synthetic training 與真實 low-field MRI 之間的 domain gap。

  • 與一般影像式 SR 比較,重點放在物理一致性,唔係純粹視覺銳化
  • 支援 arbitrary-resolution 輸入,同 continuous-scale MRI super-resolution 取向一致
  • 結構上結合 segmentation、Gaussian representation 同 MR signal equations
  • 結果顯示最佳表現未必出現在最高輸入解析度,回應作者的核心假設

項目列出 simulated 與 real multi-resolution MRI datasets 的比較:模擬資料在 x0.7 時錄得 PSNR 28.10 dB、SSIM 0.9234、HFEN 0.3051、DISTS 0.1148;真實資料在 x0.76 時取得最低 HFEN 0.4570,其他指標亦有競爭力。這類結果較適合醫學影像研究、MRI 重建與超解像團隊參考;部署與測試細節仍需回到 GitHub 程式碼確認,但整體定位已很清楚:它不是通用修圖工具,而是面向 MRI 成像規律的專門方法。

項目主頁 · GitHub · Paper

Categories: 開源, 模型訓練, 影像處理, Medical醫學, Meta, 中國, Dataset 數據集

Vidu S1 把即時互動影片拉近一步

對住數碼角色直接開聲指揮,畫面仲可以一路生成一路改,Vidu S1瞄準的正是這種近乎通話式的影片互動。它未必是最通用的影片模型,但在即時控制這件事上明顯有自己路線。

Vidu S1 Experience Preview

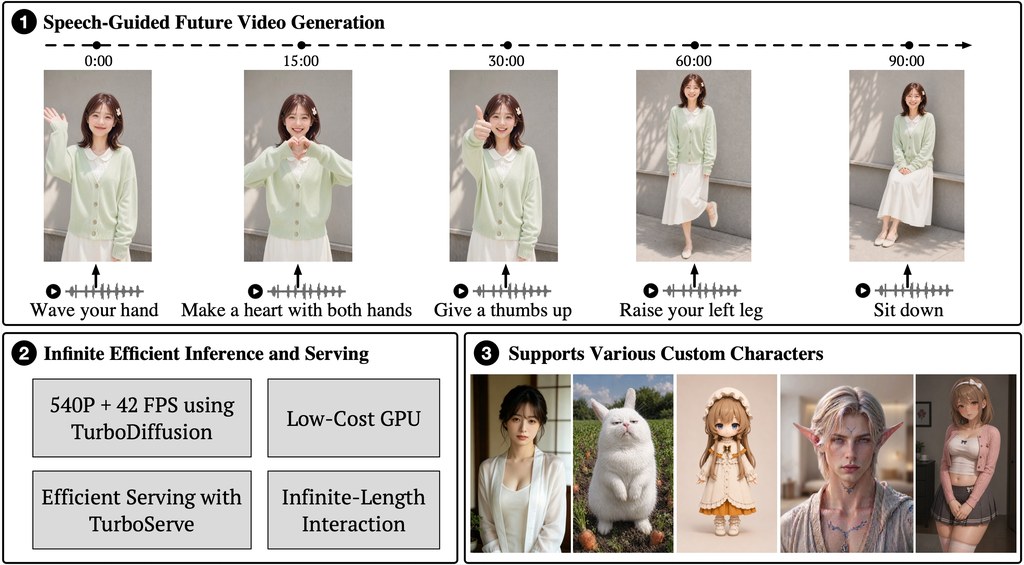
比起先寫好提示詞再等片段輸出,Vidu S1更接近一種可對話的視頻模型:你一邊講,數碼角色一邊跟住反應,處理的是「影片生成能否即時被人打斷、改向、持續延長」這個卡位。項目把重心放在 voice-controlled digital characters,而不是一次過產出完整短片,定位很清楚是互動內容而非傳統文生影片。

現有做法多數仍是 prompt-driven、片段式生成,用戶先提交指令,再等待固定長度輸出;作者主張這種範式難以支援 live interaction。Vidu S1改用 real-time speech control 與 infinite-length real-time interactive generation,讓角色在生成途中持續接受 spoken instructions,方向上更接近直播角色、虛擬主播和即時陪伴互動,而不是 cinematic clip 製作。

  • 支援以語音即時控制角色動作,重點在連續互動而非單次出片
  • 可自訂角色形象與 voice tones,涵蓋真人、二次元、寵物等 avatar
  • 官方資料提到 540p、最高 42 FPS,並可在 consumer GPUs 運行
  • 除了網頁體驗,也提供 API 文件,較適合接入互動產品流程

現有公開資訊較偏向服務化體驗:可先在 Vidu Stream 網頁建立角色、選擇或 clone 聲線,再開啟麥克風與鏡頭進行 live call;團隊要接入自家產品,則更可能經 API 而非直接本地完整重建。GitHub 儲存庫目前公開了論文、說明文件與入口,但未見完整本地訓練或推理流程,較像展示能力與提供接入方式的研究/產品型開源項目。

取捨也很明顯:它強調流暢、低延遲、可長時間互動,代表優先次序未必是最高解析度或最複雜鏡頭語言。受益最大的會是做虛擬主播、互動陪伴、角色扮演、品牌數字人和即時內容演示的團隊;要做電影感分鏡、長敘事剪輯或高度後期控制,現階段未必是它最強的一面。相關模型則包括 Vidu S1 本身,以及同一服務脈絡下的 Vidu Stream 互動入口。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 數字人, 視覺模型, 多模態模型, 視頻模型, API, Clone, 語音, Dataset 數據集

IdeasHaveGenomes:用血統追蹤科研點子

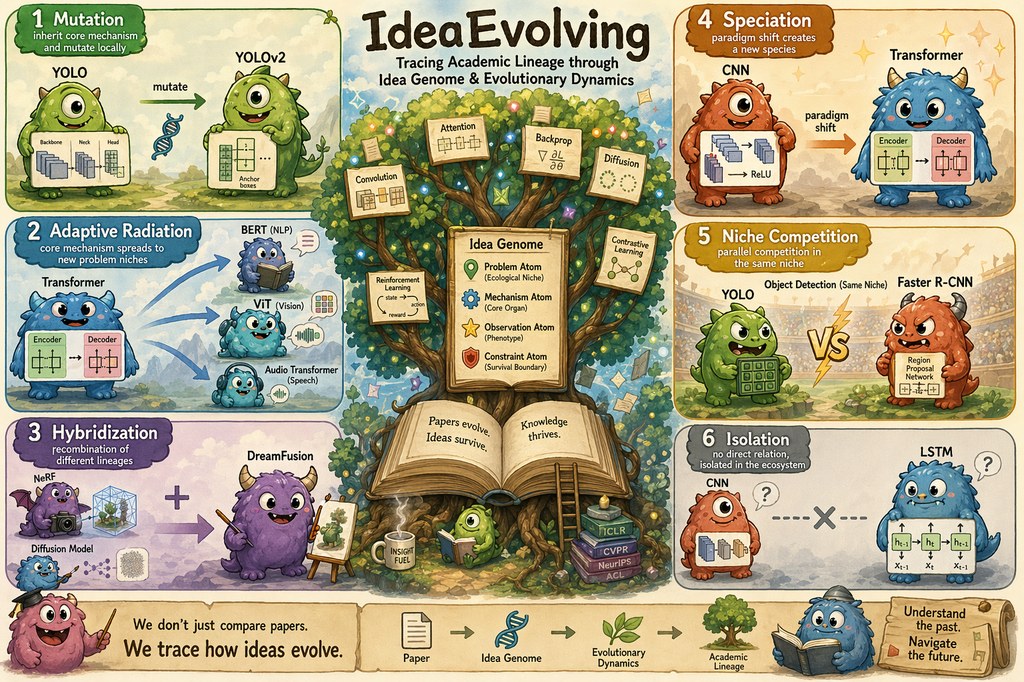
研究提案寫得像樣,未必代表模型真正明白想法點樣演化。IdeasHaveGenomes把重點放在「點子血統」,專門測試 AI 能否追蹤繼承、變化同重組。

Ideas Have Genomes overview

只會搵相似論文,已經唔足夠判斷 AI scientist 是否真係理解研究想法。IdeasHaveGenomes 把科學點子當成有 lineage 的對象去看,屬於 benchmark/數據集類型的項目,針對的正是 Auto Research 入面最難驗證的一環:模型能否講清楚一個 idea 由邊度嚟、點樣修補舊限制,最後點解值得延伸。

現有做法好多時集中在 related paper retrieval、proposal writing,或者用開放式生成結果做人手印象分。作者認為呢種範式捉唔到 inheritance tracing 同 evolutionary reasoning,所以提出 IdeaGene-Bench(IG-Bench),把任務分成封閉式測試 IG-Exam,同埋用 Population-Evolution Score(PES)評分的 IG-Arena,前者問理解是否精準,後者先看生成內容有冇 lineage 根據。

項目的可取之處,在於它唔只問「像不像新點子」,而係追問 Heredity、Variation、Selection 有冇成立。資料規模亦算完整,包括 1,961 條 golden lineage traces、1,085 個 Idea Genome objects、920 筆 GenomeDiff records,覆蓋 10 個 scientific domains;IG-Exam 進一步拆成 42 類 task、1,029 個 closed-form instances,適合做可重覆比較。

  • IG-Exam 主要測 abstraction、inheritance tracing、evolutionary reasoning、lineage verification
  • IG-Arena 針對開放式提案生成,用 PES 檢查血統延續與變化是否合理
  • 項目可用 OpenAI-compatible API 跑 smoke test 或完整評測,不一定綁死單一模型
  • 現有結果反映難度高,最佳 IG-Exam exact accuracy 只有 27.3%,最佳 T4 verification 為 17.4%
  • 榜單涵蓋 GPT、Claude、Qwen、Gemini、DeepSeek,以及 AI Scientist v2、Codex、Claude Code 等系統

部署理解上,這不是拿來直接替代研究助手的成品工具,而是用來測試模型或 agent workflow 是否真的具備「科研點子血統推理」能力。較適合做 AI scientist、research agent、proposal generation pipeline 的團隊評測基準;想比較不同模型、judge 組合,或者檢查生成提案有冇沿住正確 lineage 發展,這個項目比一般文字基準更有辨識度。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, 微軟, OpenAI, DeepSeek, Gemini, API, 框架, Anthropic, 中國, Dataset 數據集

SciReasoner 想把科學推理拉回結構本身

做蛋白質、分子同材料推理,只靠文字序列往往唔夠。SciReasoner把3D結構直接變成可推理證據,重點是答案背後的科學線索都盡量保留。

SciReasoner architecture overview

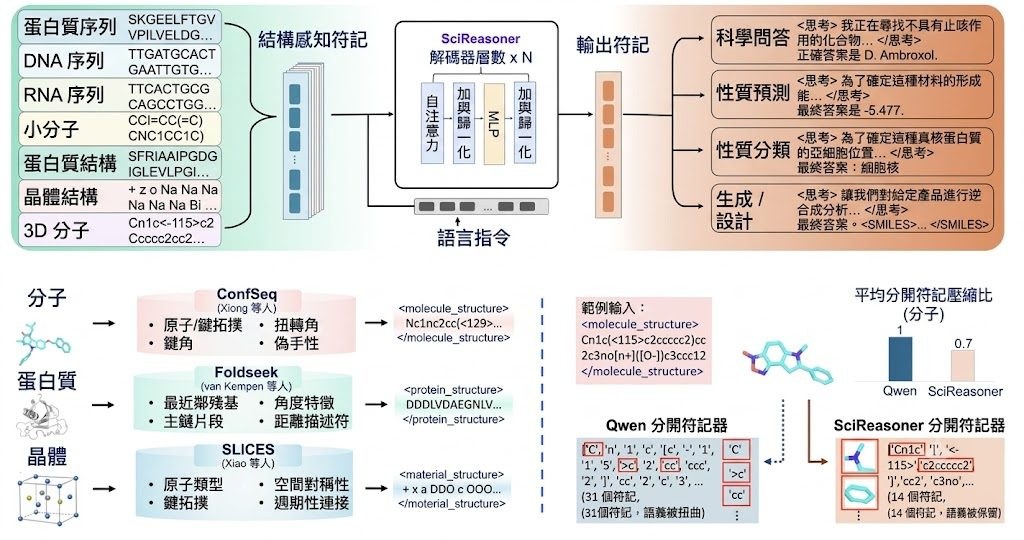
只看文字去判斷蛋白質功能、分子反應性或材料性質,經常會漏掉真正關鍵的空間結構。SciReasoner屬於多模態 scientific foundation model,針對的正是這個落差:把 protein structures、3D molecules、crystals、sequences、formulas 同 text 轉成可對照的 structure-aware evidence tokens,再用來做 scientific QA、prediction、classification 同 generation/design。

與科學資料先「文字化」再交畀大型語言模型處理的做法不同。作者明確押注 native structural reasoning,保留 Foldseek 3Di、ConfSeq、SLICES 呢類結構編碼,令模型唔係淨係讀描述,而係可以沿住 residues、fragments、conformers 甚至晶體配位環境去推理;官網展示的 traces 亦反映出,項目希望連推理路徑都可以檢查,而唔只係輸出答案。

GitHub 上的 models 同 demo 仍標示為 coming soon。換句話說,眼前較合理的理解方式係先把它當成研究型項目:閱讀 benchmark、看案例 traces,判斷它是否適合生物資訊、化學資訊或材料 AI 團隊之後的評測與整合方向,而唔係即刻下載部署到生產流程。

  • 在 86 個評測任務入面,67 個做到 state-of-the-art,對比 generalist LLM baselines 有 75 個任務表現最好
  • 與已發表的 specialist 方法相比,在 33 組比較入面有 26 組持平或更好
  • 範圍唔只化學,亦覆蓋 proteins、DNA/RNA、small molecules、3D molecular structures 同 inorganic crystals
  • traces 可檢查,雙盲專家評分中,與 DeepSeek-V4-Pro 相比有 98% 判斷屬 preferred 或 comparable

相關模型方面,SciReasoner以 Qwen3-14B 初始化,再對齊 domain-native structural vocabularies。對需要跨蛋白質、核酸、分子同材料做統一推理介面的團隊,呢個方向幾有吸引力;限制同樣明顯,因為公開模型與可直接測試的 demo 尚未提供,現階段更適合當成值得追蹤的研究項目,而唔係可即用工具。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, 南京大學, 模型, 多模態模型, Qwen, DeepSeek, 香港, Medical醫學, 3D, 中國, Dataset 數據集

AI agents 正接手企業故障追查

當系統愈來愈複雜,單靠工程師逐層查 root cause analysis 已經太慢。企業而家更想交畀 AI agents 先做調查,再由人決定下一步。

當服務一出問題,最花時間往往唔係修復,而係先搵出 root cause analysis。呢篇內容聚焦企業 observability 點樣由 Generative AI 同 agentic AI 推進,令 AI agents 開始負責調查、整理線索同縮窄問題範圍,減少工程團隊喺大量 telemetry 同 log 之間來回切換。

文章提到,企業採用速度已經相當快,約 85% 組織正使用相關 AI 能力,而 Elastic 亦預期多數企業會喺兩年內,將 root cause analysis 更大程度交畀 AI agents。吸引力唔只在於自動化,而係將原本只有少數資深工程師先能處理的觀察與排障流程,慢慢變成更多團隊都可用的能力。

同常見做法相比,分別在於 AI agents 唔止回應查詢,仲會主動串連資料、追查異常脈絡,並以較接近調查員嘅方式處理 incident。呢種模式有機會改善資料存取門檻過高、工具過多同訊號過散嘅問題,但前提仍然係企業要信任結果,並保留人手覆核關鍵判斷。

  • 重點放在 observability、incident investigation 同 root cause analysis
  • Generative AI 與 agentic AI 正由輔助查詢走向主動調查
  • 約 85% 組織已採用相關 AI 能力,企業導入已進入加速期
  • 目標係降低排障門檻,令更多團隊可直接理解系統狀態

對平台工程、SRE、DevOps 同需要處理大型分散式系統嘅團隊,呢種方向尤其有用。現階段最值得留意嘅唔係模型規格,而係 AI agents 能否喺真實企業環境中提供可追溯、可驗證、又足夠穩定嘅調查流程,呢點會直接影響大規模 adoption。

項目主頁

Categories: Agentic, 軟件, 中國

CGGS 把文字直接變成第一身 3D 場景

想由文字生成可自由觀看的第一身 3D 場景,CGGS處理得比一般全景路線更穩。它重點不是只做靚圖,而是連視角一致性與幾何結構都一併補強。

teaser

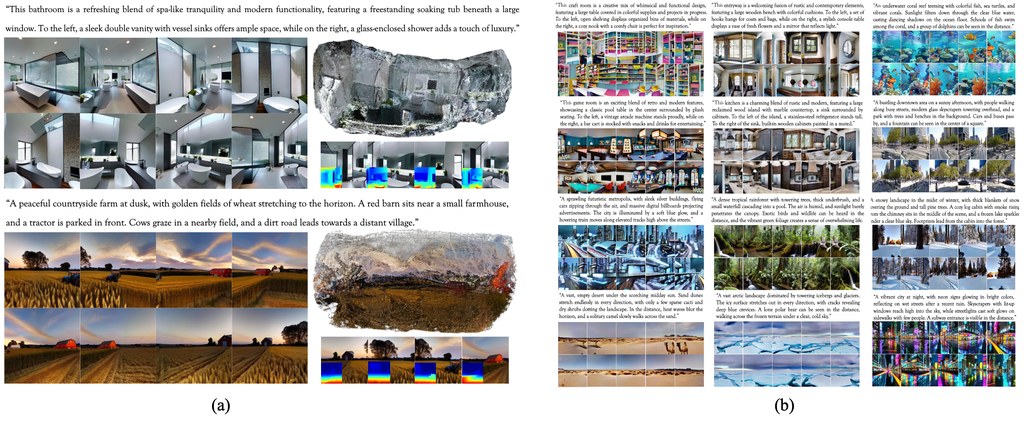
最值得留意的地方,在於 CGGS 沒有沿用單純全景生成再重建的路線,而是直接針對第一身視角 3D 場景去處理視角不連續、幾何變形和文字細節流失。它屬於一個文字轉 3D 的框架,目標是把文字描述變成可渲染的 ego-centric 場景,而不只是產出幾張彼此關係鬆散的圖片。

現有做法常見問題,是多視角之間重疊不足,或者 equirectangular projection 容易在上下邊界拉扯變形;DreamScene360 一類方法也會出現結構扭曲。CGGS 的取向是先用 MV-LDM 生成更一致的多視角 2D 內容,再配合 optical flow、point-track correspondence、深度估計與 3D Gaussian optimization,把粗略 layout 逐步修到可用的 3D Gaussian Splatting(3DGS)場景。

它的流程大致可理解為三段:Ego-centric Generator 負責貼近文字的多視角內容,Layout Decorator 由影像關係推回 dense point clouds,Geometric Refiner 再用 Mutual Information Depth Loss(MID)和 hierarchical optimization 修正幾何與畫質。部署和測試層面,儲存庫已提供實作,並可透過 prompt 檔、視角水平視野 --fov 與垂直軸旋轉角 --deg 控制生成條件,較適合研究、實驗室或要評估 text-to-3D 工作流的人。

  • 走的是 ego-centric 3D scene generation,不是單純全景貼圖
  • 核心差異在 MV-LDM 一致性訓練,加上 3D Gaussian 幾何優化
  • 提供可調視角參數,能用文字檔批量測試不同場景
  • 適合做 3D 內容生成、novel view synthesis 與方法比較

效能數字也有說服力。README 列出的結果中,CGGS 在 CLIP Score 26.253、Q-Align 0.839、PSNR 37.345、SSIM 0.977、LPIPS 0.0193 取得最佳表現,代表它不只文字對齊較好,重建品質與新視角渲染穩定度也更高;不過這仍然是研究型項目,離通用內容製作工具還有一段距離,較大的價值在於它清楚示範了如何把多視角生成與幾何重建更緊密地接起來。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, 3D, 中國, Dataset 數據集

SIEVE 點樣揀出更值錢的機械人示範數據

示範數據愈多,未必代表 VLA 訓練效果愈好。SIEVE 想做的,是先拆開動作結構,再挑出更值得保留的片段與軌跡。

Repository image for ChangtiWu/SIEVE

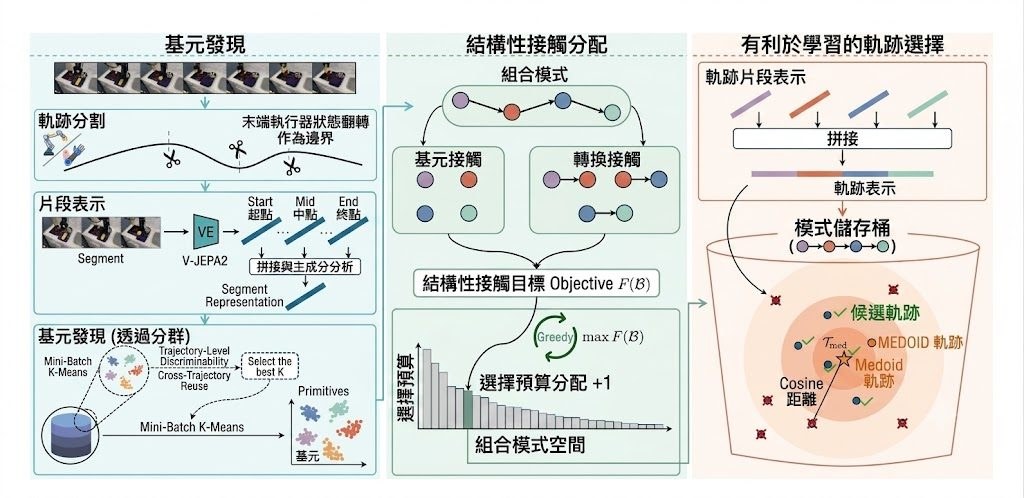
機械人示範資料最常見的問題,不是數量不夠,而是重複、嘈雜,甚至長段任務其實只是不斷重演相似動作。SIEVE 屬於一個面向 imitation learning 的資料篩選工具,同時帶有研究方法性質,重點不是逐條 trajectory 粗略評分,也不是只看 state-action,而是把長任務拆成可重用的 visuo-motor primitives 與 transition interfaces,再決定哪些 episode 更值得留下來訓練 VLA 模型。

它批評的舊範式相當明確:現有 data selection 方法多數只在 trajectory level 或 state-action level 做判斷,因而忽略長時序行為內部可重用的結構。SIEVE 的做法是先用 end-effector pose 與控制訊號做 segmentation,再抽取 V-JEPA 特徵、用 PCA 壓到預設 256 維、以 MiniBatchKMeans 找出 primitive pattern,之後按 cluster-sequence pattern 做兩階段 episode selection,最後可以匯出回 LeRobot 格式,方便直接接回原本訓練流程。

這種取向的好處,在於它不是單純挑「最好」或「最乾淨」的示範,而是優先保留結構覆蓋度與可重用性。論文提供的訊息亦相當直接:SIEVE 在多個 datasets、benchmarks 與 VLA models 上,都比競爭性的 baseline 更穩定,甚至在只用 50% demonstrations 和 50% training steps 的情況下,表現可以超過 full-data training。當然,這也代表它較適合已有一定規模示範資料、並且願意先跑一輪離線整理流程的團隊,而不是追求即插即用的小型腳本。

  • 以 LeRobot v2 資料根目錄作輸入,支援單一或多個 dataset
  • 流程由 segmentation、feature extraction、dimensionality reduction、clustering、selection 組成
  • 特徵抽取依賴 V-JEPA,輸出中間結果到 Zarr,再匯出選中的 LeRobot episodes
  • 核心差異是按 reusable structure 揀數據,不是只按整條 trajectory 或逐步 state-action 打分

部署理解上,這個項目更像一條可重複執行的離線資料處理 pipeline,而不是一個直接提供推理服務的套件。適合用來整理大型 robot demonstration corpus、為 VLA imitation learning 減少冗餘訓練樣本;相關模型與技術脈絡包括 Vision-Language-Action (VLA) models、V-JEPA,以及輸出端相容的 LeRobot。

GitHub · Paper

Categories: 開源, 香港科技大學, 模型, 視覺模型, 多模態模型, 模型訓練, VLA, 影像處理, Robotic, 香港, 中國, Dataset 數據集

Light-Omni 想把長影片 Agent 變得更快

面對長影片互動,Light-Omni唔再靠一輪輪搜尋同推理。它把記憶、檢索同回應壓縮成較輕量流程,重點放在速度同連續互動。

Light-Omni

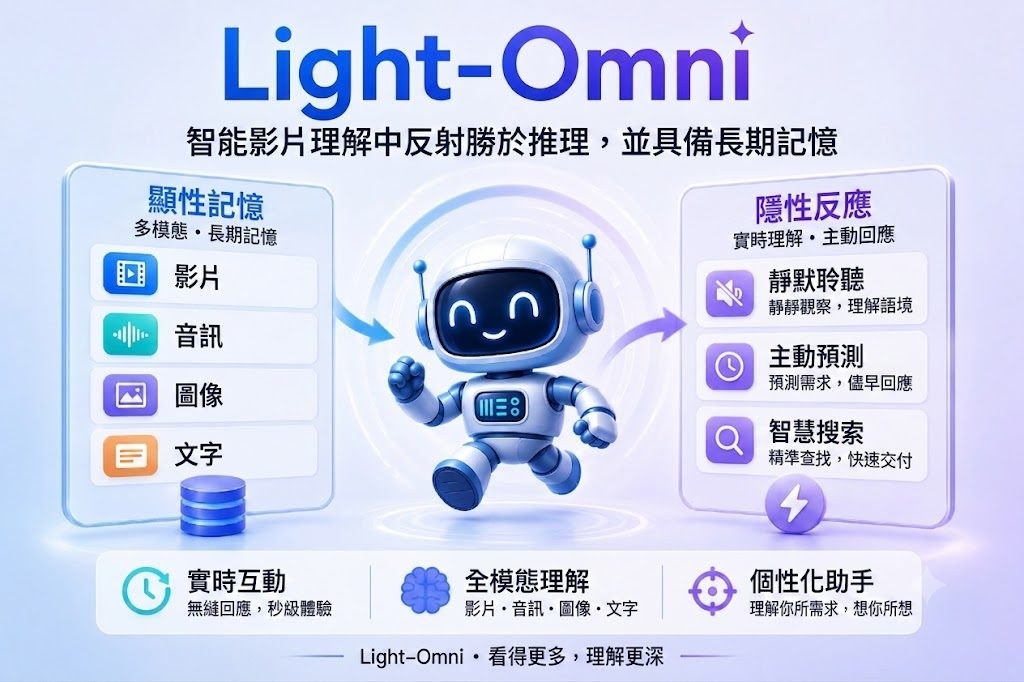
長影片互動最易卡住的位,不是模型看不懂,而是每次都要重新搜尋線索、反覆推理,回應自然會慢。Light-Omni把這件事改寫成一個Agentic video understanding研究項目:用長期多模態記憶處理視覺、語音與文字串流,目標是讓代理在連續對話中更快決定要直接回答、提取記憶,還是補足證據。

現有做法常採用作者所說的 detective-style iterative reasoning,一邊規劃、一邊搜尋、一邊聚合證據;好處是步驟清楚,代價是延遲高、計算開銷大。Light-Omni提出 reflexive video understanding,核心不是拉長 reasoning loop,而是以單次 forward pass 產生全域脈絡與 retrieval embeddings,再配合 Generation AdapterMemory AdapterReaction Adapter 三個模組,分別負責回應、長期記憶整理,以及預測何時檢索。

這個取向的價值很直接:它不是追求最繁複的推理鏈,而是優先解決互動代理在長影片場景的反應速度。項目建基於 Qwen2.5-Omni,示範則用 Qwen3-Omni-30B-A3B-Instruct;記憶設計包含 identity profiles、semantic memory、episodic memory,並加入 sleep-time memory consolidation,把較長時段的觀察壓成緊湊全域狀態,同時保留近期細節。

  • 相比 M3-Agent,平均準確率提升 2.4%
  • 速度達 12.1x,加強長影片互動的即時性
  • GPU 記憶體效率提升 2.6x,較適合資源有限的部署
  • 倉庫附有 eval.py、Flask/Socket.IO demo、Hugging Face 模型與訓練資料

想驗證這個項目,現時可沿三條路理解:先看 web demo 感受反應方式,再用倉庫內的 eval.py 配合 logs/ 檢查長影片 benchmark 結果,最後參考 thirdparty/ 內已修補的 transformersms-swift 組件做訓練或推理環境配置。較受用的讀者會是做多模態代理、長影片理解、記憶檢索,或者需要低延遲互動系統的研究團隊;它仍屬研究原型,效能數字主要來自項目提供的 benchmark 與示範,部署前仍要按自己的影片長度、硬件條件與任務形式再核實。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, Agentic, Embedding, 模型, 多模態模型, Video, Dataset 數據集

Page 6 of 15
1 4 5 6 7 8 15