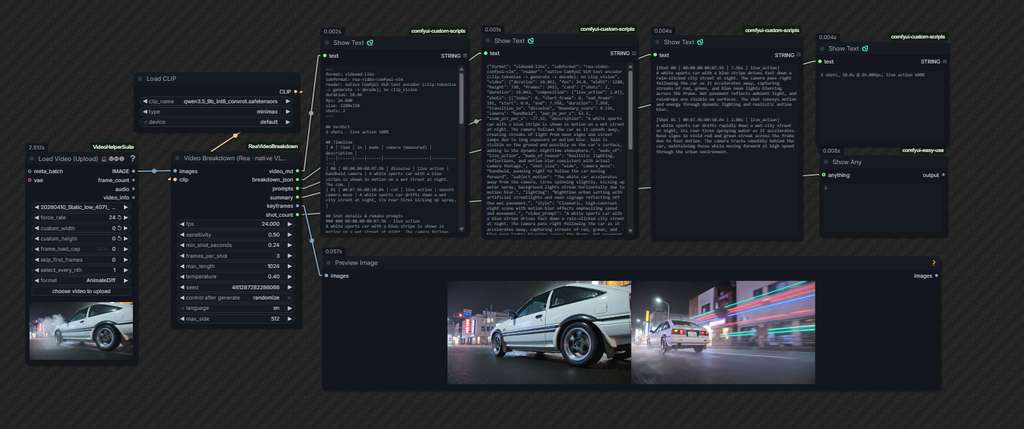
想知道一段片是怎樣生成,往往只靠肉眼猜,然後寫 Prompt。ComfyUI-ReaVideoBreakdown 是 ComfyUI 自訂節點,會先切出鏡頭,再逐段判斷內容、拍攝方式與運鏡,並整理成可供影片模型使用的提示詞。
它把影片幀包裝成 video batch 交給原生 VLM,模型看到的是連續動作,而非一張張靜態圖片。每段最多抽取 8 幀分析,幀數可調至 32;畫面預先縮至最長邊 512,以控制顯存需求。
節點名為「Video Breakdown (Rea · native VLM)」,要透過 CLIPLoader 載入支援影片的 vision-language text encoder。可選類型包括 qwen_image、joyimage、ovis、gemma/ltxv、qwen3vl 及 minimax;普通 SD1.5 或 SDXL CLIP 看不到圖片,節點會發出警告。
| 輸入 (Input) | 預設值 (Default) | 說明 (Meaning) |
images | — | 以 IMAGE 批次形式輸入的每一影格(例如 LoadVideo → GetVideoComponents、VHS 等) |
fps | 25.0 | 批次影格率(0 = 預設為 25) |
clip | — | 視覺語言模型(VLM)文字編碼器(CLIPLoader),而非一般的 SD1.5 CLIP |
sensitivity | 0.5 | 轉場偵測靈敏度 —— 數值越高會偵測到越多鏡頭(Shot) |
min_shot_seconds | 0.24 | 短於此秒數的鏡頭將會合併至相鄰的鏡頭中 |
frames_per_shot | 8 | 每個鏡頭取樣的影格數,並作為影片批次輸入給 VLM(範圍 1–32) |
max_length | 1024 | VLM 針對每個鏡頭生成的最大 token 數量 |
temperature | 0.4 | VLM 取樣溫度 —— 數值越低,生成的 JSON 格式越穩定可靠 |
seed | 0 | VLM 隨機種子(Seed) |
language | en | en / zh 報告與提示詞語言 |
max_side | 512 | 在送入 VLM 之前,將影格最長邊縮小至此解析度(用以限制 VRAM 使用量) |
這套方法把「看見甚麼」與「量到甚麼」分開處理。內容、燈光、色彩及拍攝類型由 VLM 判讀;pan 速度、zoom 變化與 handheld/smooth 分類,則由 OpenCV 的 optical flow 計算,再以 RANSAC similarity fit 配對相鄰畫面。
設計也針對容易混為一談的部分:靜態描述可以交給模型推斷,但鏡頭移動不必靠猜。切點偵測結合 HSV histogram 距離與 pixel diff,再以自適應門檻找出 cut、fade、dissolve 和 flash,避免把所有變化都誤當成切鏡。
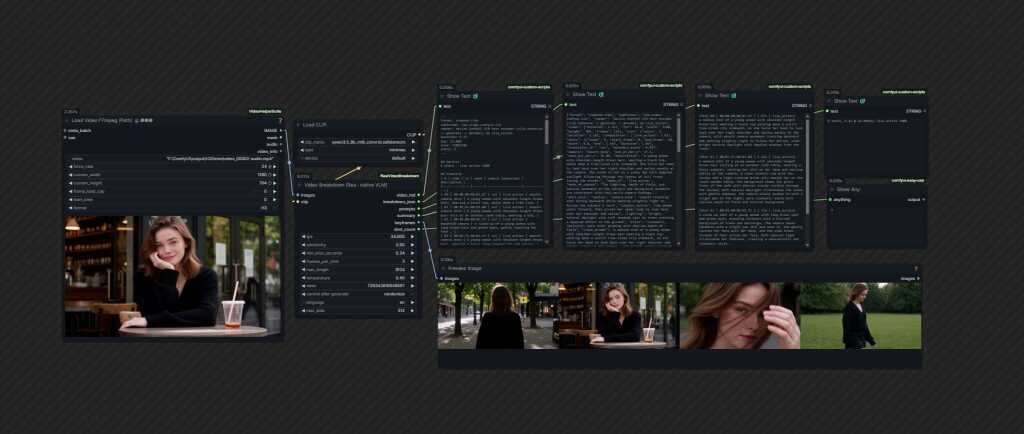
同一套分析會輸出 VIDEO.md 格式報告、結構化 JSON、逐鏡提示詞、摘要與首幀預覽。prompts 可直接接上 Wan、Kling、Veo 或 Sora 類節點;每段提示詞附鏡頭編號、時間碼、製作品類及長度,方便按原次序重新剪接。
實際操作需要 ComfyUI、Python 3.10 以上,以及原生已有的 torch;額外 Python 套件只有 numpy 與 opencv-python-headless。影片可由 LoadVideo、GetVideoComponents 或 VHS 變成 IMAGE batch,再連同 fps 與 VLM 接到節點。項目文件未提供硬體型號或顯存要求,只建議以 max_side 512、frames_per_shot 8 控制成本,細節镜头可試 768 或 1024。
輸出也有明確限制。模型描述與提示詞品質取決於所載 VLM,節點本身不會補足模型看不到的細節;它只處理視覺,沒有音訊或 BPM 分析、OCR、字幕輸出,極端慢速 dissolve 亦可能漏判,需要調整 sensitivity。
離線測試可用合成三鏡影片模擬 VLM 的 tokenize/generate/decode 介面,檢查鏡頭偵測、JSON 有效性及提示詞能否使用;每次 push 都會在 CI 執行,但這並不等同於真實影片的模型品質評測。