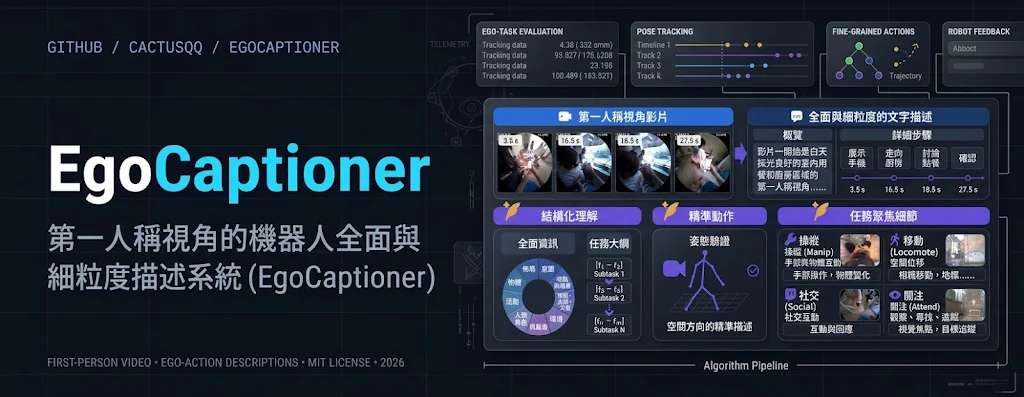
EgoCaptioner 是一套第一身影片描述模型,將場景總覽與帶時間標記的活動步驟配成一份字幕,涵蓋手部操作、移動、社交互動和視線注意。它以 Qwen3.5-9B 為基礎,由 KlingAI Research、北京大學等團隊參與開發。
在五個第一身影片基準測試中,EgoCaptioner 的 EgoMe-Steps METEOR 為 12.26;同表最佳開源模型 Qwen3.8-27B 為 7.24。這項比較反映步驟描述的文字重合度,不等於每段影片都能準確還原事件。其他指標也有落差:EgoMe-Overview 的 CIDEr 是 0.65,低於同表 EgoThinker 的 4.85,顯示總覽描述並非所有面向都領先。
你可按任務選擇完整描述、只產生影片總覽,或搜尋指定活動並列出步驟。指定活動時,event_steps 必須同時提供 event;活動重複出現,可在簡短英文描述中補上前後情境,並以「I」代表佩戴相機的人。單段影片推理會把結果印在終端,也可另存文字檔;批次模式則以 JSONL 一行一項任務,影片路徑相對於該檔案,處理完成後逐項寫入結果。
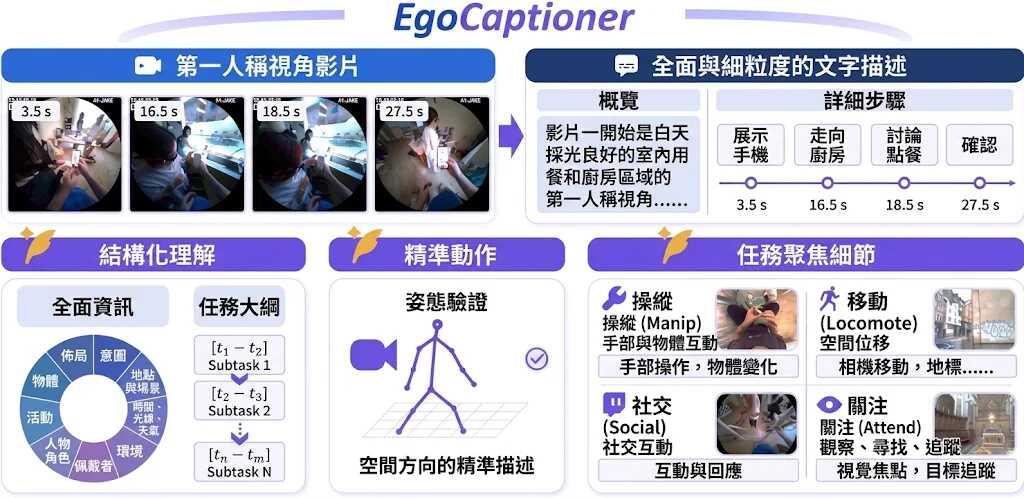
這套模型的優勢不只在輸出格式,也可用在訓練資料如何被建立。因此你可先整理事件結構,再逐步補上時間標記和細節,從八個第一身影片來源製作 50,000 個訓練例子;這種由粗到細的標註,目的是避免一次寫完整段影片時漏掉短暫動作或弄亂次序。有感測資料的影片還會加入由人體姿態推得的動作事實,為描述提供另一個核對依據。
生成後的描述亦會透過強化學習調整。Group Relative Policy Optimization(GRPO)是一種以多項獎勵引導模型修訂輸出的訓練方法;EgoCaptioner 用事實準確度、內容涵蓋度和步驟時間對齊作評分,並扣減零碎或重複敘述。消融實驗支持事實獎勵與時間獎勵各自補足對方,也顯示由粗到細的標註比一次完成的標註提供更有效監督;項目文件沒有列出這些消融的具體分數。
EgoTempo 的準確率為 38.40,低於 GPT-6-Astra 的 52.60;但在 Minerva-Ego 的 caption-to-QA 測試中,EgoCaptioner 得分 18.57,高於同表最高對手 EgoThinker 的 15.71。PhysCapBench 的 Overall 得分為 78.84,也高於 Gemini 3.1 Pro 的 75.06,惟仍低於 GPT-6-Astra 的 84.87。這些結果說明它在特定字幕與問答評估上有優勢,不能概括成全面勝過商用模型。
部署門檻主要在硬件和執行環境:需要 Linux x86-64、支援 BF16 的 NVIDIA Ampere、Ada 或 Hopper GPU,以及兼容 CUDA 12.8 的 driver。單段影片流程還要 CUDA toolkit、nvcc 和 C++ compiler;批次處理則另用 vLLM。若 TorchCodec 找不到 FFmpeg 的共享程式庫,需在執行推理的同一個 shell 設定程式庫搜尋路徑;更換模型或輸入檔時,亦要改用新的輸出路徑。
研究團隊把這套模型定位在第一身影片的細粒度描述,較直接的使用情境是整理佩戴相機的操作紀錄、活動片段或逐步字幕,再由人核對關鍵時間和動作。它對未有感測資料的影片,少了姿態推得的動作事實作輔助;指定活動若描述含糊或影片中多次出現,也需要加入上下文才能選中目標片段。