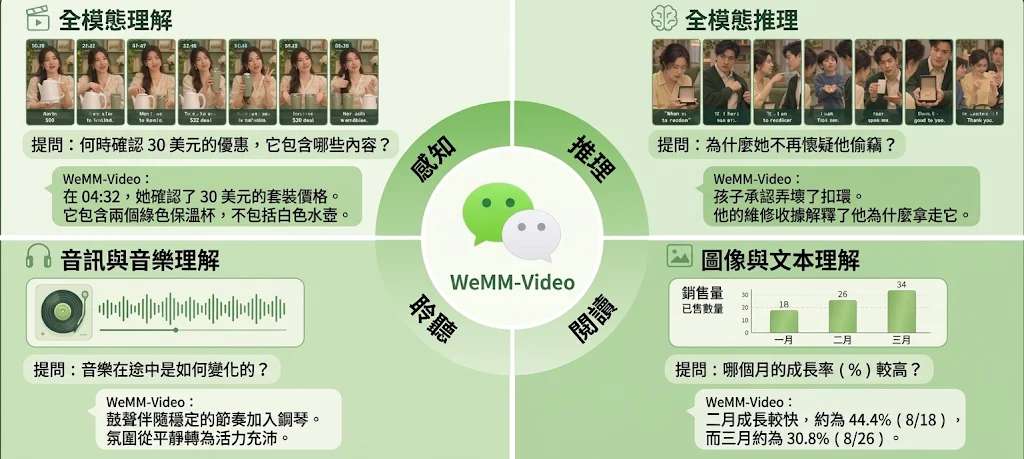
同一段影片,畫面和聲音可能各自藏着不同的意思。WeMM-Video 是 WeChat Vision at Tencent 開發的中英雙語多模態模型系列,可讀取文字、圖片、音訊和影片,再以文字作答;分析影片時,它把原始音軌和畫面一併輸入。它提供 2B、4B、9B dense models,以及 35B-A3B mixture-of-experts model,適合從單一媒體辨識延伸至視聽推理的工作。
測試影片理解時,使用者可比較只輸入畫面與同時輸入畫面、音軌的回答,檢查語音資訊會否改變對場景的判斷。項目文件的 Transformers 範例以 2B BF16 checkpoint 生成最多 128 個 tokens;影片取樣設為 1.0 fps,最多抽取 16 幀。這些是範例設定,不代表不同片長或硬件下的速度、準確度保證。
使用 Instruct mode 可取得快速直接的回答;需要明確多步推理時,則改用 Thinking mode。這個分工讓簡單描述不必每次都採用較長的推理流程。模型以約 1.2 trillion multimodal tokens 訓練,經過 progressive pre-training 和 multi-stage post-training;項目文件稱 35B-A3B 在 omni-modal video understanding 上勝過 Qwen3.5-Omni-Flash 和 Seed2.0-Mini-0428,並縮窄與 Gemini-3.0-Flash 的差距。
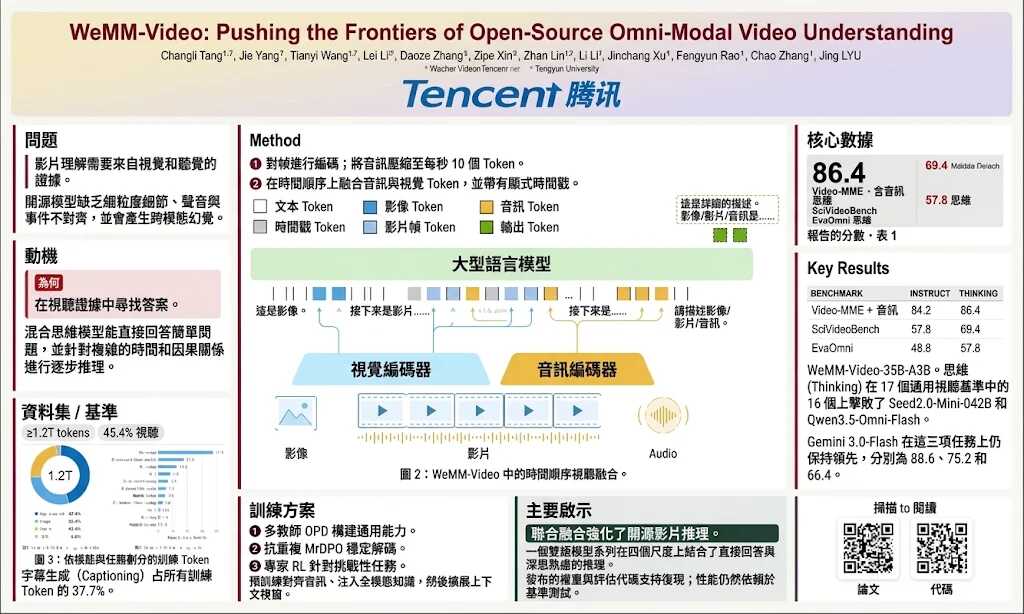
影片畫格、時間資訊、音訊與文字會一同送入模型處理,因此它可以回答畫面內容,也能把對白納入場景理解;另有 35B-A3B 和 9B 兩款在 general audio understanding 上取得領先表現的說法。
我們需要用 Transformers 載入 BF16 模型,或以 patched vLLM、patched SGLang 提供服務。兩個服務後端都可透過 POST /v1/chat/completions 接收 video_url,並以 video_url.use_audio 決定是否納入原始音軌;模型清單另有 FP8 Block128、AWQ W4A16 和 NVFP4 W4A16,Patched vLLM 支援這些格式。GGUF Q4_K_M 則要透過 Native runtime 執行,文件列出 CPU 或 CUDA 路徑。
測試需要 Python 3.12、NVIDIA GPU、相容 CUDA 12.9 的 driver、FFmpeg,以及 TorchCodec 所需的 shared libraries;Transformers 範例還會下載模型 checkpoint。服務端可按文件指定的 vLLM 0.18.0 CUDA 12.9 或 SGLang 0.5.16 CUDA 12.9 環境啟動,兩者的 context length 範例均為 8192。團隊若先做小規模驗證,可從 2B checkpoint 和內附文字、圖片、音訊、影片例子開始,再按部署後端選擇模型格式。
輸入上限也會影響測試設計:在已設定的 context length 內,每個 request 最多接收 4 張圖片、2 條影片和 2 個音訊項目。長影片若超出抽幀設定,模型看到的只是抽樣畫面;而文件未提供各量化檔案大小和硬件資源需求,現階段難以只靠型號判定部署成本。處理大量片段或要逐幀核對事件的團隊,應先以自己的影片長度、音軌和併發量測試,再決定模型規模與服務方式。