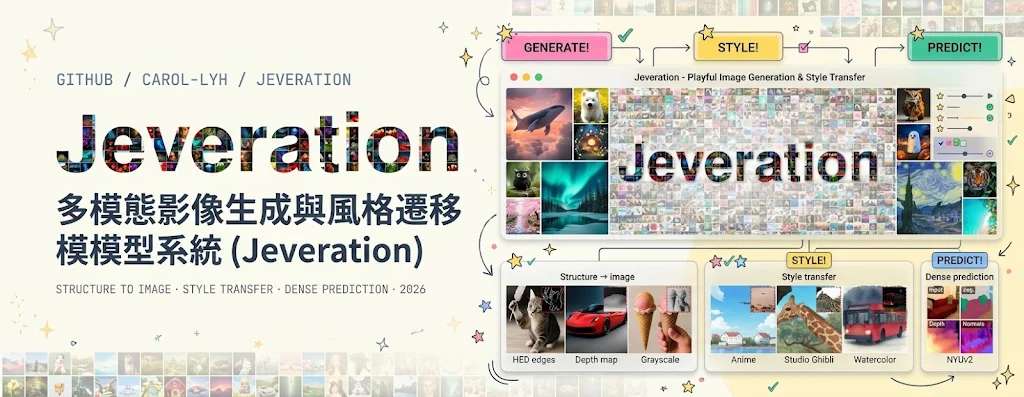
Jeveration 是建基於凍結視覺語言模型的影像生成模型,同一份 checkpoint(模型權重)兼顧文字生圖、改圖及逐像素分析。在單張 NVIDIA H200、batch 1 並計入 decoding 的測試中,生成一張 512 × 512 圖像需 77.8 ms,是所列比較模型中最快。這個數字反映指定硬件上的單張延遲,不能直接當成一般顯示卡或多人服務的速度。
Jeveration 的速度分別為 Janus-Pro-1B 的 98 倍、Janus-Pro-7B 的 122 倍。各模型在同一張 H200 上計時,但使用各自公布的 sampler、步數及解像度,因此比較包含生成流程的差異。Jeveration 的 GenEval 為 0.74;這項指標檢查圖像是否符合文字要求,但輸入資料未列出完整品質排名,不能據此判定它的畫質最佳。
速度來自生成次序的改變:Autoregressive models 逐個 token 生成,diffusion models 則反覆去噪。Jeveration 在一次 forward pass,也就是模型處理一次輸入的過程中,並行選出整張圖的 128 個 codes,這些是代表影像內容的離散編碼。同一段描述可以畫成不同構圖,各位置獨立選擇便可能拼出互不相容的區域。模型因此為每張圖抽取一個 random state,讓所有位置共用同一份隨機條件,協調整體構圖。
只拿目標圖像來訓練,模型卻傾向忽略這份隨機條件。研究人員先讓模型填補被遮蔽的影像編碼,學習各部分如何互相依賴,再由這個第一階段模型判斷生成樣本,引導第二階段的整體選擇。這個安排處理的是「並行選擇能否一致」,而不只是把原有生成步驟刪短。第一階段模型只在訓練時參與,正式生成仍維持一次 forward pass,沒有把判斷程序加回每次請求。
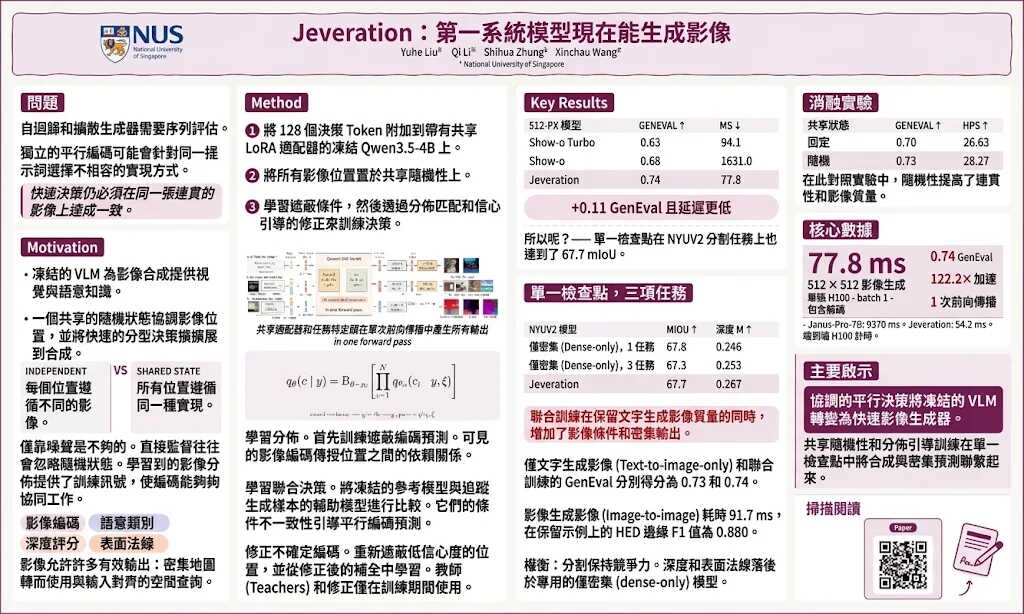
支撐各項任務的是凍結的 Qwen3.5-4B,主模型參數保持不變,再透過共享 LoRA adapters 學習任務所需的調整。不同輸出部分會把模型的決策轉成影像編碼,或逐像素的場景資訊。對需要同時試做生圖、改圖和影像分析的團隊,共用權重可讓原型集中在同一條 pipeline;不過,文字生圖與改圖仍分別使用不同 decoder,把編碼還原成圖像,整套系統並非只有一個權重檔。
改圖時,使用者可提供白線黑底的 edge map,或亮處代表近距離的 depth map,再加文字描述生成影像;亦可先由相片計算這些結構圖。項目另支援灰階相片上色,以及 anime、ghibli、watercolor 風格轉換,讓試作流程涵蓋結構控制與外觀修改。逐像素分析則輸出類別、以米為單位的深度,以及表面朝向,但訓練資料來自 NYUv2 室內場景。道路、戶外景觀等輸入超出這個訓練範圍,不能把室內結果直接當成那些場景的可靠度證據。
本機執行需要 Python 3.12、CUDA GPU,以及 requirements.txt 列出的依賴,下載至 weights 的項目檔案共 6.5 GB。首次執行還會從 Hugging Face Hub 下載 Qwen3.5-4B、TA-TiTok tokenizer 和 CLIP 的 text tower,因此這個容量並不代表全部準備工作。想先檢視效果,可安裝 Gradio 後透過 app.py 開啟瀏覽器示範,三類任務都有範例;整合程式則可使用 JeverationPipeline。項目文件未交代最低顯示記憶體需求、release 節奏或 issue 活躍度,部署前仍要在目標機器驗證。