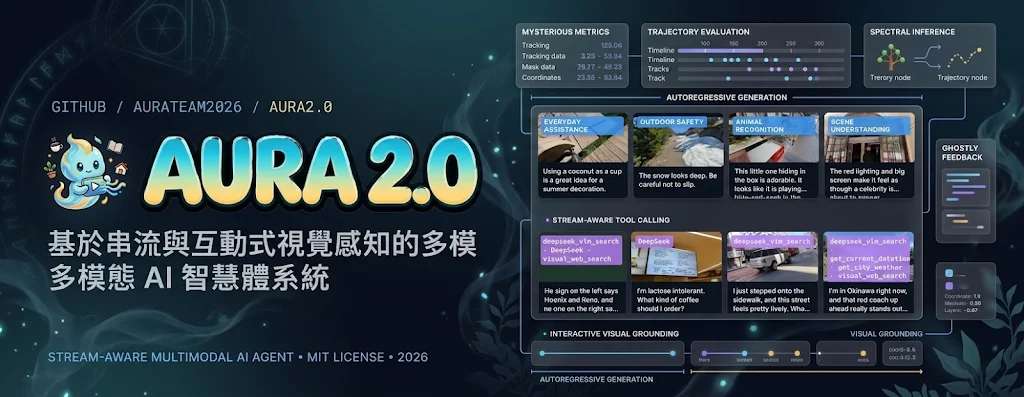
鏡頭一直開着,模型不必等人提問才回應。AURA 2.0 是一套即時視訊對話模型與示範工具,能結合連續畫面和對話記錄,判斷是否開口、何時回答,再以串流語音回應。它也能選用工具,並把回答連到畫面中的具體物件。
在 ProactiveVideoQA 四個數據集的平均分(ω = 0.5)中,AURA 2.0 (9B) 得 50.75,高於 MOSS-VL-Realtime (11B) 的 47.18;同一評測中,JoyAI-VL-Interaction (8B) 得 36.95。這個差距反映模型不只要答對,還要判斷何時介入;但分數只代表該基準的設定,不能直接當成日常對話品質保證。
瀏覽器示範把互動放在視訊通話流程內:使用者按住 Hold to talk 說話,放開後送出,也可打字或在畫面上畫記號。收到第一個視訊封包後才可輸入文字問題。模型用 Stream-Aware Tool Calling 按需求選工具和參數,取得執行結果後再作答;Interactive Visual Grounding 則把回答連回特定畫面物件,減少「你說的是哪一個」的含糊。
PhoStream 的 Overall 總分中,AURA 2.0 得 65.69,MOSS-VL-Realtime 得 43.88,JoyAI-VL-Interaction 得 33.40;VideoLLM-Online 得 12.34,MMDuet2 得 4.96。這些結果來自技術報告所列評測,不是同一套綜合分數:IPIBench、StreamArena 和 ProactiveVideoQA 各按指定方式平均,PhoStream 則採用報告的 Overall。研究訓練時亦特別處理沉默與回應標記數量不平衡,對兩類標記使用 focal loss,其餘受監督 token 使用交叉熵,目的是避免模型只因常見標記較多而偏向沉默或回應。
要試用示範,需在 Linux x86_64 伺服器部署;開發環境為 Ubuntu 22.04,安裝環境使用 Python 3.12、固定版本的 vLLM 0.33 wheel,以及隨附的 vLLM-Omni。項目文件驗證的是兩張 80 GB 加速器:一張跑 AURA,另一張共用作語音辨識和語音生成;依賴和模型權重至少要預留 50 GB 磁碟空間。啟動後可在本機瀏覽器開啟 gateway,手提電腦可經 SSH tunnel 連線;亦提供 Docker 部署方式,但沒有預建的公開映像。
硬件門檻是單卡配置需約 70 GB 可用記憶體。兩卡配置預設為 AURA 預留約 90%,語音辨識和生成共用的另一張卡預留約 38%;單卡配置預留 88%。即使改用 AURA 2.0 BF8,記憶體預留比例也不會自動下降,因此不能只看量化權重便假設能放進較細的硬件。