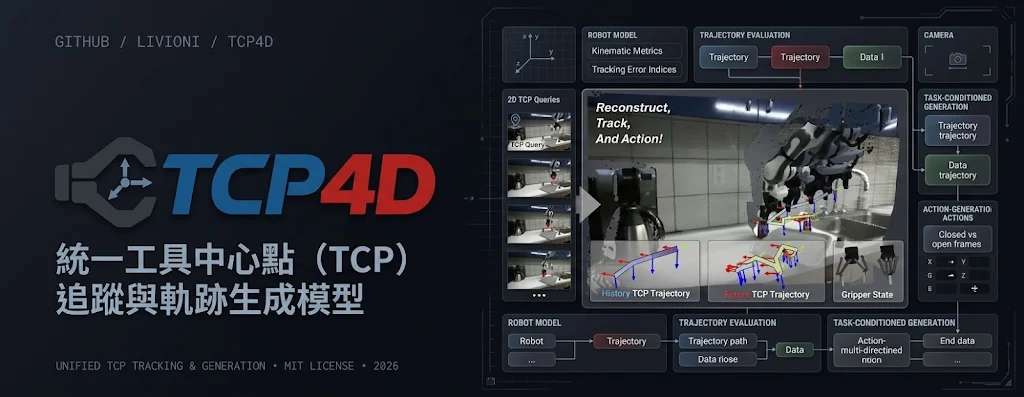
這是一個名為 TCP4D(全稱:A Unified Tool-Center-Point Tracking and Generation Model for Robot Manipulation)的機器人操作(Robot Manipulation)與電腦視覺研究專案主頁,由香港科技大學、北京理工大學、新加坡國立大學等機構的研究團隊於 2026 年發表。
TCP4D 把動作追蹤與未來軌跡生成放進同一個模型,處理機械人如何從觀看示範走到執行操作。它圍繞工具中心點(TCP)工作,即機械臂末端用來定位操作的位置,例如夾爪抓取物件時的參考點。
該專案提出了一個統一的 4D 場景表徵模型,將工具中心點(TCP, Tool-Center-Point)的追蹤與未來動作軌跡的生成整合在一起,讓機器人能從純 RGB 影片中理解物理空間運動並學會執行操作任務。
Generator 再沿恢復的軌跡抽取特徵,結合機械人當前觀察與語言指令,生成未來 TCP 軌跡。兩個模組分工明確:前者整理看見的運動,後者利用這些資訊推算接下來怎樣移動。對機械人研究團隊而言,測試時也應分開核對兩步,避免把追蹤準確直接當成操作成功。
另一條實用路線是跨機械人資料擴增:系統重新定位恢復的動作,再合成目標機械人的觀察畫面。團隊可以把已有影片轉製成另一款機械人的訓練材料,減少每次換硬件都重新收集示範的需求。不過,合成資料是否足夠,仍要看它與原始示範如何搭配,不能只憑畫面合理就判斷訓練有效。
ARX-X5 實驗比較只用擴增示範,以及混合原始與擴增示範,直接檢驗兩種資料組合的差別。只用擴增示範的平均成功率為 30.5%,混合後為 72.0%,相差 41.5 個百分點。這支持保留原始示範的做法,但這組比較未能單獨證明,加入擴增資料比只用原始示範改善多少。
把模型放進工作流程前,可以先按以下次序核對需求:
- 先試追蹤:在介面選取 TCP,再用
infer_stage1.py執行推理,核對影片中的末端運動。 - 再看生成:觀察預測軌跡是否符合當前畫面及語言要求,別只看視覺呈現是否流暢。
- 保留原始示範:跨機械人資料擴增需要和資料組合一起測試,不能預設合成材料足以獨立訓練。
- 測試環境變化:除了原本條件,也要檢查改變環境後的動作,因為文件已列明相關退化。
- 核對整合輸入:部署端除了影片,還需要腕部影像、機械人狀態及語言指令。
部署範例以 WebSocket server 接收 RGB 觀察歷史、初始 TCP 位置、當前腕部影像、機械人狀態與指令,回傳 32-step 雙臂 TCP 軌跡及夾爪狀態。Generator 只以 clean RoboTwin demonstrations 訓練,項目文件明確承認環境隨機化會令表現下降。