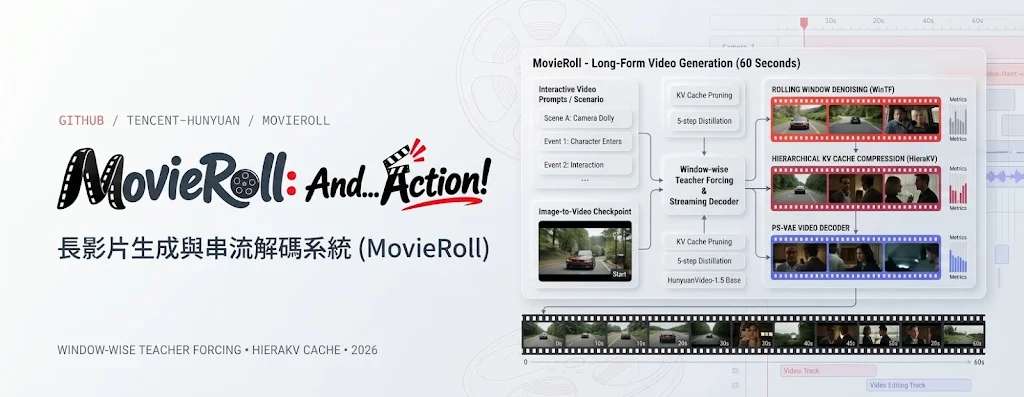
通常影片越長,角色走樣越明顯。MovieRoll 是一套長影片生成框架,針對的正是生成持續到後段後容易褪色、變形及失去劇情連貫的問題,並同時提供 Base 與 Distilled 兩條模型路徑。
- 兩種模型定位:MovieRoll-Base 偏重品質與可控性,MovieRoll-Distilled 以更少步數加快生成。
- 支援 T2V 與 I2V:可由文字生成影片,也可從圖片出發,另可使用有序 event prompt 序列加入多個事件。
- 降低長片退化:joint window denoising、hierarchical KV caching 與 cache recomputation 共同支援持續生成。
- 更快版本:MovieRoll-Distilled 的 denoising steps 為 5,Base 則需要 50 步並使用 AnnealCFG。
- 評測覆蓋較長時長:HeliosBench 測試 10、30、60 秒單事件影片,以及 30 秒/3 events、60 秒/6 events 多事件影片。
MovieRoll-Base 以 window-wise teacher forcing 訓練,讓模型在較長生成期內逐步維持前後關係。進入推論階段後,它結合 joint window denoising、hierarchical KV caching 和 cache recomputation,針對持續滾動生成時容易累積的品質損耗逐段處理。AnnealCFG 會逐步降低 guidance,讓結果靠近 clean endpoint。
Distilled 版本則走另一條路。ODE initialization 配合 cumulative long tuning(CuLT-DMD)製成 MovieRoll-Distilled,把原本 50 個 denoising steps 壓至 5 個,而且不再使用 CFG(Classifier-Free Guidance)。這個取捨很直接:想要較快試不同 prompt、鏡頭與事件安排,Distilled 較合適;團隊若要優先研究 Base 模型的控制方法,便有另一條路可走。兩者均提供 text-to-video(T2V)及 image-to-video(I2V)checkpoint。
長影片通常會描述多過一個事件。MovieRoll 可用單一 prompt,也可按次序輸入多個 event prompt,讓同一場景繼續發展,同時引入新動作。HeliosBench 的多事件評測正針對這項能力:30 秒版本包含 3 個 events,60 秒版本包含 6 個,single-event 與 multi-event 分別使用 200 及 100 個 prompts。
評測結果由 MovieRoll-Distilled 取得各個已報告設定中的最高 total score,評分涵蓋視覺品質、動態、平滑度、語意對齊、自然度,以及隨時間累積的 drift。
另有 59 名專業人士參與 paired study,對同一 prompt 產生的影片選擇偏好影片或 tie,每對影片至少由 3 名專家評估。項目文件同時提供 5 個相同 prompt 與目標時長的比較案例,並列出 Base 與 Distilled 版本,讓團隊可以觀察蒸餾前後的取捨,而不只依賴單一總分。
安裝與模型下載需要 Python 3.12、支援 CUDA 的 PyTorch,以及已安裝的 FlashAttention kernels。FlashAttention-3 要從 flash-attention 的 hopper/ 目錄建置,並需要 Hopper(sm90)GPU,例如 H100;開始長時間生成前,應先確認 kernel build 支援所用 GPU。
模型權重在 Hugging Face 的 yunyangge/MovieRoll,下载前需要接受存取條件並完成認證。單一 checkpoint 仍須配備 HunyuanVideo-1.5 的 VAE、Qwen2.5-VL-7B-Instruct、byt5-small 與 Glyph-SDXL-v2。這些不是可省略的提示詞工具,而是完整推論管線的共用元件。
硬體門檻是 MovieRoll 目前的明顯限制。Quick Start 的單 GPU 設定要求整條 pipeline 能放入 GPU,文件列出的 96 GB GPU 可容納整條管線;8 GPU 設定則採用分散式與序列平行。--sp-size 必須同時整除 GPU 數及模型的 16 個 attention heads,8 GPU 範例使用 --sp-size 8 與 --shard-world 8。單程序推論不使用 FSDP(Fully Sharded Data Parallel)。
原生 inference entry point 尚未支援 CPU offload,RTX 4090、RTX 5090 等 consumer GPU 亦列於 TODO。Gradio、串流播放與 inference efficiency 改善仍未完成,因此這套模型現階段較適合具備大型 GPU 環境的影片研究與製作團隊,而非一般消費級電腦。