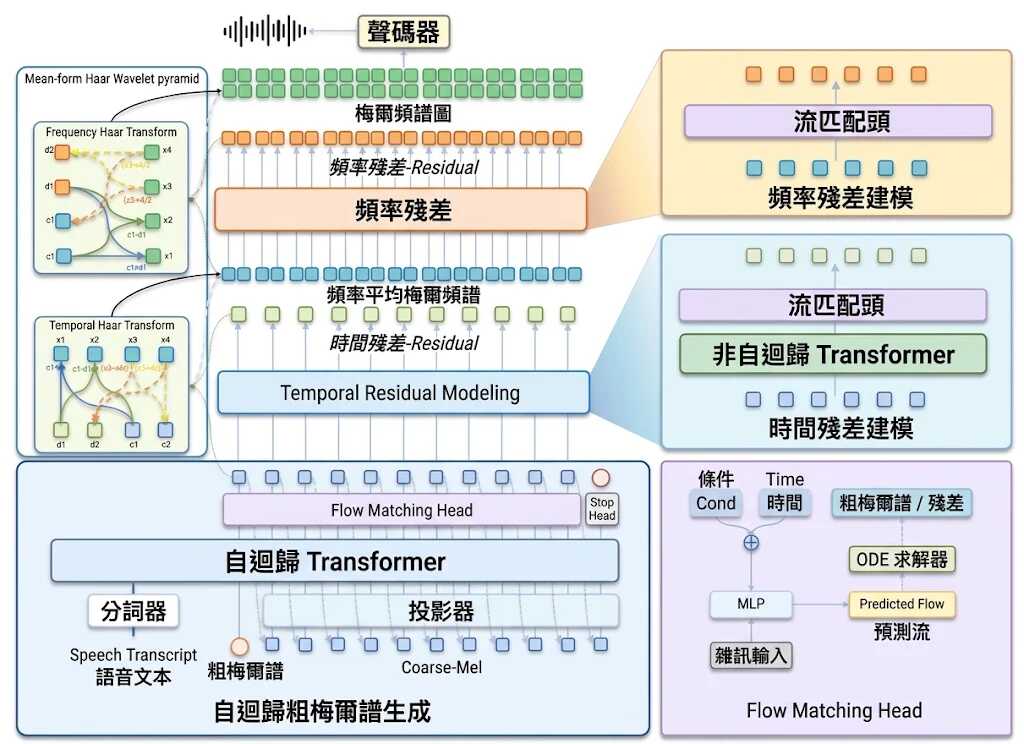
VoxMel 是一種無需聲學分詞器的連續自回歸文本轉語音(TTS)框架,通過固定且精確可逆的雙軸 Haar 變換直接建模梅爾頻譜。語言模型骨幹與流匹配預測頭以自回歸方式生成 Coarse-Mel,兩個非自回歸殘差層依次恢復時間和頻率細節,且不會將這些殘差反饋至自回歸歷史。獨立的 Vocos 聲碼器將重建的梅爾頻譜轉換為語音。
✨ 主要亮點
– 直接建模梅爾頻譜 — 無需學習聲學分詞器或壓縮聲學潛空間;文本前端使用 Qwen2.5 分詞器。
精確可逆分解 — 沿頻率和時間軸的 Haar 分解保留全部梅爾系數。精確可逆指變換本身,並不保證生成音頻或聲碼器重建無損。
僅對粗粒度分量自回歸 — 先生成 Coarse-Mel,再按依賴順序生成時間殘差和頻率殘差;殘差細節不進入自回歸歷史。
中英文零樣本聲音克隆 — 使用參考音頻及其轉錄文本合成語音,論文配置輸出 24 kHz 音頻。
後訓練 — 凍結預測頭的 GRPO 改善了全部四項 Seed-TTS 指標。
直接生成 mel-spectrogram,不需 learned acoustic tokenizer。
固定雙軸 Haar transform 保留全部 mel coefficients。
提供 VoxMel-0.6B 與 VoxMel-0.3B 兩個模型。
VoxMel 使用 10 萬小時 Emilia 數據訓練,並在英語和中文零樣本聲音克隆任務上評測。0.6B 監督模型在 Seed-TTS-eval test-en 上達到 1.51% WER / 0.738 SIM;凍結預測頭的 GRPO 將結果提升至 1.15% WER / 0.753 SIM。對比結果和評測協議見評測。
VoxMel 的核心不是把梅爾頻譜再壓縮,而是重新安排資料的生成次序。系統先以 decoder-only transformer 和 flow-matching head 逐步產生 Coarse-Mel,再按 dependency order 預測 temporal residual 與 frequency residual。兩層 residual 均以 non-autoregressive 方式處理,而且不會回饋到 Coarse-Mel 的 autoregressive history。
VoxMel 把高維連續語音的難題集中在高階結構,而不是先學習一套壓縮 acoustic representation。Haar transform 可逆,代表頻率與 temporal splits 沒有自行丟失 mel coefficients,但這個保證不延伸到生成音訊或 Vocos reconstruction。換言之,數學上的可逆分解,但並不等於輸出音訊可以無損重建。
在 24 kHz 設定下使用 100-channel log-mels、1024-point FFT/window 與 256-sample hop。完整 mel 的 frame rate 是 93.75 Hz,Coarse-Mel 則降至 46.875 Hz。模型以 Emilia 的 100K hours 訓練,最後由凍結的 24 kHz Vocos vocoder 把重建的 mel-spectrogram 轉成波形。
英語結果是這套方法最突出的部分。VoxMel-0.6B 在 Seed-TTS-eval test-en 錄得 1.51% WER 和 0.738 SIM,數字低於 CosyVoice 的 3.39%、CosyVoice 2 的 2.57%、Qwen3-TTS 的 1.66%及 DiTAR 的 1.69%。加入 frozen-head GRPO post-training 後,結果改善至 1.15% WER 和 0.753 SIM。
安裝需要 Python 3.10–3.12,並按硬件選擇相容的 PyTorch 與 torchaudio 版本。原始環境採用 torch/torchaudio 2.4.1 和 CUDA 12.1,程式碼以 editable package 方式安裝,requirements.txt 會共用套件安裝設定。CPU 與 Apple Silicon 需要使用相應的 PyTorch build;device="auto" 會依次選擇 CUDA、MPS、CPU,但 MPS 的 operator support 與 performance 仍要按 checkpoint 驗證。
執行推理前,要準備 config.yaml、model_L_final.pt,以及指定 Vocos 目錄內的 config.yaml 和 pytorch_model.bin。VoxMel-0.6B 與 0.3B 可從 Hugging Face 取得,但只有 0.6B 做過 frozen-head GRPO,0.3B 並沒有相同的后訓練流程。
Python API 以 model.generate() 合成語音,能獨立調整 text guidance、speaker guidance、residual solver steps、duration bounds 與 random seed,並回傳 mono float32 NumPy waveform。CLI 可輸出 WAV;Web Demo 提供播放、下載與本地示例,預設採用 32 個 coarse 和 residual solver steps,Text CFG 與 Speaker CFG 分別為 3.5 和 3.0,隨機 seed 固定為 42。