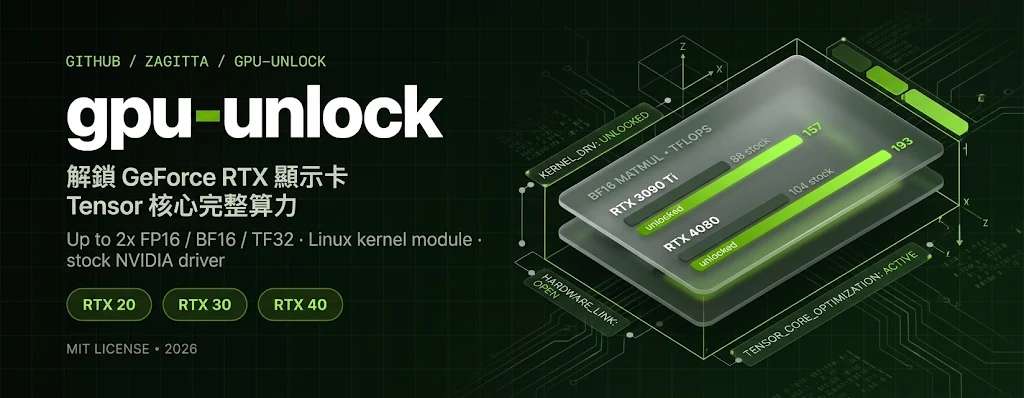
運算上限解開,模型也未必快一倍。gpu-unlock 是 Linux kernel module,即在系統核心運作的模組,會在開機時、原裝 NVIDIA driver 載入前解除部分運算速度限制。它改動的是顯示卡運算能力的可用範圍,模型本身毋須更換。
GeForce 的 Tensor Cores 運算單元在特定精度組合下受半速限制。涉及 FP16(16-bit Floating Point)、BF16(Brain Floating Point 16)及 TF32(TensorFloat-32),並以 FP32(32-bit Floating Point)累加結果;簡單理解,就是以較低精度計算,再用較高精度累積答案。同晶片的 RTX A-series 或專業卡則以全速運行,而解除限制毋須修改 NVIDIA driver 或刷寫顯示卡韌體,文件亦稱更新 driver 後毋須重做。
先看自己的工作內容,再決定是否測試,會比單看「解鎖」更有意義。項目列出的收益分布相當不平均,以下數字均屬項目提供的典型加速幅度:
- Large Language Model(LLM)讀取提示內容的階段,加速 +25–55%;這與之後逐字生成答案是不同工序。
- BF16 的 Low-Rank Adaptation(LoRA)及完整微調,加速 +25–50%;兩者分別更新少量附加參數和模型整體參數。
- FP16/BF16 圖像生成,加速 +30–55%,較貼近需要反覆產圖的工作流程。
- LLM 逐字生成答案,以及遊戲,均標示為 No change,不能把運算吞吐量當成整體體驗的增幅。
這些幅度來自使用者提交的相容性報告,並非每套模型與硬件都會重現。項目稱解鎖前後輸出逐位元一致,但測試時仍應固定模型、輸入及設定,分開量度提示處理和答案生成時間。顧問替客戶估算效益時,也應按實際工序計時,不能把某個階段的加速直接套在整個服務上。
功率是另一道限制,即使運算單元可以跑得更快,也未必有足夠供電空間。RTX 4090 在原裝功率限制下處理大型矩陣乘法,增幅遠低於峰值速率所示。工作中相關精度的矩陣運算比例愈低,解鎖能影響的部分也愈少;評估批量訓練或生成工作時,應量度整項任務的完成時間。
硬件支援亦有成熟度之分:Ampere(RTX 30)標示為 Stable,已有 100+ 份使用者報告。Ada Lovelace(RTX 40)與 Turing(RTX 20)仍屬 Experimental,Blackwell(RTX 50)則不受支援。挑選測試機時,不能只看卡名屬於 GeForce;先核對支援型號及狀態,才能判斷是在驗證收益,還是在試驗相容性。
部署前要有 Linux、受支援顯示卡,以及修改核心開機參數的條件。安裝完成後,仍須透過 gpu_unlock.targets 明確啟用,可選全部支援卡,或指定個別卡的完整硬件地址;未啟用時模組不會解鎖。解鎖也必須趕在 driver 綁定顯示卡之前,已被 driver 接管或已斷電的卡會被跳過,因此它不是開機後隨時切換的加速按鈕。
手提電腦的難題是獨立顯示卡可能在閒置時完全斷電,令解鎖狀態重設。關閉相關動態電源管理只對部分型號有幫助,不能假設開機測試成功後便一直有效。準備採用的團隊應先在目標機器完成一次工作測試,再讓機器閒置後重測,核對日常電源行為會否令收益消失。