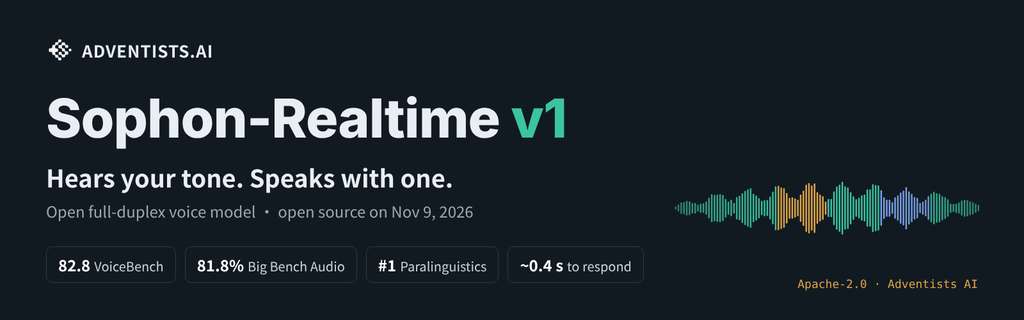
Sophon-Realtime v1 是一套開放的全雙工語音模型系列,處理的核心不只是「聽懂字句」,還包括判斷對方是否仍在說話、語氣帶來了甚麼訊息,以及何時該插話或讓出話輪。
模型共有 Tag、Flash 與 E2E 三個版本,共享同一個 32B 大腦;分別之處在於文字回覆如何轉成聲音。Tag 由表現力較強的語音模型演出笑聲、嘆氣、呼吸等標記,Flash 以約 3.5 億參數的輕量語音模型加快輸出,E2E 則直接生成連續聲音向量。
這套設計的特別之處,在於語氣理解與說話方式各自有專責模型:DuplexJev 負責判斷語音決策,底層 32B 模型則理解內容、決定回覆及生成文字。相較只依賴文字提示控制語氣的做法,它能從停頓、強調、諷刺、笑聲和嘆氣中抽取副語言訊號。
- VoiceBench 得分 82.8,Big Bench Audio 得分 81.8,在開放全雙工模型中居首
- 副語言理解取得 48.6 分,高於 Gemini 3.8 Flash 的 46.9 與 Qwen3-Omni 的 44.6
- 首次語音輸出約需 0.25 秒,Flash 版本約 0.31 秒
- Full-Duplex-Bench v3 工具呼叫 Pass@1 為 48%,回應率達 100%
- 支援中英文,以及意大利文、德文、西班牙文、法文和葡萄牙文
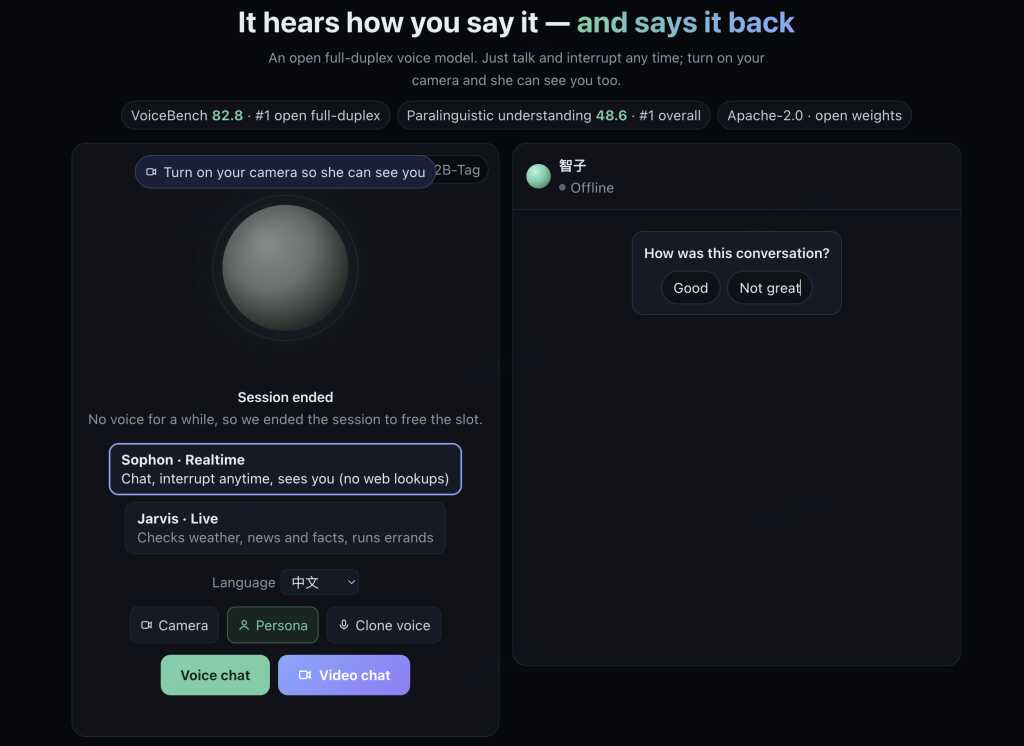
測試可透過 Hugging Face、ModelScope 或線上示範進行,另設有 OpenAI GPT-Live 相容格式的託管 API;項目文件亦提供模型下載與快速開始指引。對需要自然對話的陪伴角色、客服、車載語音介面及角色原型團隊而言,較易體現價值;Live 模式亦可把對話交由較大的後端模型處理工作。
取捨同樣清楚:模型規模與運算需求不會因「即時」而消失,語氣生成效果也取決於所選版本及演出模型。雖然每段回覆附有可查核的文字紀錄,但官方數據仍以指定評測基準為主,跨語言口音、複雜噪音與真實電話線質下的表現,仍需用實際場景驗證。