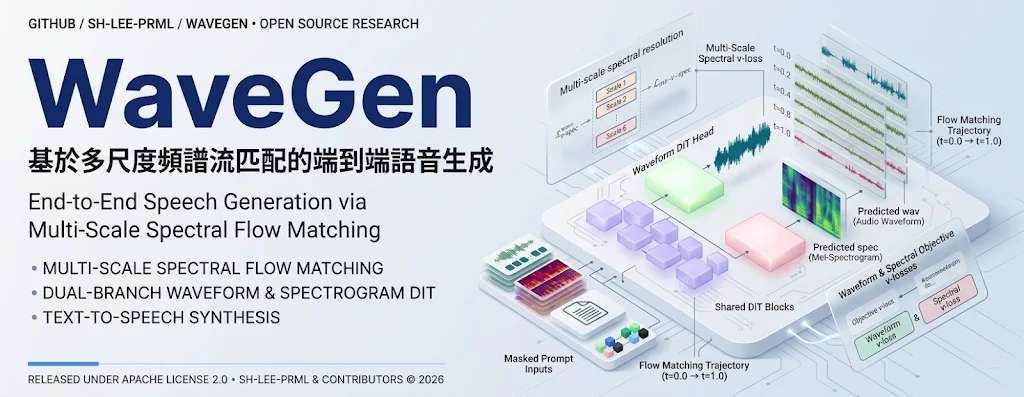
WaveGen 是文字轉語音模型,直接把文字轉成語音波形,省去外置 codec 或 vocoder。這令生成路徑更直接,但也把聲音品質和生成能力更多交由同一模型處理;目前公布的訓練資料是 Emilia,音訊為 24 kHz。
研究團隊稱,WaveGen 在以 Emilia 訓練的 TTS 模型中達到最先進表現,但提供的項目資訊沒有列出具體指標或比較數值,因此難以判斷它在不同語言、聲線或實際產品情境中的差距。項目亦公開程式碼和模型權重,適合研究人員及語音團隊檢視端到端生成方法,或在自己的 GPU 環境測試;亦可先透過 Hugging Face Space 示範試聽。
模型以內部頻譜軌跡學習處理語音生成。建議用於推理的 WaveGen V-Spec 附有 EMA(Exponential Moving Average)權重;WaveGen-Flash 則由 V-Spec 蒸餾而來,只需四步生成語音。這個版本減少生成步數,但項目文件尚未交代蒸餾細節,亦未提供速度與音質的量化取捨。
- 部署測試:可用 Hugging Face 示範試聽,或按項目提供的 Python 程式、模型權重自行執行推理及評估。
- 模型選擇:一般推理可先試 V-Spec;需要較少生成步數時,可測試四步版 Flash。
- 已知範圍:公開訓練資料為 Emilia,音訊規格是 24 kHz,不能據此推定其他資料或語言同樣適用。
對想研究端到端文字轉語音、並能自行準備推理環境的團隊,WaveGen 提供了可測試的模型與程式碼;若要評估商用部署,仍需自行核對目標語言的音質、推理成本及授權安排。