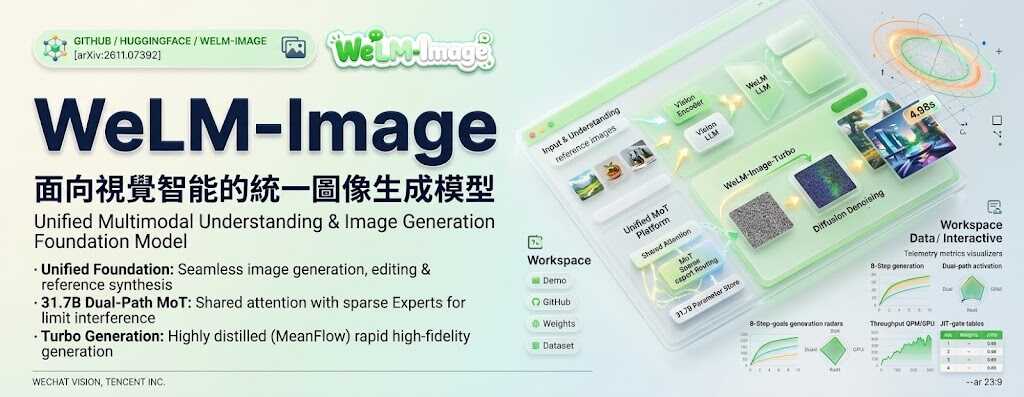
創作時要由文字描述生成圖片、再修改姿勢或移除路人,甚至合併幾張參考圖,WeLM-Image 都可用文字指令處理。這個騰訊 WeChat Vision 團隊推出的統一圖像模型,亦支援在圖片中加入或替換文字,面向 WeChat 的消費者應用設計,目標是在單張 GPU 上部署。
常見做法會把圖像理解與生成分成不同模型或參數路徑,處理多種任務時可能互相干擾。WeLM-Image 把文字、參考圖像與目標圖像的潛在表示交錯放進同一序列,再以 Mixture-of-Transformers(MoT)共用注意力、分開理解與生成參數,並用 Mixture-of-Experts(MoE)提供稀疏運算容量。
訓練資料涵蓋雙語標註與經核實的編輯範例,並逐步訓練至原生 1.5K 解像度。團隊分別針對生成與編輯使用評分規準及檢查清單設計獎勵,再以感知雜訊的 on-policy distillation 整合兩條路徑。
報告指出,1,536 解像度版本在 PRISM-Bench、Qwen-Image-Bench 及 UnicBench 的受測開源模型中排名第一。加速版本 WeLM-Image-Turbo 則以 MeanFlow 蒸餾,在單張 NVIDIA H20 GPU 上用八步生成 1024 × 1024 圖像,耗時 4.98 秒。
- 同一模型涵蓋文字生圖、指令編輯與多參考圖合成。
- 可處理姿勢調整、風格轉換、物件增刪及畫面文字修改。
- MoT 分開理解與生成參數,MoE 提供稀疏模型容量。