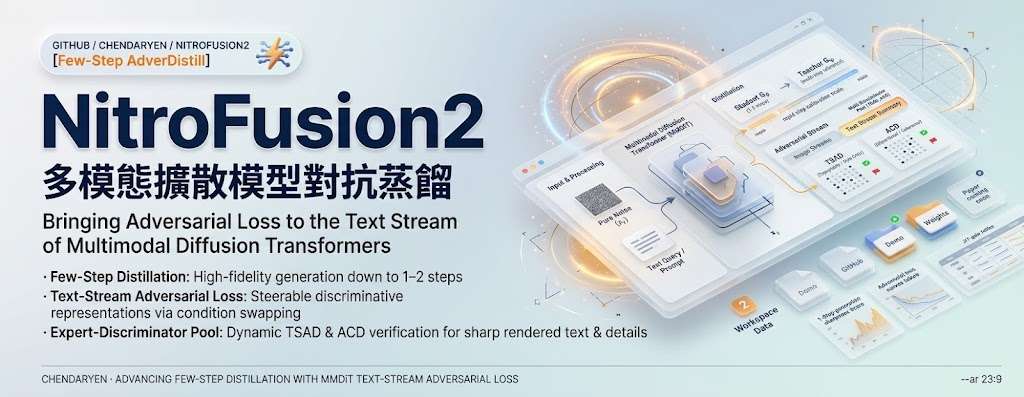
需要快速出圖,又不想犧牲圖片中的文字與細節,NitroFusion2 以一至兩步生成作出回應。這個文字轉圖片模型建基於 Z-Image-Turbo,將對抗損失加入多模態擴散 Transformer(Multimodal Diffusion Transformer,MMDiT)的文字串流,讓模型在一步生成時也能呈現銳利文字和細節。
它的做法不只依賴圖片特徵判斷生成結果。MMDiT 的文字 token 經過共同注意力層後已讀取圖片資訊,因此 NitroFusion2 也利用文字串流中的中間狀態進行對抗式蒸餾;訓練方法還會按物件、文字排版或動作等提示,調整判別器關注的內容。這讓單一步生成兼顧速度和細節,但兩步流程仍可能出現瑕疵。
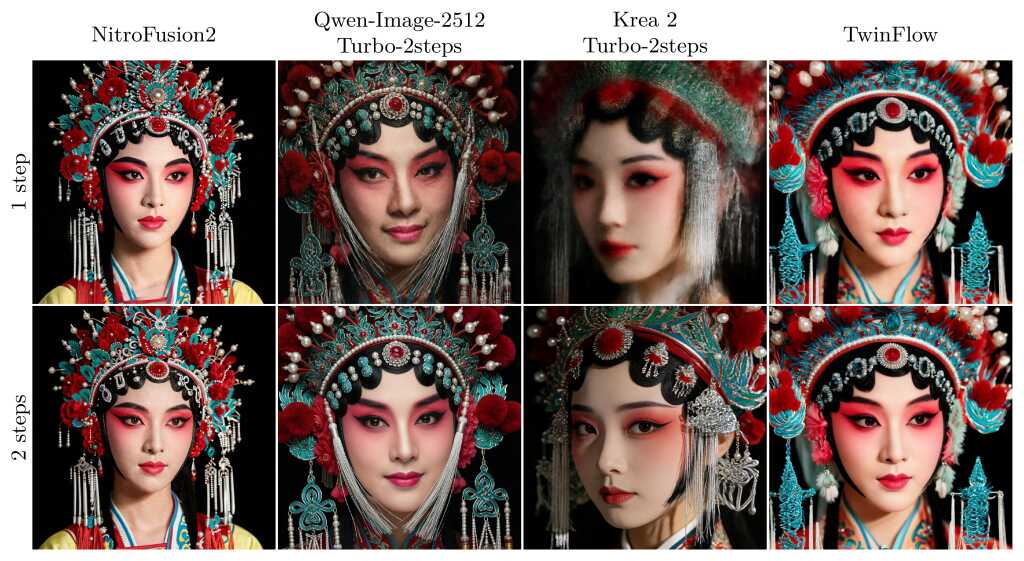
ComfyUI 使用者可直接載入項目提供的一步或兩步 workflow;兩步流程建議先以 0.5 強度套用 de-distillation LoRA,將 NitroFusion2 拉回 Z-Image-Turbo,再於第二步單獨執行 NitroFusion2,以減少部分瑕疵。項目亦提供 Diffusers 推理程式和 GGUF 權重,量化版本由 2.0 GB 至 7.2 GB,方便按可用儲存空間選擇;文件未列出不同版本的品質或速度測試數據。
- 一步生成,主打清晰文字與細節。
- 兩步流程可配合 de-distillation LoRA 減少部分瑕疵。
- 提供 ComfyUI workflow、Diffusers 程式及線上示範。
- GGUF 權重有多種大小,適合需要量化模型的使用者。
對需要快速製作含文字圖片的設計者,或想在本地工作流程試用少步數生成的開發者,NitroFusion2 提供了直接測試的模型與 workflow。若重視兩步生成的穩定度,應按建議加入 LoRA;生成速度與畫質仍需以依賴提示詞和硬件作驗證。