整理分鏡時,參考圖、描述和生成提示詞往往分散在不同步驟;ComfyUI-ShotWorkspace 把這些創作工作放進 ComfyUI 畫布,讓創作者準備素材、修訂鏡頭描述,再撰寫 H3 影片提示詞。這是個實驗階段的自訂節點,負責生成前的整理與寫作,不取代影片生成工作流程。
創作者可分別上載角色、道具和場景圖片,使用影像分析產生可編輯描述,再挑選當前鏡頭的參考圖並按次序送往接收工作流程。文字生成和圖片分析透過 API 連接 LLM 伺服器呼叫;影片模型權重、取樣及解碼則由原有工作流程處理,兩者需要分開安裝和測試。
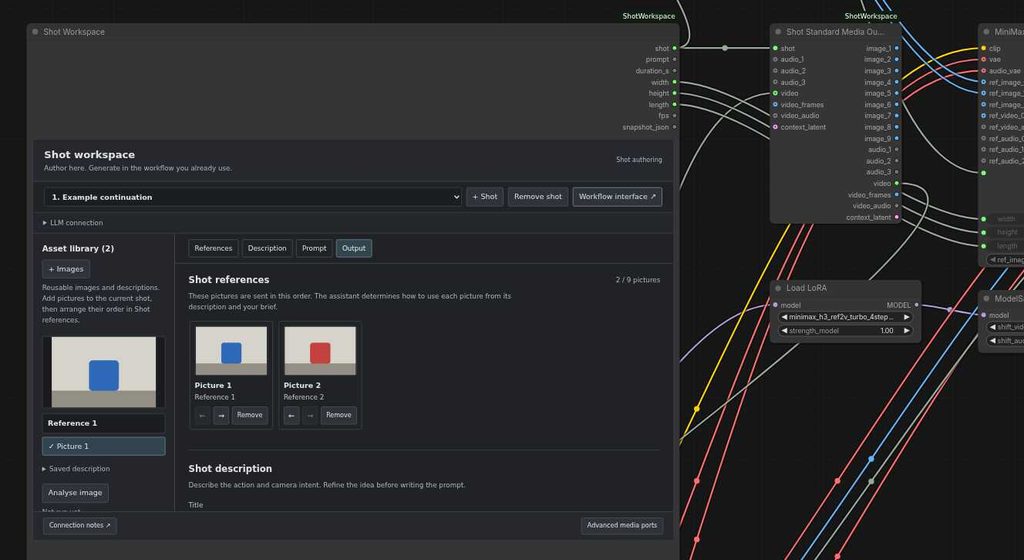
每次佇列只處理一個鏡頭,項目不負責編排完整影片序列。前一鏡頭的輸出不會自動成為下一鏡頭的輸入,使用者須自行選擇前置鏡頭;工作流程之間傳遞的 LATENT 格式亦必須相容。音訊、影片和 LATENT 接口可傳遞媒體,但不會自動把這些內容加入大型語言模型提示詞。
- 需要 ComfyUI、Python 3.10 或以上版本,以及符合要求的 aiohttp 和 Pillow,依賴項須安裝到執行 ComfyUI 的 Python 環境。
- 項目不附帶模型權重;LLM 伺服器、接收工作流程所需節點及 H3 權重都要另行準備。
- H3 輸入影格按 24 fps 的 17k+5 網格安排;取樣時長在上下文裁切前設定,交付影片可能短於指定時長。
- 工作流程會保存創作資料、檔名和伺服器網址;圖片本身留在 ComfyUI 的輸入目錄,分享前宜檢查保存內容。
這套工具較適合已經使用 ComfyUI、希望把分鏡準備和提示詞撰寫納入既有流程的創作者或小型製作團隊。它減少素材與文字在工作流程間來回整理的需要,但不提供完整序列編排,也不能單靠 LLM 連線測試確認影片生成正常。