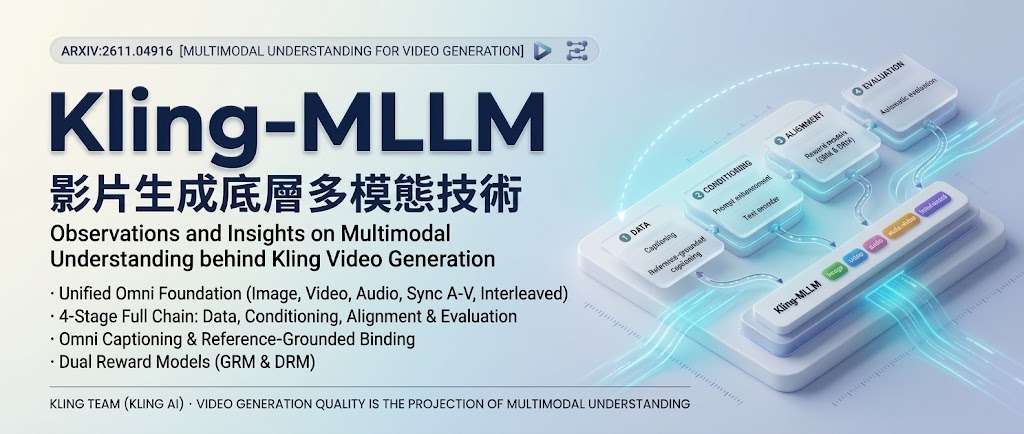
當影片生成要跟從複雜描述、維持人物與物件一致,單靠提升畫面品質並不足夠。Kling 團隊的技術報告聚焦多模態理解,分析資料、條件輸入、對齊和評估如何共同影響生成結果,適合關注可控影片生成的研究者與產品團隊參考。
研究以 Kling-MLLM 為共用基礎模型,處理圖片、影片、音訊、同步影音及交錯輸入,再按不同下游任務作專門調整。團隊指出,DiT 的訓練樣本遠少於語言模型,因此字幕不能只求流暢,而要作為高密度的語意契約;延伸出的 reference-grounded captioning,亦會明確標示描述與參考內容的對應關係。
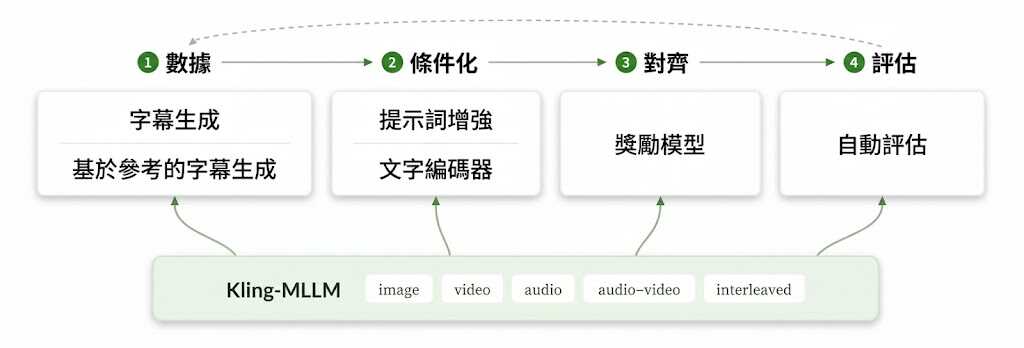
提示詞增強負責把使用者意圖轉成生成模型較能處理的描述分佈。基本方法由優質影片字幕整理而成,再配合文字層面的強化學習及生成器迴圈微調;agentic prompt enhancement 則會進一步整理故事,並檢索具參考價值的例子。報告亦指出,可靠的 text encoder 需要感知訓練,單純提升語言能力並不足夠。
報告涵蓋的技術重點包括:
– 以共享多模態模型支援不同輸入形式及下游模組。
– 用高密度字幕和明確參考綁定,補足訓練語意與素材之間的連結。
– 以可解釋、能定位問題的通用 reward model,配合快速多維評分的 decision reward model。
– 設計任務專用自動評估,揭露評分捷徑,並協助追查上游失誤。
這套思路適合用於影片生成系統的資料整理、提示處理、模型對齊和品質診斷;團隊也強調,感知能力、描述品質與評估協定需要一併設計。內容屬於 Kling 團隊對其多代系統經驗的整理;提供的資料亦未列出可供外部讀者直接重現的完整流程。