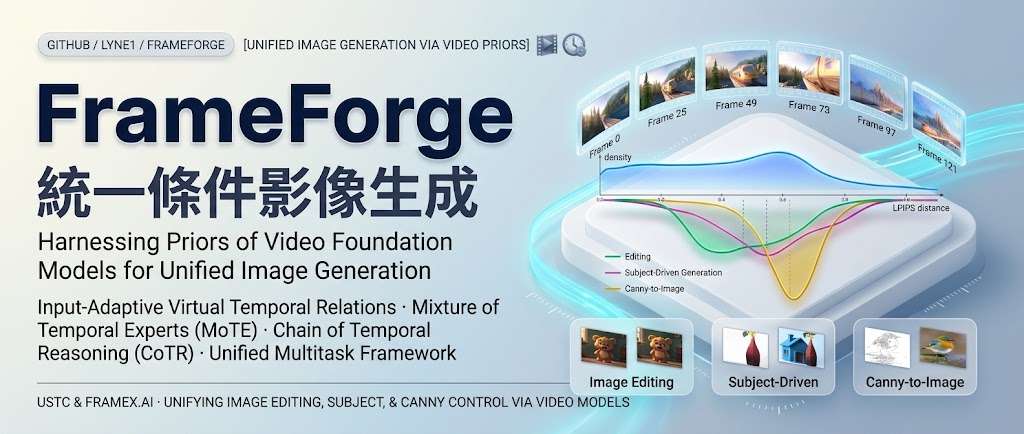
同一張參考圖可以用來保留主體、遵循 Canny 邊緣結構,或按照文字指令改變內容,但三種任務對「要保留多少、要改變多少」的要求並不相同。
FrameForge 是一個「給它一張參考圖,再用文字指示生成或修改圖片」的 AI 研究專案。它的特色是借用影片模型理解畫面變化的能力,來處理靜態圖片。
它用同一個模型處理三種工作:
| 功能 | 你提供什麼 | 可以做什麼 |
|---|---|---|
| 參考主體生成 | 一張人物、動物或物件的參考圖,加上文字描述 | 保留主體的辨識特徵,重新生成不同場景,例如把同一隻狗放到海灘上 |
| 邊緣圖轉圖片 | 一張 Canny 邊緣圖,也就是描出物件輪廓的線條圖,加上文字描述 | 依照既有輪廓、姿勢與構圖生成完整圖片 |
| 文字指令修圖 | 原始圖片,加上修改指令 | 改變動作、加入物件或轉換風格,例如「把貓的動作改成睡覺」,同時盡量保留其餘內容 |
這三種功能分別適合「保留是誰/是什麼」、「保留畫面結構」以及「修改指定內容」的需求;不是每次都從文字重新生一張毫無關聯的圖。
技術上有兩個重點:
– MoTE:動態選擇不同的虛擬時間間隔,對應不同程度的畫面變化。
– CoTR:加入一個潛在中間狀態,作為原圖轉換到目標圖的中間路徑。
官方已提供推論程式及模型下載方式,環境需要 Linux、Python 3.10 和支援 CUDA 的 GPU;公開流程以 512 × 512 輸入及輸出圖片、50 次去噪步驟運行,部分模型下載也需要先申請存取權。
注意「同一個模型整合三類圖片工作流程」,可作為評估自建圖像生成/編輯服務的 PoC 起點。官網目前提供的是研究結果與部署入口,不能直接視為已具備完整產品能力。