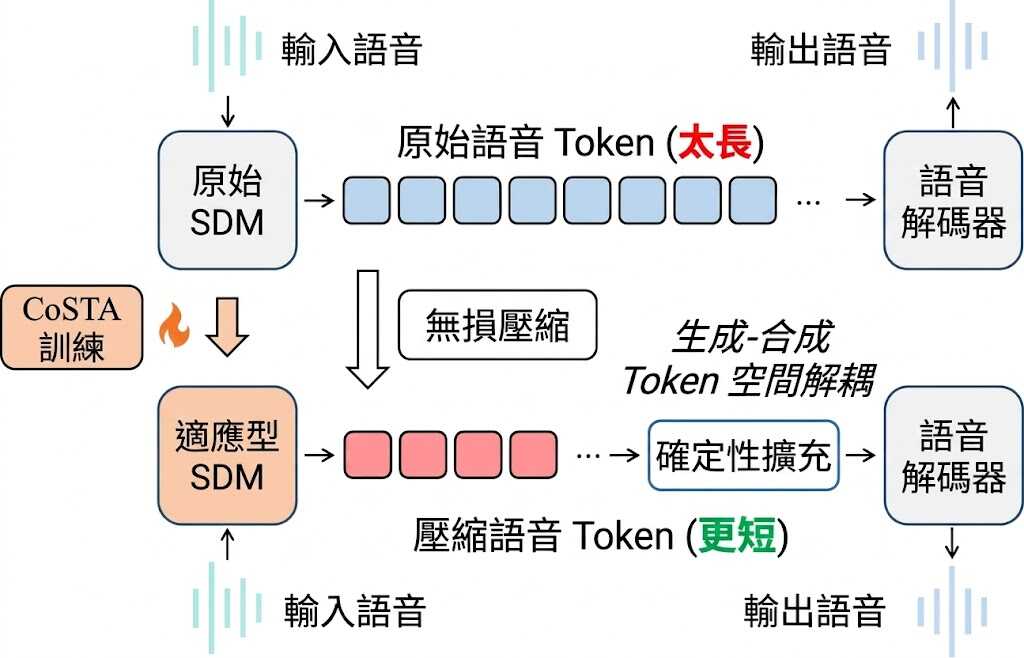
語音對話模型要逐個生成語音 token,序列較長時會拖慢回應。CoSTA 是一套語音模型適配方法,透過壓縮生成序列加快推理,同時保留原有語音 tokenizer 和 decoder,讓壓縮後的 token 可在合成波形前還原。
CoSTA 使用 byte-pair encoding(BPE)學習合併語音 token,並以原有 token 的 embedding 和 LM head 權重平均值初始化新增詞彙。適配分階段進行:先訓練發音,再調整語音對話輸出,讓模型生成交錯的文字與語音內容。它改變的是生成時使用的 token 空間,而非取代負責語音合成的原有元件。
在中英文基準結果中,CoSTA-ZH 的壓縮序列保留原 token 數量的 66.81%,擴展後語音 token 生成速度為每秒 101.99 個;CoSTA-EN 分別為 70.17% 和每秒 99.05 個。兩者相對 Step-Audio 2 mini 的速度為 173.63% 和 165.94%;這些結果反映特定基準測試,不能直接當成所有模型或硬件上的延遲保證。
對已有語音對話模型、希望提高回應速度而不重建語音合成流程的研究團隊,CoSTA 提供了一條可評估的適配路徑。GitHub 提供程式碼與論文連結,但模型權重及資料集仍標示為即將推出,現有資訊亦未列出完整安裝及測試流程。
- 壓縮自回歸生成用的語音 token 序列,再於合成前確定性還原。
- 保留原有語音 tokenizer 和 speech decoder。
- 中英文基準測試均報告高於 Step-Audio 2 mini 的生成速度。
- 權重與資料集尚未提供,現階段難以直接復現完整流程。