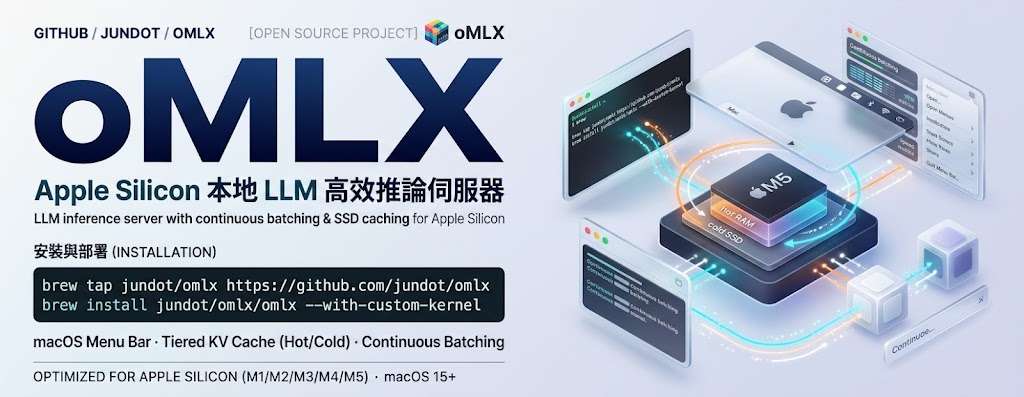
在 Mac 跑編程助手,oMLX 可讓常用模型常駐記憶體,並從選單列管理服務。能使用 Mac 原生 MLX 的吞吐與批次處理。
它以連續批次處理(Continuous batching)配合分層鍵值快取(Key-Value cache,KV cache):常用區塊留在記憶體,冷資料以 safetensors 格式存入固態硬碟(SSD)。後續請求的前綴吻合便可重用,伺服器重啟後亦能恢復,但不代表任意改寫上下文都能免除重算。
- 可設定上下文長度限制。
- 記憶體不足時,按最近最少使用(Least Recently Used,LRU)策略移出模型。
- 管理介面支援手動載入及卸載模型。
硬件需 Apple Silicon Mac,並為模型及快取預留記憶體與 SSD 空間;來源未列最低容量、模型清單或具體測速,不能據此保證大型模型的速度。
安裝可從 Releases 下載 .dmg,拖入 Applications,並支援程式內更新。需要反覆處理相同上下文的編程工作較能受惠;SSD 快取節省重算,卻不能取代模型推理所需的記憶體。