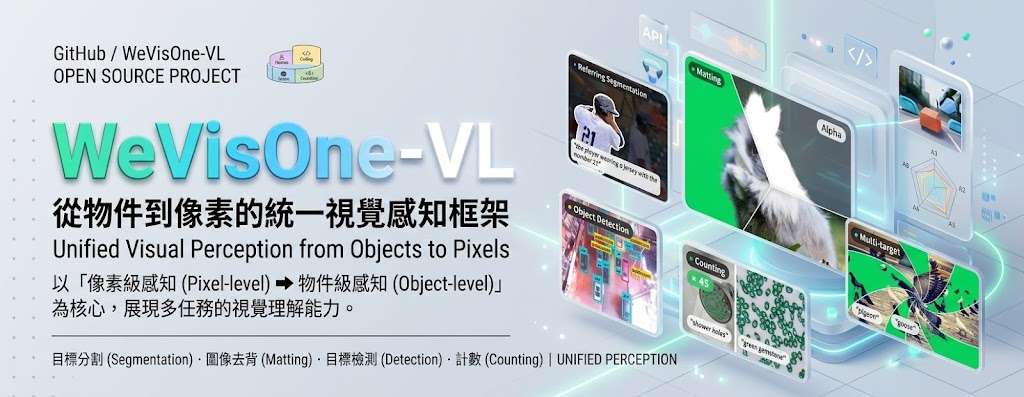
要在一張圖中找出物件、讀取文字,再按需要輸出座標、遮罩或透明度邊緣,WeVisOne-VL 把物件層級與像素層級工作整合為視覺語言模型(Vision-Language Model,VLM),適合標註及影像檢查流程。
模型建基於 Qwen3-VL,以 structured next-token prediction 生成定位結果:座標 token 表示點與框,
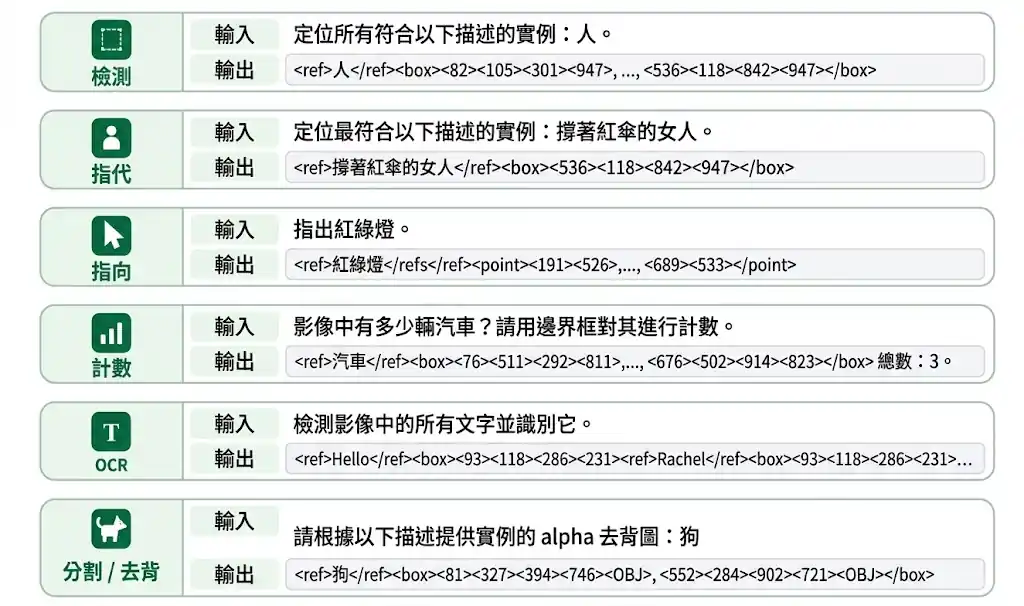
任務涵蓋物件偵測、指稱定位、計數、指點、光學字元辨識(Optical Character Recognition,OCR)、指稱分割及 promptable alpha matting;找不到指定目標時會回傳 None,減少虛構定位。需要在同一流程處理定位、分割與前景摳圖的團隊,可評估它是否適合自身資料和任務。
- 提供 2B、4B 模型權重、推理套件、Cookbooks、Gradio 示範及評測流程。
- 微調程式碼尚未提供;資料亦未列出硬件需求或逐步安裝方式。
- 項目在 30 多項基準測試領先。