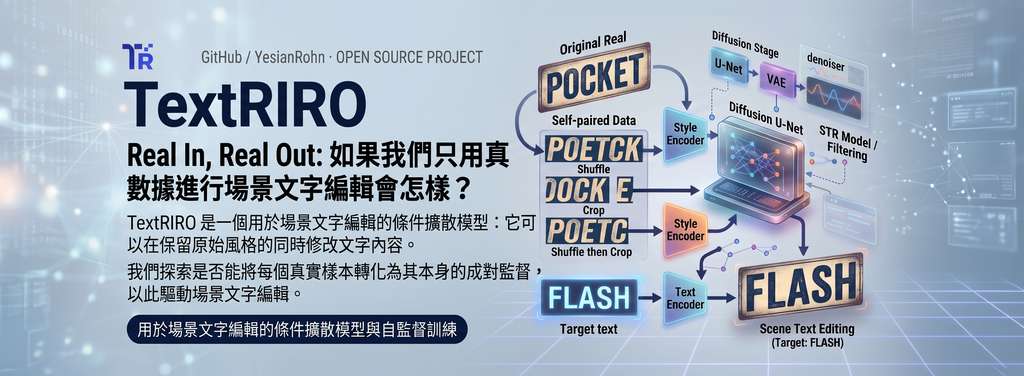
招牌或包裝上的字換了,仍希望保留原有外觀;TextRIRO 以條件擴散模型處理場景文字編輯(Scene Text Editing,STE),輸入裁切文字圖及替換內容,輸出改字後的圖像。
它以 Shuffle&Crop 打亂真實影像的文字語意,同時保留風格線索,讓每張圖形成自身的配對監督,毋須合成編輯前後配對或字元分割。多尺度風格編碼器配合以場景文字辨識(Scene Text Recognition,STR)預訓練的文字編碼器,分別提供外觀與字元條件。
「Real-only」只涵蓋編輯監督及文字編碼器預訓練。生成骨幹仍採用 Stable Diffusion(SD)1.5 的 U-Net 與 scheduler,以及 SD 2.1 的變分自編碼器(Variational Autoencoder,VAE)。
- 可透過 Hugging Face Demo 試改文字。
- 本地推理需 CUDA、模型權重及相關組件;儲存庫列出 Python 3.8/PyTorch 1.13 環境。
- 生成解像度為 64 × 256,再還原來源尺寸,細節仍受限制。
- RIROCommon 測試等長及變長改字;所附資訊未提供分數,不能判斷領先幅度。
文字辨識研究團隊亦可利用 TextRIRO-3M 的三百萬張長文字影像。這批資料由篩選後的編輯圖與原圖拼接而成,屬合成資料;完整照片改字流程,仍需另行處理文字區域裁切及回貼。