語音片段的資訊密度各有不同,若一律按固定長度切分,便難以按內容分配編碼資源。RubatoCodec 是神經語音編碼器,會把語音轉成帶有離散碼索引和持續時間的可變長事件,並支援逐段重建波形,適合需要控制碼率或串流輸出的語音系統。
它在 50 Hz 潛在表示上,參考多尺度潛在特徵差異和波形頻譜通量,累積分配事件;預設目標比例為 0.25,整段語音的事件數則按公式精確控制。這種做法毋須另設邊界預測器、邊界標籤或 rate loss,但仍需把事件持續時間一併納入編碼,不能只看碼索引的位元率。
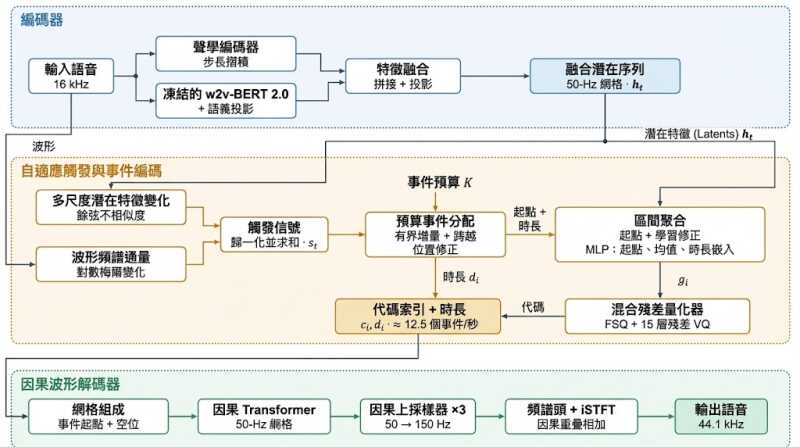
量化器採用 16 層混合式殘差結構:首層是接受語義監督的 FSQ,其後 15 層使用 DAC-style residual VQ。解碼時可選用 1 至 16 層的任意前綴深度,名義碼索引位元率約為 150 至 2,400 bit/s,另加持續時間資訊;模型以約每秒 12.5 個事件表示語音,輸入為 16 kHz,因果串流解碼器輸出 44.1 kHz。
每個事件代表約 80 毫秒音訊,在 H200 上解碼約需 11 毫秒,具備逐事件或分批解碼的條件。這是硬件與模型設定下的速度數據,不能直接當成其他設備上的延遲保證;現有資訊亦未提供足以比較音質取捨的具體評測結果。
研究人員、語音模型開發團隊,以及需要低碼率儲存或即時音訊處理的系統,可用公開模型和 Python API 載入語音、編碼,再按指定深度解碼。重點包括:
– 事件長度按語音訊號變化調整,整段事件數受目標比例控制。
– 支援逐事件或分批串流解碼。
– 可選不同量化器深度,在碼率與表示容量之間調整。
– 編碼資訊除離散碼索引外,亦包括事件持續時間。
– H200 上每事件約需 11 毫秒解碼,其他硬件表現未有提供。
基本使用範例(推論與重構流程)
專案通常遵循標準 PyTorch 神經編解碼介面,基本 Python 處理流程如下:
import torch
import torchaudio
from rubatocodec import RubatoCodec

# 1. 載入模型與權重
device = "cuda" if torch.cuda.is_available() else "cpu"
model = RubatoCodec.from_pretrained("third-intelligence/RubatoCodec").to(device)
model.eval()

# 2. 讀取並預處理音訊(重取樣至模型支援之採樣率)
waveform, sample_rate = torchaudio.load("input.wav")
if sample_rate != model.sample_rate:
    resampler = torchaudio.transforms.Resample(sample_rate, model.sample_rate)
    waveform = resampler(waveform)

waveform = waveform.unsqueeze(0).to(device)  # [Batch, Channels, Time]

# 3. 編碼:提取離散 Tokens (RVQ Codes)
with torch.no_grad():
    # tokens 形狀通常為 [Batch, Num_Quantizers, Frames]
    tokens = model.encode(waveform)

# 4. 解碼:由離散 Tokens 還原音訊波形
with torch.no_grad():
    reconstructed_waveform = model.decode(tokens)

# 5. 儲存重構音訊
torchaudio.save("reconstructed.wav", reconstructed_waveform.squeeze(0).cpu(), model.sample_rate)