統一多模態模型(Unified Multimodal Models, UMMs)一邊做圖像生成、一邊做語言理解,但訓練時從圖像吸收的知識,一直難以量化究竟有多少真的能在純文字 QA 場景派上用場。Knowledge Transfer Probing(KTP)這個項目正正填補這個缺口:它設計了一套受控的評測協議,先以圖像生成訓練把新知識餵進模型,再以純文字問答檢驗模型能否取出。
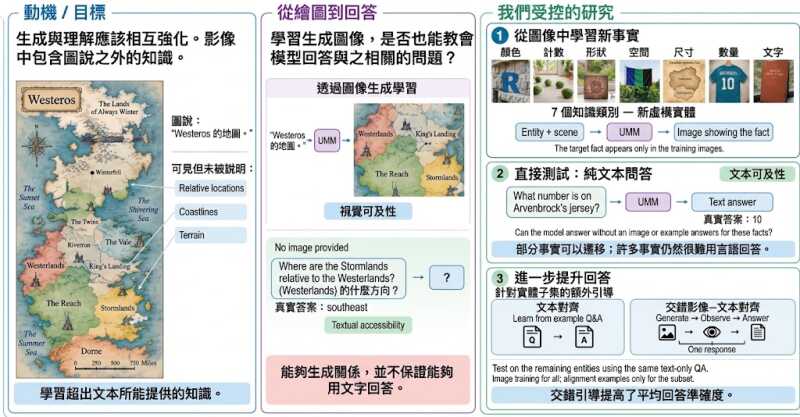
團隊跨越七個知識類別(色彩、數量、形狀、相對空間、相對大小等),在三個 UMM 上觀察到一個關鍵現象:直接從視覺監督遷移到語言的知識,效果並不均勻,部分類別知識存取明顯偏弱。有趣的是,在部分實體上做 Textual Alignment 或 Interleaved Image-Text Alignment 對齊訓練後,模型在未對齊的其餘實體上同樣能改善知識存取,其中交錯式對齊的平均準確率比純文字對齊更高。
項目屬於研究型資料集與評測框架,隨倉庫釋出 KTP-Data(分為 train/ 與 eval/),訓練檔涵蓋文字生成圖像、文字對齊及交錯圖文對齊三類樣本,評估檔則提供文字可達性(QA 題目與參考答案)與視覺可達性(生成提示與屬性)。評分腳本只用 Python 標準庫,跑分結果會輸出 results.jsonl 與 summary.json,方便研究者直接替換自家模型回應做比較。
對正在訓練或微調 UMM 嘅團隊而言,KTP 提供一個可重現的基準去量度「圖像生成帶來多少純文字世界可用的知識」,同時指出交錯對齊是一條有實證支持的改進路徑。多模態模型研究者、訓練數據設計者,以及關心視覺-語言聯合表徵架構的人都會從中受益。
這個項目的限制同樣需要留意:KTP 目前只覆蓋七類視覺屬性,且只測試三個 UMM,並未涵蓋複雜語境或多輪推理,結論的普遍性仍有待擴充樣本驗證。